
 اخبار
پشتیبانی سریعتر Assisted Generation بر روی Intel Gaudi در هوش مصنوعی
شرکت Intel و هابانا پردازنده Gaudi را برای سرعتپردازی Assisted Generation طراحی کرده و هزینه و مصرف انرژی را بهطور چشمگیری کاهش میدهد.
 پژوهش
هوش مصنوعی با Intel Gaudi 2: راهکار ارزانقیمت RAG در شرکتها
این مقاله نحوه ساخت برنامههای RAG هزینهبهصرفه با Intel Gaudi 2 و Xeon را بیان میکند، شامل استفاده از LangChain و پلتفرم Open Platform for Enterprise AI.
 پژوهش
هوش مصنوعی بر روی سرورهای Xeon: SetFit با سرعتشده توسط Intel
SetFit با بهرهگیری از Optimum Intel بر روی پردازندههای Xeon با سرعت بیسابقهای به قضاوتهای چند-خطی دست مییابد؛ مقاله این راهحل و روند بهینهسازی را بررسی میکند.
 مدلها
بهینهسازی مدلهای جاسازی هوش مصنوعی روی CPU با Optimum Intel و fastRAG
روش جدید بهینهسازی مدلهای جاسازی (Embedding) با ابزار Optimum Intel و fastRAG برای اجرای سریع و کمهزینه روی پردازنده مرکزی، بدون افت کیفیت.
 اخبار
آموزش استفاده از خط لوله متنسازی هوش مصنوعی روی شتابدهنده اینتل گائودی ۲
اجرای مدلهای Llama 2 روی شتابدهنده Intel Gaudi 2 با خط لوله جدید Hugging Face ساده شد. در این مقاله روش استفاده و مزایای آن را میخوانید.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.
 مدلها
بهینهسازی هوش مصنوعی Stable Diffusion برای CPUهای اینتل با NNCF و Optimum
بهینهسازی Stable Diffusion با NNCF و Optimum روی CPUهای اینتل، راهکاری نوین برای تولید تصویر با هوش مصنوعی بدون نیاز به GPU و با حفظ کیفیت است.
 سختافزار
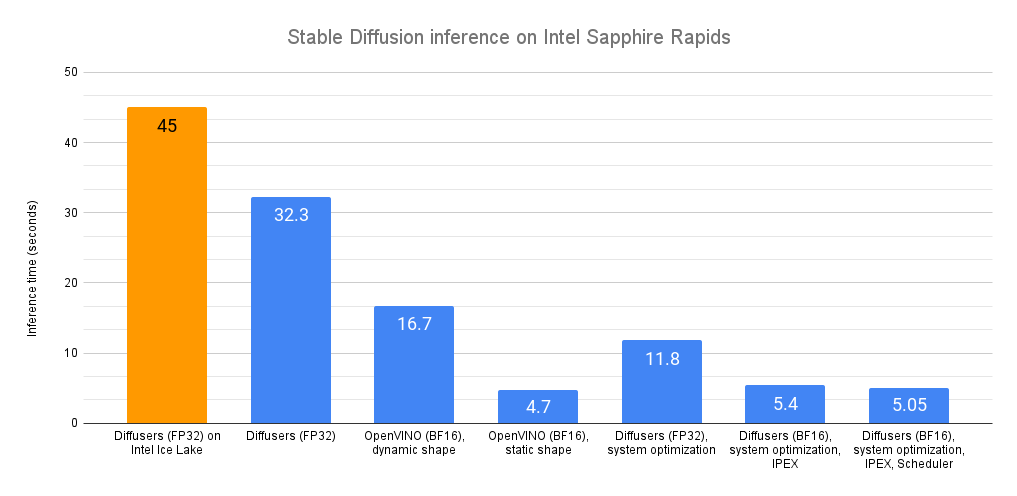
سرعتدادن Stable Diffusion بر CPUهای Intel: راهنمای هوش مصنوعی
با بهرهگیری از چهارتا تکنیک اصلی در پردازندههای Intel Sapphire Rapids، پیشبینی مدل Stable Diffusion را معنادار سرعتبخشید. راهنمای جامع برای توسعهدهندگان و محققان.
 سختافزار
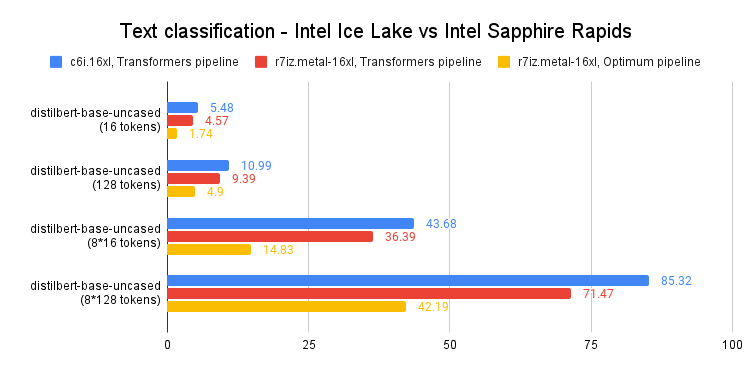
سرعت inference PyTorch با پردازندهٔ Intel Sapphire Rapids برتر
در این مقاله، سرعت inference مدلهای NLP بر پایه PyTorch را در سرورهای Intel Sapphire Rapids و Ice Lake میسنجیم و نکات عملی برای بهرهبرداری را بررسی میکنیم.
 سختافزار
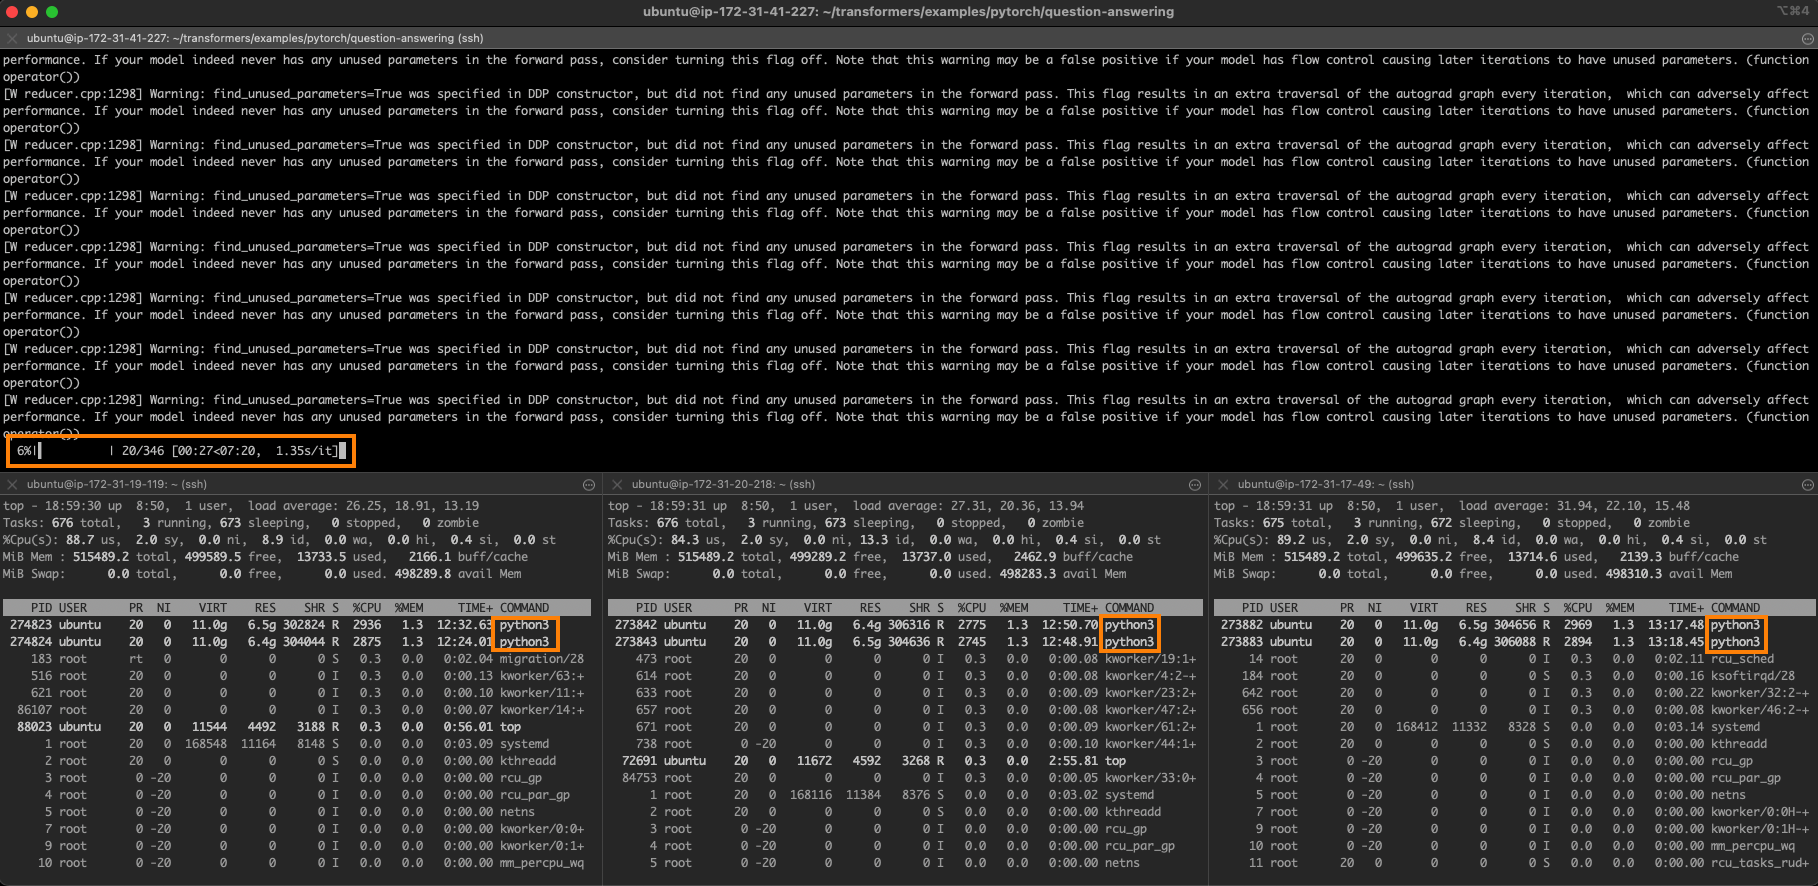
هوش مصنوعی در سرورهای Intel Sapphire Rapids: 2 برابری سرعت یادگیری ماشین
سرورهای جدید Intel Sapphire Rapids با دستورات ویژهی متریس پیشرفته، یادگیری عمیق در PyTorch را دو برابری سرعت میکنند. در این مقاله، به تفصیل بهینهسازیهای IPEX و CCL پرداخته میشود.