معرفی نسل چهارم پردازندهٔ Intel Sapphire Rapids
نسل چهارم سری Xeon سرورهای Intel، با نام کد "Sapphire Rapids"، امکاناتی نوین مانند Advanced Matrix Extensions (AMX) را معرفی کرد. این دستورها امکان محاسبات ماتریسی سریعتر را در پردازنده فراهم میآورند.
نقش AMX و سختافزارهای دیگر در تسریع inference
بهکارگیری کتابخانهٔ Intel Extension for PyTorch و Optimum Intel، احساسی از همپوشانی نرمافزار و سختافزار را القا میکند. ترکیب این ابزارها با سرورهای Amazon EC2، سرعت محاسبات را بهطور چشمگیری افزایش میدهد.
نتایج تجربی و مقایسه با Ice Lake
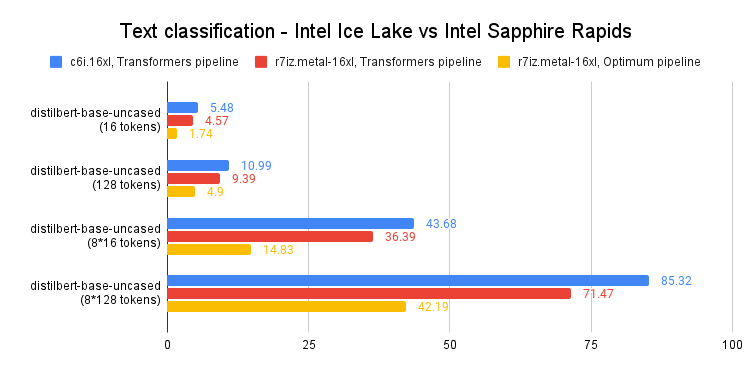
عملکرد مدلهای NLP محبوب با طول توکنهای کوتاه و بلند در سرورهای Ice Lake (نسل قبلی) و Sapphire Rapids (نسل جدید) بهصورت زیر مقایسه شد:
- سرعت میانگین inference در Sapphire Rapids: 8 بار بیشتر نسبت به Ice Lake.
- مقیاسپذیری خطی نزدیک به 8 سرور.
- کاهش مصرف انرژی بهطور قابل توجه.
نکات عملی برای بهرهبرداری از Optimum Intel
برای استفاده مؤثر:
- پروژههای PyTorch را با نسخهٔ 2.0+ و پشتیبانی از AMX ارتقا دهید.
- از مدلهای HuggingFace Transformers با پارامتر optimized for Intel استفاده کنید.
- سرویسهای inference در محیطهای ابری را با انتخاب سرورهای Sapphire Rapids پیکربندی کنید.
پرسشهای پرتکرار
چه تأثیری Sapphire Rapids بر سرعت inference مدلهای NLP دارد؟
Sapphire Rapids با دستورهای AMX و بهینهسازیهای کتابخانهای میتواند سرعت inference را تا 8 برابر نسبت به نسل قبلی افزایش دهد.
برای استفاده از Optimum Intel چه مراحلی را باید طی کرد؟
ابتدا نسخهٔ جدید PyTorch را نصب کنید، سپس Optimum Intel را به پروژهٔ خود اضافه کنید و مدلهای HuggingFace را با پارامترهای optimised for Intel اجرا نمایید.