سرعت پردازندههای جدید Intel Sapphire Rapids
در سال گذشته، پردازندههای سهمرهای Xeon (Ice Lake) برای آموزش مدلهای ساختاردهی زبان مانند Hugging Face Transformers معرفی شد. اکنون, Intel نسل چهارم خود، Sapphire Rapids، که با دستورات جدید AVX‑512 و سرورهای IPEX بهینهسازی شده، ارائه میدهد. این پردازندهها قادر به انجام عملیات پیچیده پایه در یادگیری عمیق با سرعتی چند برابر نسبت به نسل قدیمیتر هستند.
پیکربندی یک خوشه اختصاصی بر روی AWS
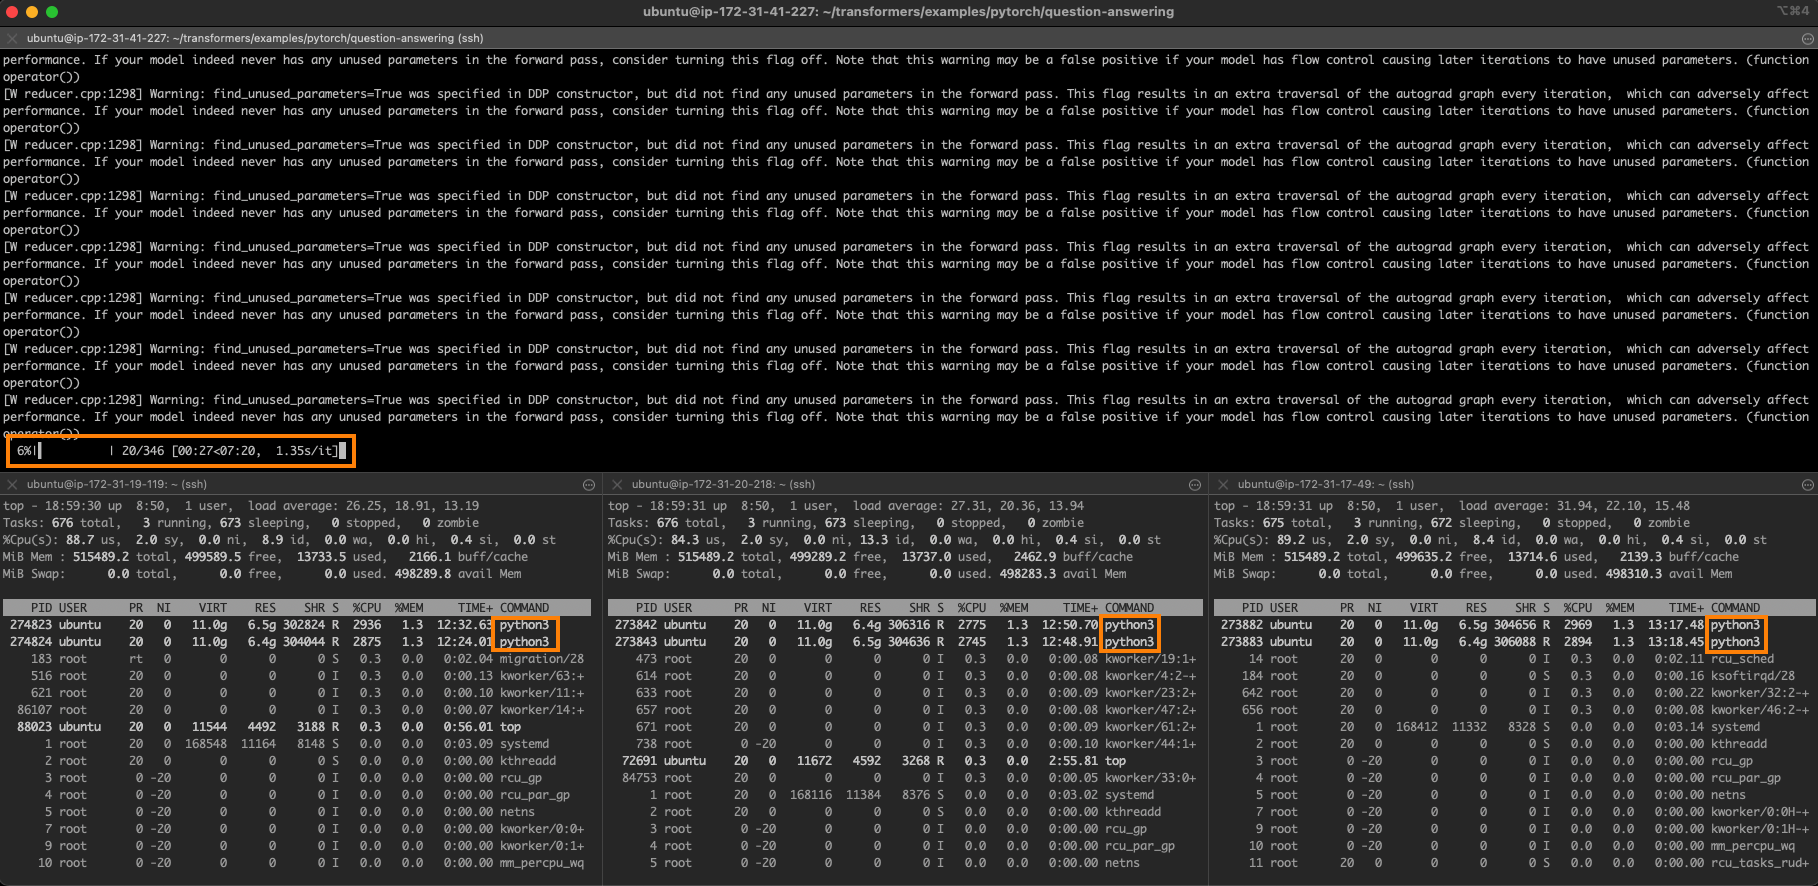
توزیع آموزش روی چندین CPU از Sapphire Rapids میتواند با استفاده از کتابخانه Intel oneAPI Collective Communications Library (CCL) صورت گیرد. CCL نقش مهمی در اشتراکگذاری داده بین نودها ایفا میکند و با توجه به معماری جدید این پردازندهها، حفظ همگنیت داده را به راحتی انجام میدهد.
استفاده از IPEX برای بهرهوری بالاتر در PyTorch
Extended library IPEX (Intel Extension for PyTorch) در کنار کتابخانههای Hugging Face، بدون نیاز به تغییرات کد، دستورات AVX‑512 و سایر بهینهسازیهای سختافزاری را فعال میکند. به این ترتیب میتوانید مدلهای Transformer را با نسبت 2 برابر سرعت یادگیری نسبت به نسخههای استاندارد، در ردیفهای کد قرار دهید.
- استفاده از دستورات جریان متریس (VNNI) و AVX‑512 برای کاهش زمان اتمام خسارت.
- یکپارچگی با میژوهای واحد IPEX برای تغییر خودکار توزیع داده در حافظه.
- پشتیبانی از انواع توزیع، از جمله DataParallel، DistributedDataParallel و کلاستر Kubernetes.
- اجرای بدون تغییر در اسکریپتهای Hugging Face و PyTorch.
پرسشهای پرتکرار
چگونه میتوانم از دستورات IPEX در پروژهی خود استفاده کنم؟
بهسادگی، داکیومنت کاگذاری را با محیط PyTorch خود ادغام کنید. فقط با افزودن تنظیمات "enable_ipex" به ۱ در کتابخانه IPEX، قابلیتهای سختافزاری را فعال کنید.
آیا استفاده از Sapphire Rapids بهصورت تک سرور قابل اجراست؟
بله، با اجرای CCL و IPEX در یک سرور، حتی برای پروژههای کوچک میتوانید از بهینهسازیهای سختافزاری بهره ببرید؛ اما برای مقیاس بالا، خوشهی چند سرور توصیه میشود.