
 آموزش
استقرار پایپلاین هوش مصنوعی ترنسفورمرز روی Google Cloud بدون سرور
در این مقاله تجربه استقرار یک پایپلاین تحلیل احساسات با ترنسفورمرز و Google Cloud را میخوانید؛ از انتخاب سرویس مناسب تا هزینهها و عملکرد.
 آموزش
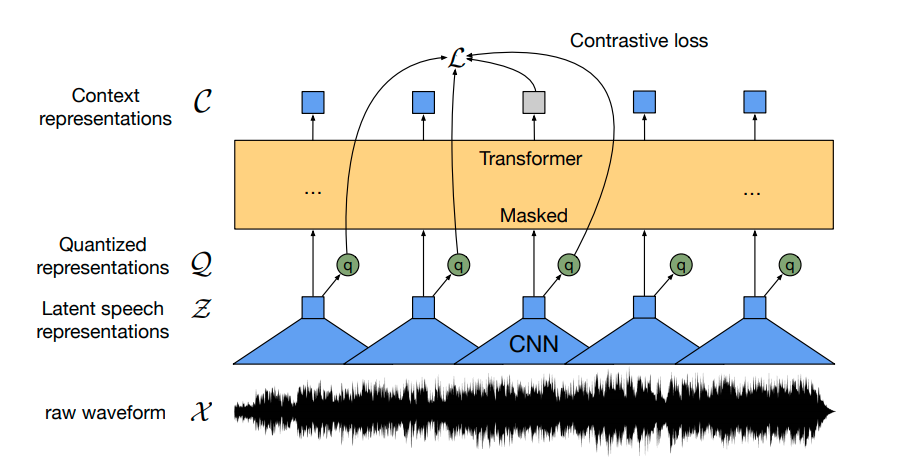
آموزش دقیق Wav2Vec2 برای تشخیص گفتار انگلیسی با هوش مصنوعی
در این مقاله از بلاگ هوش مصنوعی هما، نحوه تنظیم دقیق مدل Wav2Vec2 برای تشخیص خودکار گفتار انگلیسی با کتابخانه Transformers آموزش داده میشود.
 پژوهش
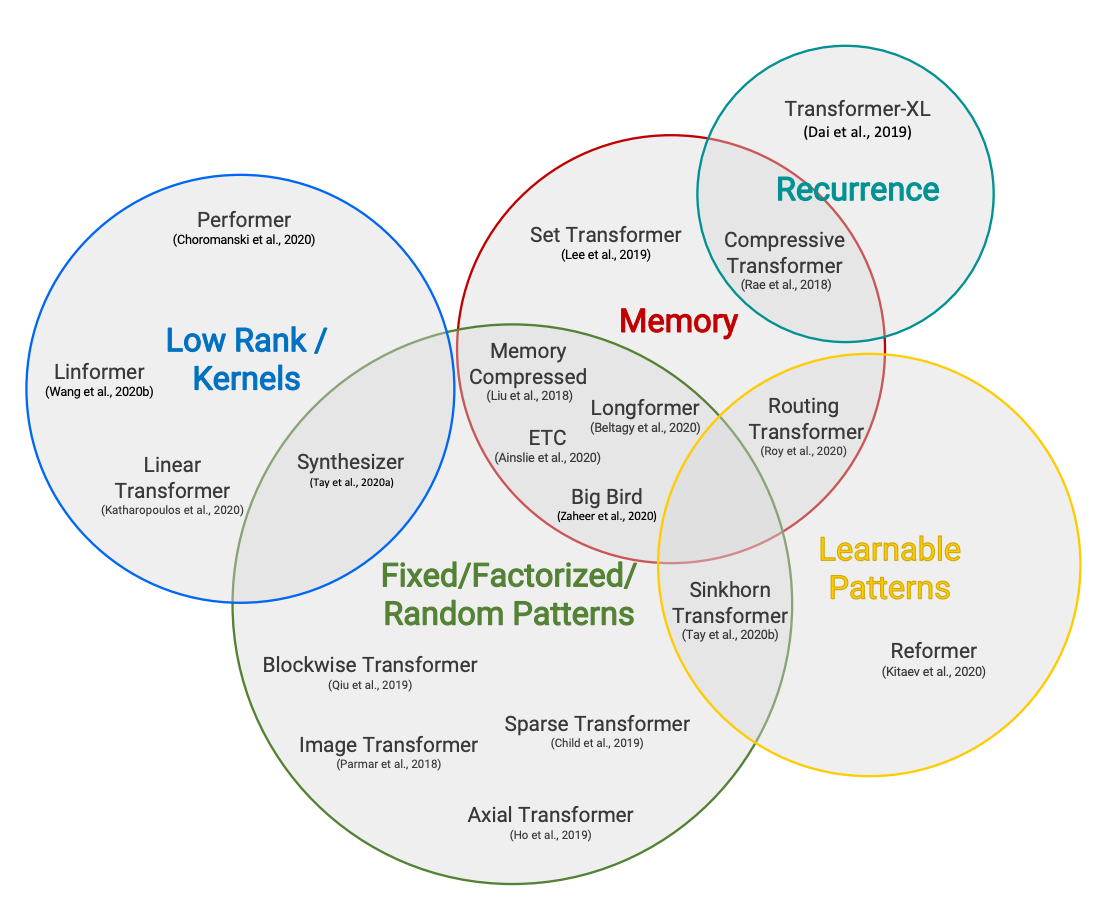
هوش مصنوعی در خواندن متنهای طولانی: معرفی ترنسفورمهای بلنددامنه
در این مقاله از سری خواندنیهای هوش مصنوعی، به معرفی ترنسفورمهای بلنددامنه و راهکارهای کاهش پیچیدگی محاسباتی برای پردازش متنهای طولانی میپردازیم.
 پژوهش
کشف نورونهای چندحالته در هوش مصنوعی؛ گامی به سوی درک بهتر CLIP
کشف نورونهای چندحالته در شبکه عصبی CLIP نشان میدهد هوش مصنوعی چگونه مفاهیم را در قالبهای مختلف درک میکند و به شناسایی سوگیریها کمک میکند.
 آموزش
هوش مصنوعی و شبکههای عصبی: راهنمای ساده برای سازندگان پیچیده
با وجود پیشرفت ابزارهای یادگیری عمیق، ساخت شبکههای عصبی نیازمند توجه به نکات ساده اما حیاتی است. این مقاله از تجربه هافینگ فیس میگوید.
 مدلها
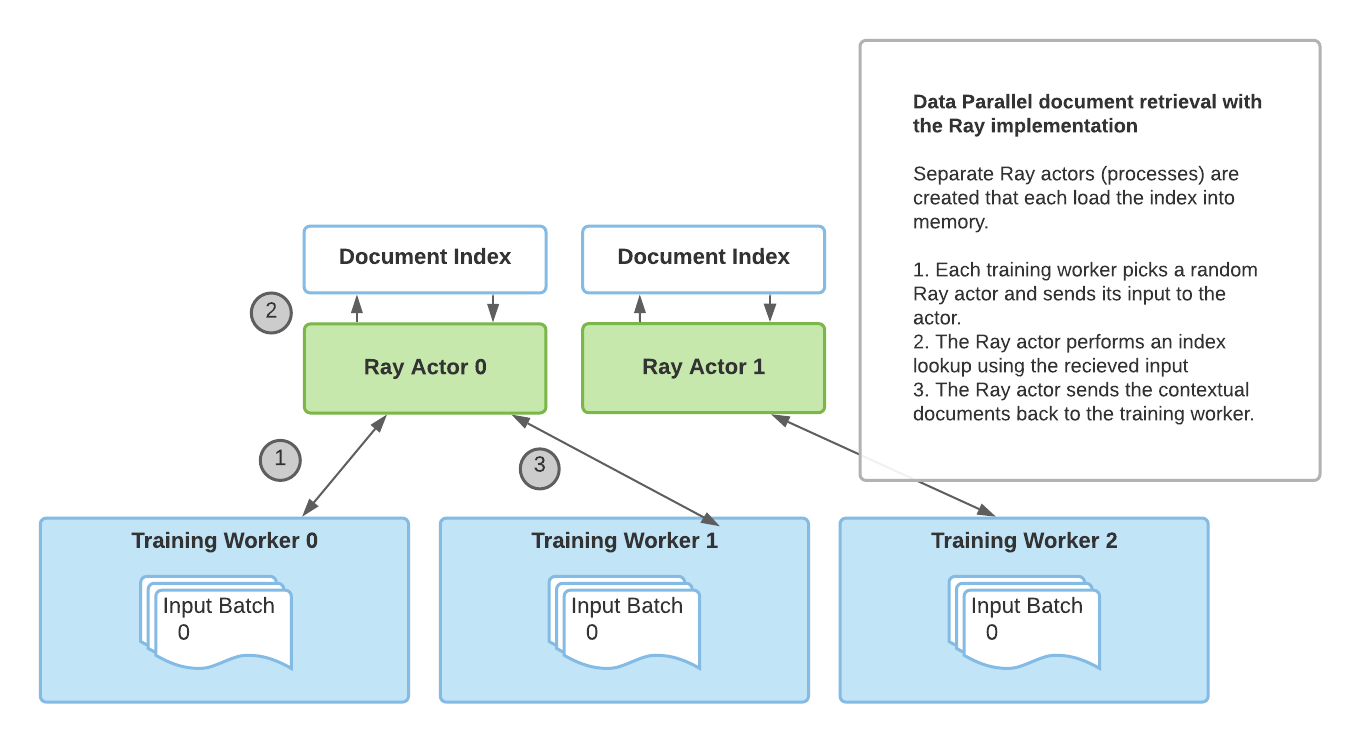
هوش مصنوعی با RAG و Ray: افزایش سرعت بازیابی متن تا ۲ برابر
با ترکیب RAG و Ray، سرعت بازیابی اسناد در مدلهای زبانی هوش مصنوعی تا ۲ برابر افزایش یافته و مقیاسپذیری تنظیم دقیق توزیعشده نیز بهطور چشمگیری بهبود مییابد.
 اخبار
آموزش سریعتر و ارزانتر مدلهای هوش مصنوعی با PyTorch و TPU
با جدیدترین یکپارچهسازی PyTorch/XLA و Hugging Face، مدلهای هوش مصنوعی را بدون تغییر در رابط Trainer روی Cloud TPU سریعتر و ارزانتر آموزش دهید.
 پژوهش
هوش مصنوعی و مدلهای زبانی بزرگ: قابلیتها، محدودیتها و تأثیرات اجتماعی
گزارش جدید OpenAI درباره قابلیتها و کاستیهای مدلهای زبانی بزرگ و تأثیر آنها بر جامعه؛ مروری بر نکات کلیدی و درسهای مهم برای توسعهدهندگان و کاربران هوش مصنوعی.
 اخبار
مقیاسپذیری Kubernetes به ۷۵۰۰ گره؛ زیرساخت هوش مصنوعی OpenAI
اوپنایآی با مقیاسبندی کوبرنیتز به ۷۵۰۰ گره، زیرساختی قدرتمند برای آموزش مدلهای بزرگ هوش مصنوعی مانند GPT-3 و DALL·E فراهم کرده است.
 آموزش
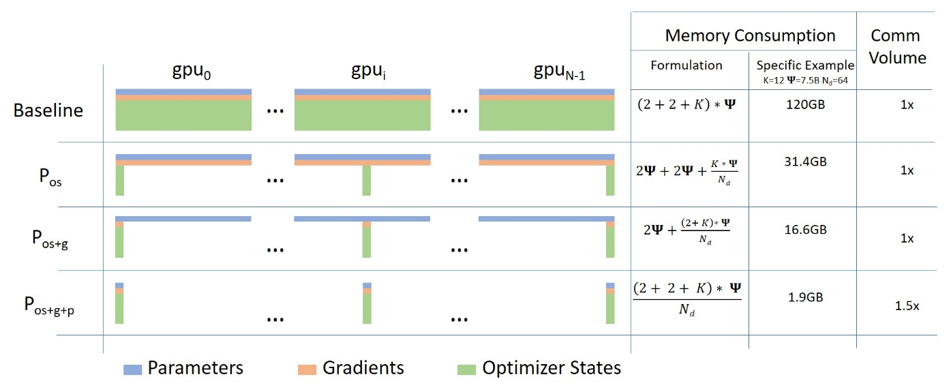
هوش مصنوعی و بهینهسازی حافظه: معرفی ZeRO با DeepSpeed و FairScale
با رشد مدلهای بزرگ، حافظه GPU پاسخگو نیست. ZeRO در DeepSpeed و FairScale راهکاری برای آموزش سریعتر و بهینهسازی مصرف حافظه است.