اگر در حوزه یادگیری عمیق و هوش مصنوعی فعالیت میکنید، حتما با مشکل کمبود حافظه GPU هنگام کار با مدلهای بزرگ مواجه شدهاید. اندازه مدلهای زبانی بسیار سریعتر از ظرفیت حافظه کارتهای گرافیکی جدید رشد میکند و بسیاری از کاربران امکان بارگذاری یا آموزش این مدلها را روی سختافزار خود ندارند. ZeRO یکی از راهکارهای مهم برای حل این مشکل است که در قالب دو کتابخانه DeepSpeed و FairScale در دسترس قرار گرفته است.
مشکل بزرگ حافظه در آموزش مدلهای عمیق
مدلهای پیشرفته امروزی نهتنها به دادههای زیاد نیاز دارند، بلکه تعداد پارامترهای آنها به میلیاردها میرسد. در روشهای سنتی، هر GPU باید تمام وزنها، گرادیانها و حالتهای بهینهساز را در حافظه نگه دارد؛ بنابراین آموزش مدلهایی با میلیاردها پارامتر روی یک یا چند GPU تقریبا غیرممکن میشود. تلاشهایی مانند تقطیر مدلها برای کوچکسازی آنها وجود دارد، اما همچنان برای پژوهشگران پاسخ سریع و کافی نیست.
ZeRO چیست و چطور حافظه را بهینه میکند؟
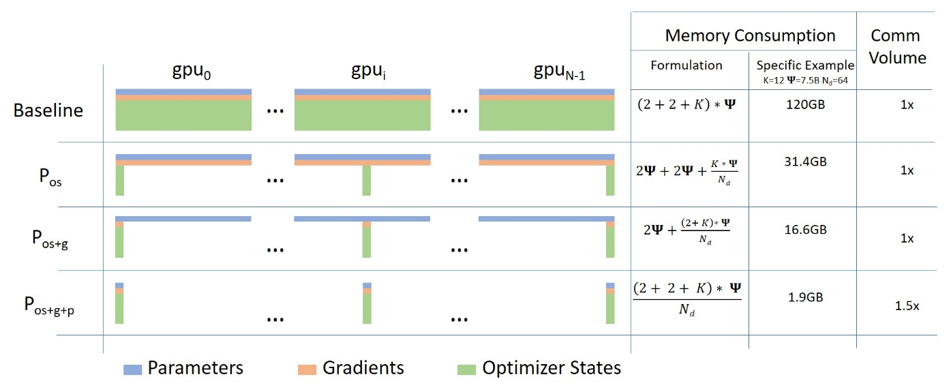
در پاییز ۲۰۱۹، سامیام راجبهانداری، جف راسلی، اولاتونجی رواسه و یوکسینگ هو مقاله مهمی با عنوان «ZeRO: بهینهسازی حافظه بهسوی آموزش مدلهای با هزار میلیارد پارامتر» منتشر کردند. ایده اصلی ZeRO این است که بهجای ذخیره تکراری دادهها روی همه GPUها، پارامترها، گرادیانها و وضعیت بهینهساز را بین دستگاهها تقسیم کند. این کار باعث میشود هر GPU فقط بخشی از دادهها را نگه دارد و در نتیجه مدلهای بسیار بزرگتری را بتوان آموزش داد.
- تقسیم وضعیت بهینهساز، گرادیانها و پارامترها بین GPUها
- کاهش چشمگیر حافظه مصرفی در هر دستگاه
- امکان آموزش مدلهای بزرگتر روی سختافزارهای محدودتر
- افزایش سرعت آموزش با بهرهگیری بهتر از چند GPU
DeepSpeed و FairScale: دو پیادهسازی متنباز ZeRO
کمی پس از انتشار مقاله ZeRO، کتابخانه DeepSpeed منتشر شد که بیشتر ایدههای این مقاله را بهصورت متنباز در اختیار توسعهدهندگان قرار داد. در همان زمان، تیمی از فیسبوک نیز پیادهسازی دیگری با نام FairScale ارائه کرد. هر دو ابزار تلاش میکنند تا توانایی سختافزار موجود را فراتر از تصور قبلی افزایش دهند و به پژوهشگران اجازه دهند مدلهای بزرگ را با سرعت بیشتری آموزش بدهند.
آموزش سریعتر با چند GPU
روش ZeRO علاوه بر کاهش مصرف حافظه، میتواند سرعت آموزش را نیز بهطور قابل توجهی افزایش دهد. در تنظیمات چند GPU، تقسیم دادهها بهینهسازیهای زیادی را امکانپذیر میکند و ارتباط بین پردازندهها هوشمندانهتر مدیریت میشود. این ویژگی برای پژوهشگرانی که بودجه سختافزاری محدودی دارند و در عین حال میخواهند در مسیر پیشرفت مدلهای بزرگ حرکت کنند، بسیار ارزشمند است.
مسیر آینده و چالشهای پیش رو
مقاله اصلی ZeRO همچنان الهامبخش توسعه راهکارهای جدید برای آموزش مدلهای عظیم است. هرچند برخی ایدههای مطرحشده در مقاله هنوز بهطور کامل پیادهسازی نشدهاند، اما همکاری جوامع متنباز مانند Hugging Face باعث میشود این فناوریها سریعتر به دست علاقهمندان برسد. مسائلی مانند توزیع کارآمد دادهها و مدیریت ارتباطات بین GPUها همچنان حوزه فعال پژوهش و توسعه به شمار میرود.
پرسشهای پرتکرار
ZeRO چیست؟
ZeRO یک روش بهینهسازی حافظه است که پارامترها، گرادیانها و وضعیت بهینهساز را بین GPUها تقسیم میکند تا امکان آموزش مدلهای بسیار بزرگ روی سختافزار محدود فراهم شود.
تفاوت DeepSpeed و FairScale چیست؟
هر دو پیادهسازی متنباز مقاله ZeRO هستند؛ DeepSpeed توسط تیم DeepSpeed مایکروسافت و FairScale توسط تیمی از فیسبوک توسعه یافته و هر دو هدف مشترکی یعنی کاهش مصرف حافظه و افزایش سرعت آموزش دارند.