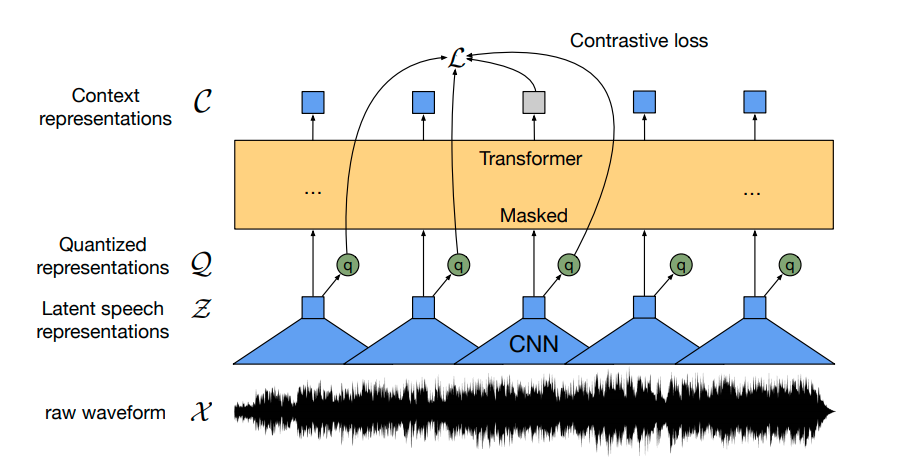
مدلهای زبانی مبتنی بر یادگیری عمیق، انقلابی در حوزه پردازش گفتار ایجاد کردهاند. یکی از پیشگامان این تحول، مدل Wav2Vec2 است که توسط محققان متا (Meta) در سپتامبر ۲۰۲۰ معرفی شد. این مدل با استفاده از یک رویکرد پیشآموزش کنتراستی (Contrastive Pretraining) توانسته است بازنماییهای قدرتمندی از گفتار خام بیاموزد. در این مقاله از بلاگ هوش مصنوعی هما، به بررسی فرآیند تنظیم دقیق (Fine-Tuning) این مدل برای تشخیص خودکار گفتار انگلیسی (ASR) با استفاده از کتابخانه Transformers شرکت Hugging Face میپردازیم.
چرا Wav2Vec2 برای تشخیص گفتار اهمیت دارد؟
پیش از معرفی Wav2Vec2، سیستمهای تشخیص گفتار عمدتاً به دادههای برچسبخوردهٔ زیادی نیاز داشتند. اما Wav2Vec2 با پیشآموزش بر روی بیش از ۵۰ هزار ساعت گفتار بدون برچسب، توانسته است بازنماییهای زمینهای (Contextualized Representations) از گفتار یاد بگیرد. این فرآیند مشابه تکنیک ماسککردن در مدل BERT است؛ به این صورت که ویژگیهای گفتار بهصورت تصادفی ماسک میشوند و مدل باید آنها را بازسازی کند. نتیجه این شد که با فقط ۱۰ دقیقه دادهٔ برچسبخورده، نرخ خطای کلمه (WER) کمتر از ۵٪ روی مجموعه آزمون تمیز LibriSpeech به دست آمد که رقابتی با بهترین سیستمهای موجود است.
مراحل تنظیم دقیق Wav2Vec2
در آموزش تنظیم دقیق این مدل، چهار مرحله اصلی وجود دارد که هر کدام نقشی کلیدی در عملکرد نهایی ایفا میکنند. این مراحل عبارتند از:
- آمادهسازی دادهها و توکنایزر مخصوص (Wav2Vec2CTCTokenizer)
- استخراج ویژگیها با استفاده از Wav2Vec2 Feature Extractor
- پیشپردازش دادههای صوتی و متنی
- آموزش مدل با استفاده از Trainer و ارزیابی آن
توکنایزر، خروجی مدل را به توالیهای متنی تبدیل میکند و Feature Extractor نیز سیگنال خام صوتی را به بردارهای ویژگی تبدیل میکند. کتابخانه Transformers ابزارهای آمادهای برای این مراحل فراهم کرده است.
آموزش و ارزیابی مدل
بعد از آمادهسازی دادهها، نوبت به آموزش مدل میرسد. با استفاده از ماژول Trainer در Transformers، میتوان فرآیند آموزش را بهسادگی مدیریت کرد. تنظیم هایپرپارامترها، انتخاب نرخ یادگیری و تعداد Epochها از جمله تصمیمهای مهم در این مرحله هستند. در پایان، مدل آموزشدیده باید روی مجموعه داده جداگانهای ارزیابی شود. معیار WER (Word Error Rate) استاندارد طلایی برای سنجش کیفیت تشخیص گفتار است. هرچه این عدد کمتر باشد، دقت مدل بالاتر است.
یکی از نکات جالب توجه در این مقاله، تأکید بر متنباز بودن این فناوری است. Hugging Face با ارائه ابزارهای متنباز و جامعه فعال خود، فرآیند دموکراتیزه کردن هوش مصنوعی را سرعت بخشیده است. هر توسعهدهندهای میتواند با استفاده از این آموزشها، مدلهای ASR اختصاصی خود را تنها با چند خط کد بسازد.
پرسشهای پرتکرار
Wav2Vec2 چگونه عمل میکند؟
Wav2Vec2 با پیشآموزش بر روی دادههای گفتار بدون برچسب، بازنماییهای زمینهای قدرتمندی یاد میگیرد و سپس با مقدار کمی داده برچسبخورده میتوان آن را برای تشخیص گفتار تنظیم دقیق کرد.
چه میزان داده برای تنظیم دقیق لازم است؟
طبق مقاله منتشر شده توسط Hugging Face، با تنها ۱۰ دقیقه داده برچسبخورده میتوان به نرخ خطای کلمه کمتر از ۵ درصد روی مجموعه تست LibriSpeech دست یافت.