
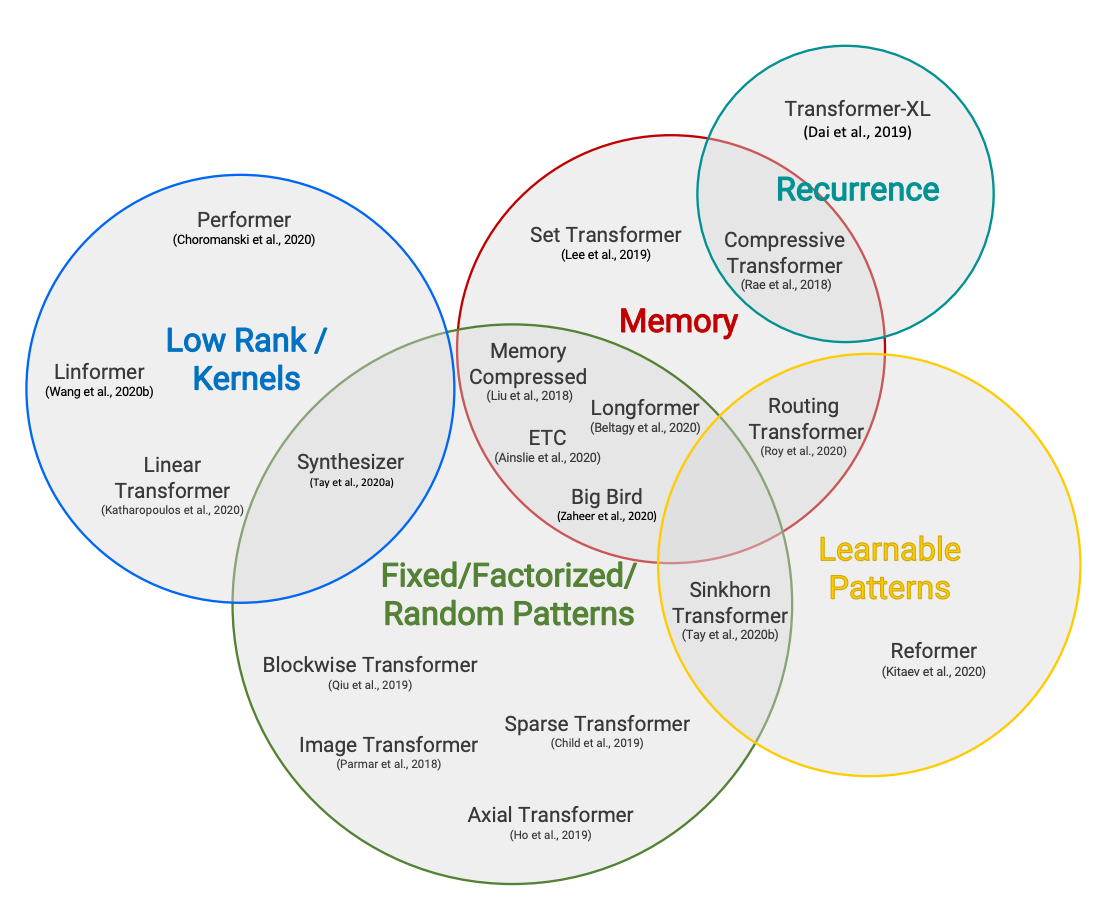
ظهور مدلهای ترنسفورم در سالهای ۲۰۱۸ و ۲۰۱۹ تحولی عظیم در حوزه هوش مصنوعی ایجاد کرد. اما یکی از چالشهای اصلی این مدلها، وابستگی آنها به پیچیدگی درجه دوم در محاسبه توجه (Attention) است که پردازش متنهای بلند را بسیار پرهزینه میکند. در ادامه، به خلاصهای از پژوهشهای اخیر در زمینه ترنسفورمهای بلنددامنه (Long-range Transformers) میپردازیم که توسط تیم Hugging Face و در قالب برنامه «خواندنیهای هوش مصنوعی» منتشر شده است.
چالش ترنسفورمها در پردازش متنهای طولانی
ترنسفورمهای استاندارد برای هر جفت توکن در ورودی، وزن توجه محاسبه میکنند؛ این یعنی هزینه محاسباتی به صورت درجه دو با طول متن رشد میکند. به همین دلیل، پردازش اسناد طولانی یا کتابها با این مدلها عملاً غیرممکن یا بسیار پرهزینه است. پژوهشگران برای حل این مشکل، چهار رویکرد اصلی ارائه کردهاند که هر یک به نوعی پیچیدگی محاسباتی را کاهش میدهند.
راهحلهای ارائهشده در پژوهشهای برجسته
در این بخش، چهار مقاله کلیدی که در برنامه خواندنیهای فوریه ۲۰۲۱ مورد بحث قرار گرفتند، معرفی میکنیم:
- Longformer: با استفاده از ترکیب پنجرههای توجه محلی و یک الگوی توجه گلوبال، امکان پردازش اسناد بلند را بدون نیاز به محاسبه کامل ماتریس توجه فراهم میکند.
- Compressive Transformers: این روش با فشردهسازی خاطرات قدیمی در طول زمان، حافظه بلندمدت مدل را افزایش میدهد و میتواند وابستگیهای دور را بهتر مدل کند.
- Linformer: با فرض کمرتبه بودن ماتریس توجه، این روش پیچیدگی را از درجه دو به خطی کاهش میدهد و برای مجموعه دادههای بزرگ مقیاسپذیر است.
- Performer: با استفاده از هستههای تصادفی و تقریب توجه، مدلی با پیچیدگی خطی ارائه میدهد که دقت آن به مدل استاندارد نزدیک است.
جمعبندی و روندهای آینده
مطالعه این مقالات نشان میدهد که هدف مشترک همه آنها، حفظ کیفیت مدل در عین کاهش بار محاسباتی است. رویکردهای مختلفی مانند توجه محلی، فشردهسازی حافظه و تقریب خطی، هر کدام مزایا و محدودیتهای خاص خود را دارند. این پژوهشها گامی مهم در جهت توسعه مدلهای زبانی کارآمدتر برای متنهای طولانی هستند و میتوانند زمینه را برای کاربردهای عملی هوش مصنوعی در حوزههایی مانند تحلیل اسناد حقوقی، مقالات علمی و کتابهای دیجیتال فراهم کنند. همکاریهای متنباز و انتشار عمومی یافتهها، روند سریع پیشرفت در این زمینه را تسریع کرده است.
پرسشهای پرتکرار
چرا ترنسفورمها در پردازش متنهای طولانی با مشکل مواجه هستند؟
ترنسفورمهای استاندارد برای هر جفت توکن، وزن توجه محاسبه میکنند و این کار هزینه محاسباتی درجه دو دارد؛ بنابراین با افزایش طول متن، محاسبات به شدت سنگین میشود.
Longformer چه تفاوتی با ترنسفورم استاندارد دارد؟
Longformer به جای محاسبه کامل ماتریس توجه، از ترکیب توجه محلی در پنجرهها و توجه گلوبال برای توکنهای کلیدی استفاده میکند که پیچیدگی را کاهش میدهد و پردازش اسناد طولانی را ممکن میسازد.


