بازیابی افزوده (RAG) چیست؟
مدلهای زبانی بزرگ معمولاً به دانش محدود خود تکیه میکنند، اما معماری جدید «بازیابی افزوده» یا Retrieval Augmented Generation به مدل اجازه میدهد تا در لحظهی اجرا، اسناد مرتبط را از یک پایگاه دانش خارجی مانند ویکیپدیا بازیابی کرده و پاسخ خود را بر اساس آنها تولید کند. این رویکرد به هوش مصنوعی کمک میکند تا در وظایف دانشمحور به نتایج بهتری دست یابد و از اطلاعات بهروز و خارج از حافظهی مدل بهرهبرداری کند.
نقش Ray در بهینهسازی RAG
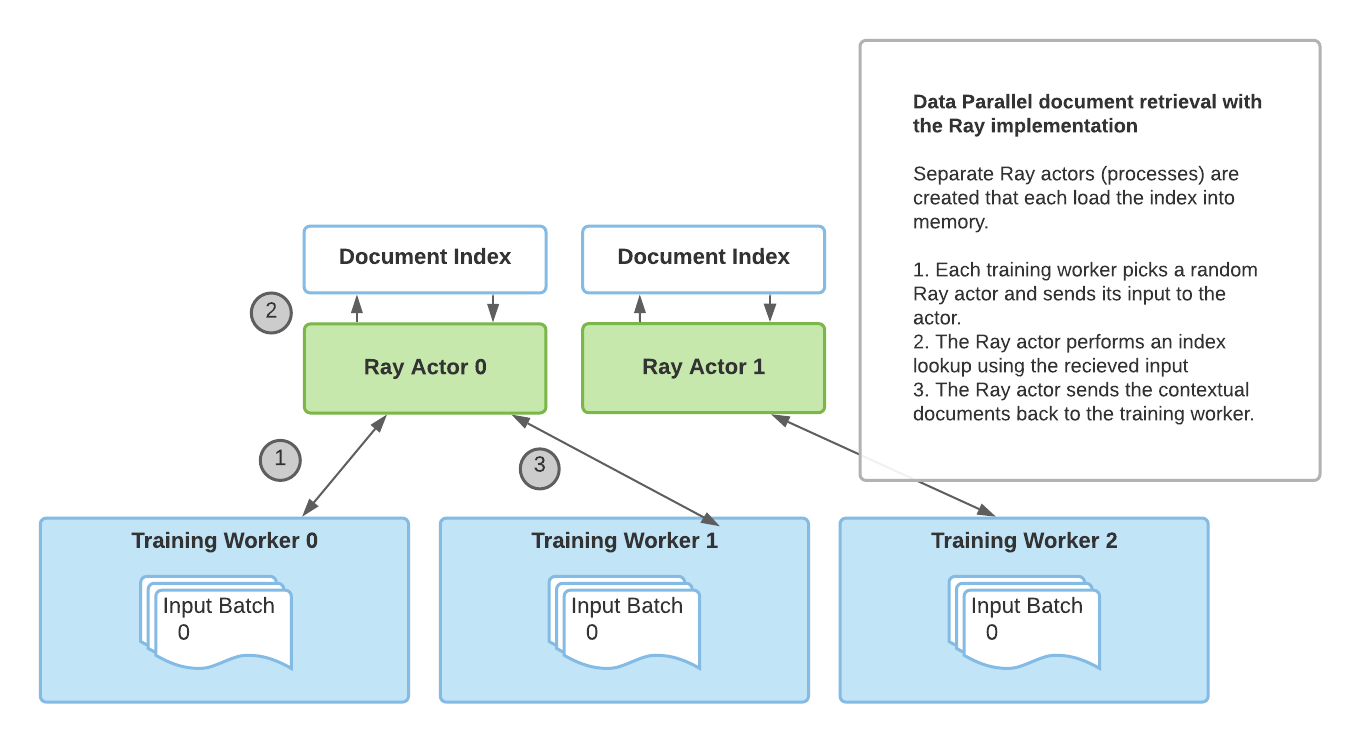
کتابخانهی Ray که برای ساخت اپلیکیشنهای مقیاسپذیر طراحی شده، بهتازگی با مدل RAG در Hugging Face Transformers یکپارچه شده است. این یکپارچهسازی بخش بازیابی اسناد زمینهساز را متحول کرده و سرعت فراخوانیها را تا ۲ برابر افزایش داده است. علاوه بر این، Ray مقیاسپذیری تنظیم دقیق توزیعشدهی RAG را بهبود میبخشد و امکان پردازش حجم بالاتری از دادهها را فراهم میکند.
مزایای کلیدی این راهکار
- افزایش دو برابری سرعت بازیابی اسناد متنی
- بهبود چشمگیر مقیاسپذیری در فرآیند تنظیم دقیق
- ترکیب ساده با کتابخانهی Transformers بدون تغییر در رابط مدل
- پشتیبانی از پایگاههای دانش بزرگ مانند ویکیپدیا
با این قابلیت، توسعهدهندگان میتوانند مدلهای زبانی هوش مصنوعی را با هزینهی محاسباتی کمتر و سرعت بالاتر به سامانههای دانشمحور متصل کنند. این همکاری میان Hugging Face و Anyscale نشاندهندهی حرکت صنعت به سمت ابزارهای متنباز و مقیاسپذیر در حوزهی هوش مصنوعی است.
پرسشهای پرتکرار
مدل RAG چگونه به دانش خارجی دسترسی پیدا میکند؟
RAG بهعنوان یک مدل توالیبهتوالی، طی استنتاج از یک پایگاه دانش خارجی مانند ویکیپدیا اسناد مرتبط با ورودی را بازیابی میکند و این اسناد را به همراه ورودی اصلی به مدل میدهد تا خروجی نهایی دقیقتری تولید شود.
یکپارچهسازی Ray چه مزیتی برای RAG دارد؟
Ray سرعت فراخوانیهای بازیابی اسناد را تا ۲ برابر افزایش میدهد و مقیاسپذیری فرآیند تنظیم دقیق توزیعشده را بهبود میبخشد، که برای کاربردهای گستردهی هوش مصنوعی حیاتی است.