
 مدلها
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.
 سختافزار
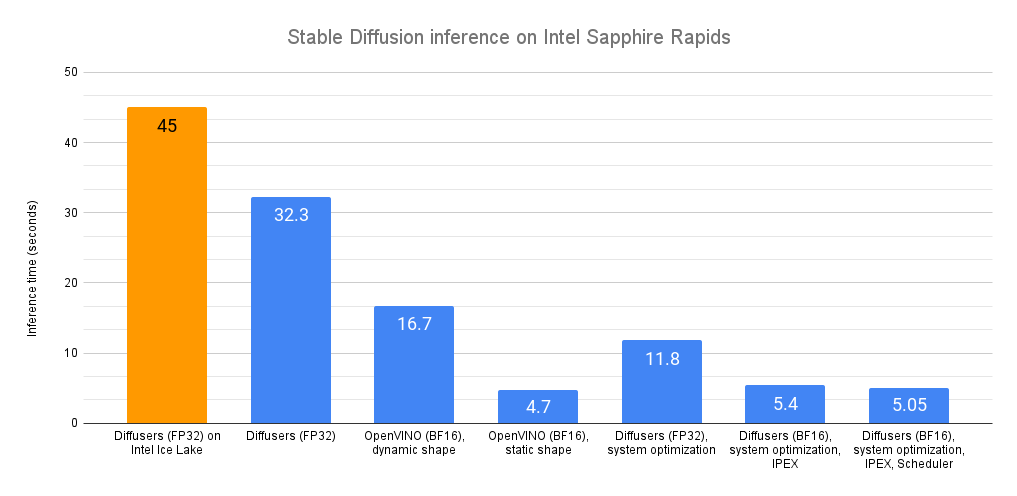
سرعتدادن Stable Diffusion بر CPUهای Intel: راهنمای هوش مصنوعی
با بهرهگیری از چهارتا تکنیک اصلی در پردازندههای Intel Sapphire Rapids، پیشبینی مدل Stable Diffusion را معنادار سرعتبخشید. راهنمای جامع برای توسعهدهندگان و محققان.
 سختافزار
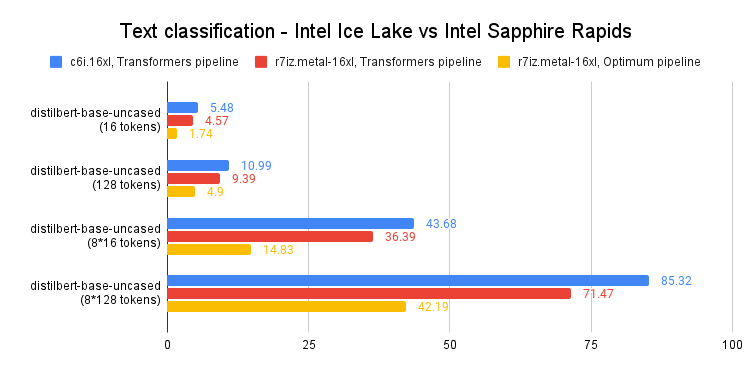
سرعت inference PyTorch با پردازندهٔ Intel Sapphire Rapids برتر
در این مقاله، سرعت inference مدلهای NLP بر پایه PyTorch را در سرورهای Intel Sapphire Rapids و Ice Lake میسنجیم و نکات عملی برای بهرهبرداری را بررسی میکنیم.
 سختافزار
هوش مصنوعی در سرورهای Intel Sapphire Rapids: 2 برابری سرعت یادگیری ماشین
سرورهای جدید Intel Sapphire Rapids با دستورات ویژهی متریس پیشرفته، یادگیری عمیق در PyTorch را دو برابری سرعت میکنند. در این مقاله، به تفصیل بهینهسازیهای IPEX و CCL پرداخته میشود.
 آموزش
Vision Transformers بر روی Graphcore: آموزش سریع مدل های پزشکی با هوش مصنوعی
در این مقاله بررسی میکنیم چطور میتوان با استفاده از کتابخانهٔ Hugging Face Optimum و پردازندهٔ Graphcore IPU، مدل Vision Transformer را بر روی دادههای رادیولوژیکی تنظیم کرد و سرعت و کارایی بالایی بدست آورد.
 پژوهش
هوش مصنوعی در میلیثانیه: چطور Hugging Face Infinity با CPUهای مدرن زودترین پاسخ را میدهد
مطالعهٔ موردی از سرعت میلیثانیهای مدلهای هوش مصنوعی با استفاده از Hugging Face Infinity و پردازندههای هوشمند. فناوری، عملکرد و راهکارهای جایگزین
 سختافزار
سرعتبخشی مدل BERT با پردازندههای Intel: بهینهسازی هوش مصنوعی روی CPU
این مقاله بررسی میکند چگونه با بهرهگیری از قابلیتهای پردازنده Intel، مدلهای مشابه BERT را روی CPU بهینه میکنیم و سرعت بالایی به دست میآوریم.