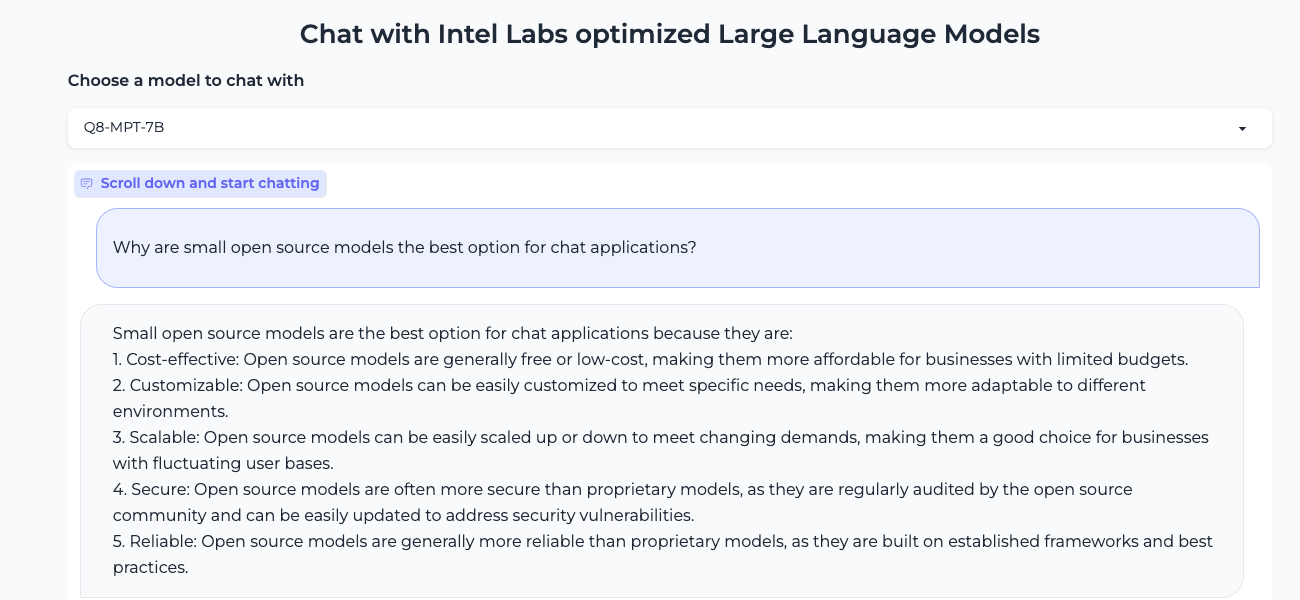
مدلهای زبانی بزرگ (LLM) مانند BLOOM با صدها میلیارد پارامتر، قدرت فوقالعادهای در پردازش زبان طبیعی دارند، اما اجرای آنها معمولاً به GPUهای پرقدرت نیاز دارد و هزینه سنگینی تحمیل میکند. پست جدید وبلاگ Hugging Face نشان میدهد که با بهینهسازی هوشمندانه، میتوان چنین مدلهایی را روی پردازنده معمولی Xeon اینتل اجرا کرد و تجربه چت روانی به دست آورد. در این مقاله، به سراغ همین راهکار میرویم.
کوانتیزاسیون چیست و چرا اهمیت دارد؟
کوانتیزاسیون (Quantization) تکنیکی است که دقت عددی پارامترهای مدل را کاهش میدهد. به زبان ساده، به جای ذخیره اعداد با ۳۲ بیت یا ۱۶ بیت، از ۸ بیت استفاده میشود. این کار حجم مدل را چند برابر کم میکند و میزان حافظه و توان محاسباتی مورد نیاز را کاهش میدهد. در نتیجه، مدلهای بزرگ میتوانند روی سختافزارهای معمولیتر جان بگیرند.
Q8-Chat؛ مدلی که روی CPU حرف میزند
Q8-Chat یک نمونه موفق از این بهینهسازی است. این مدل که برای اجرا روی پردازنده Xeon اینتل طراحی شده، از کوانتیزاسیون ۸ بیتی بهره میبرد. به این ترتیب، بدون افت محسوس کیفیت، مدل میتواند پاسخهای متنی تولید کند و با کاربران گفتگو کند. تکنیک SmoothQuant نیز در این مسیر به کار رفته است تا تأثیر نقاط پرت (outliers) در پارامترها را کاهش دهد.
- کاهش شدید مصرف حافظه (حدود ۷۵٪ نسبت به مدل کامل)
- اجرای بلادرنگ روی CPU بدون نیاز به GPU
- هزینه کمتر زیرساخت برای کسبوکارها
- پشتیبانی از مدلهای متنباز و قابل شخصیسازی
تجربه کاربری در عمل
آزمایشهای انجامشده روی سرورهای Xeon نشان میدهد که Q8-Chat میتواند در پاسخگویی تعاملی عملکرد خوبی داشته باشد. سرعت پردازش به حدی است که کاربران حس میکنند با یک سرویس آنلاین مبتنی بر GPU کار میکنند. این نویدبخش آیندهای است که در آن هوش مصنوعی مولد دیگر انحصاراً به سختافزارهای گرانقیمت وابسته نیست و شرکتهای کوچکتر هم میتوانند از آن بهرهمند شوند.
در مجموع، Q8-Chat گامی مهم در دموکراتیزه کردن هوش مصنوعی است. با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ را میتوان روی پردازندههای در دسترس اجرا کرد و راههای جدیدی برای پذیرش گسترده این فناوری گشود. این تحول در وبلاگ Hugging Face مستند شده و میتواند نقطه عطفی برای اجرای مدلهای مولد در محیطهای سازمانی باشد.
پرسشهای پرتکرار
آیا Q8-Chat فقط روی Xeon کار میکند؟
طبق پست اصلی، این مدل برای سرورهای Xeon اینتل بهینهسازی شده و به کمک کوانتیزاسیون ۸ بیتی اجرا میشود، اما اصول کوانتیزاسیون قابل تعمیم به سختافزارهای دیگر است.
کوانتیزاسیون چه فایدهای دارد؟
کوانتیزاسیون باعث کاهش حجم مدل و نیازهای سختافزاری میشود و سرعت پردازش را روی CPU بالا میبرد، که در نهایت هزینههای زیرساخت را به شکل چشمگیری کاهش میدهد.