سرعتبخشی مدلهای BERT با پردازندههای Intel
مدلهای BERT و همترازانشان در حال حاضر بهعنوان الگویی متداول در وظایف پردازش زبان طبیعی شناخته میشوند، اما اجرای این مدلها معمولاً بستگی به GPU دارد. با پیشرفتهای اخیر در معماریهای CPU و معرفی دستورات ویژهای مانند AVX‑512 و VNNI، امکان راندمان بالا بر روی سرورهای مبتنی بر Intel بهکار گرفته میشود.
چالشهای اجرایی در مدلهای مشابه BERT
از جمله محدودیتهای اصلی در اجرای مدلهای ترنسفورمر بر روی CPU میتوان به مصرف حافظه، تداخل صفهای محاسباتی و زمان پردازش طولانی اشاره کرد. بهاین ترتیب، روشهای خاصی برای مدیریت حافظه و موازیسازی مناسب ضروری میشوند.
کسب بهرهوری از فناوریهای Intel
- استفاده از کتابخانههای مدیریت حافظه بهینه جهت کاهش تاخیرهای غیر ضروری.
- فعالسازی دستورهای VNNI و AVX‑512 برای سرعت بخشیدن به عملیات متریسی و ضرب ماتریسی.
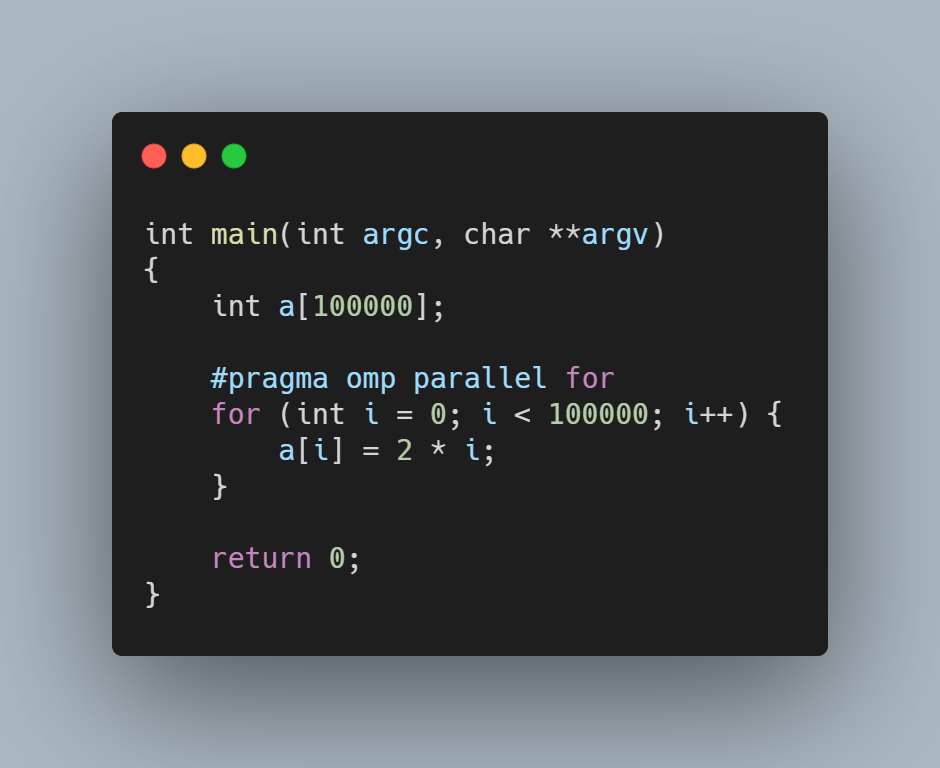
- پیکربندی OpenMP برای توزیع کارها بهطور هوشمندانه بین هستههای CPU.
- استفاده از Bayesian Optimization (SigOpt) برای خودکارسازی تنظیم پارامترهای بهینهسازی.
این ترکیب، اجازه میدهد تا مدلهای مشابه BERT را با دقت بالایی و در زمانهای کوتاه از یک پردازندهٔ استاندارد اجرا کنیم، بدون نیاز به سختافزارهای گرافیکی گرانقیمت.
پرسشهای پرتکرار
چرا اجرای مدل BERT بر روی CPU ممکن است نسبت به GPU کند باشد؟
بهدلیل پردازش موازی محدود هستهها، مصرف بیش از حد حافظه و عدم وجود دستورات مخصوص ML در معماریهای سنتی، اجرای مدلهای ترنسفورمر بهصورت متوالی و زمانبر است.
چگونه میتوان فعالسازی VNNI را در هستههای Intel اعمال کرد؟
ابتدا نسخهٔ مدرن سیستمعامل و کتابخانههای بر پایه Loop‑Unrolling و VNNI نصب کنید. سپس در زمان کامپایل با استفاده از آرگومانهای '-xMIC-AVX512' و '-fma4' و فعالسازی گزینهٔ VNNI، سختافزار را بهصورت کامل بهرهوری کنید.