
 سختافزار
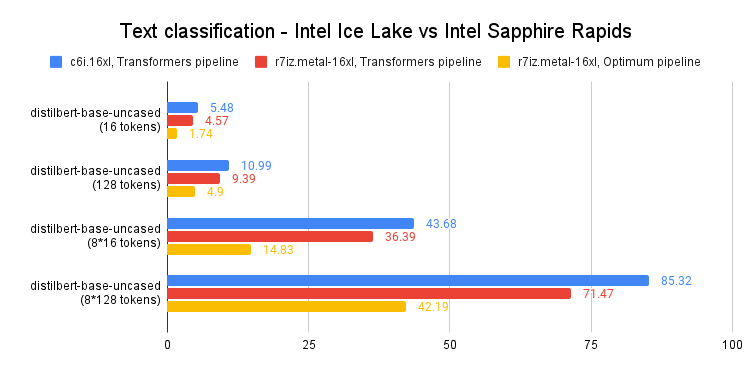
سرعت inference PyTorch با پردازندهٔ Intel Sapphire Rapids برتر
در این مقاله، سرعت inference مدلهای NLP بر پایه PyTorch را در سرورهای Intel Sapphire Rapids و Ice Lake میسنجیم و نکات عملی برای بهرهبرداری را بررسی میکنیم.
 سختافزار
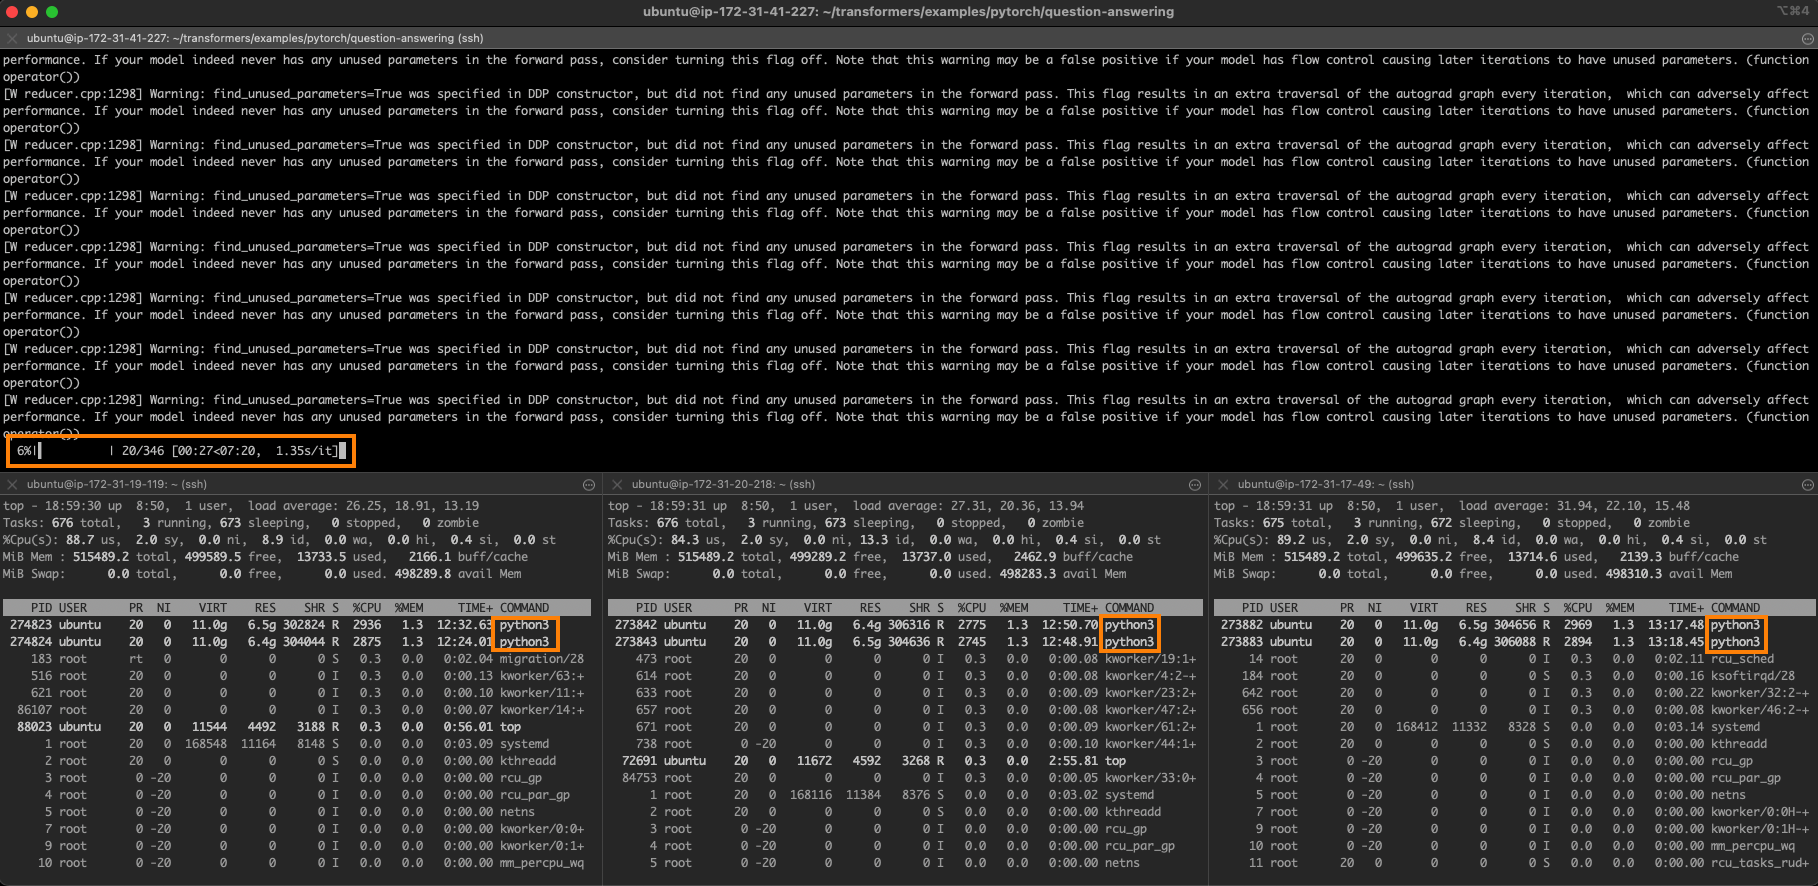
هوش مصنوعی در سرورهای Intel Sapphire Rapids: 2 برابری سرعت یادگیری ماشین
سرورهای جدید Intel Sapphire Rapids با دستورات ویژهی متریس پیشرفته، یادگیری عمیق در PyTorch را دو برابری سرعت میکنند. در این مقاله، به تفصیل بهینهسازیهای IPEX و CCL پرداخته میشود.
 پژوهش
هوش مصنوعی: کشف جزئیات نظامهای پشتزمینه در OpenAI
مقالهای جامع در مورد معماریهای بکاند OpenAI است، که به نقش مهندسین سوپرکامپیوتر و تکنیکهای بهینهسازی در سکوهای توزیعشده میپردازد. نکات کلیدی در مدیریت حافظه، مسیریابی و مقیاسپذیری بررسی میشود.
 پژوهش
هوش مصنوعی در حالتهای سرعت: بهینهسازی دقت بالا در BLOOM با Hugging Face
در این گزارش، تیمهای Open Source بهینهسازی سرور پیشبینی مدل BLOOM را انجام دادند؛ عملکرد 5 برابر سریعتر و 50 برابر قدرتمندتر بهدست آمد.
 پژوهش
پیشآموزش BERT با Hugging Face و Habana Gaudi در حوزه هوش مصنوعی
در این مقاله، چگونگی پیشآموزش مدل BERT‑Base بهصورت کامل از صفر با استفاده از کتابخانههای Hugging Face Transformers، Optimum Habana و Datasets بر روی سرور Habana Gaudi توضیح داده میشود.
 پژوهش
سرعتسنجی BERT با AWS Inferentia: راهنمای جامع از هوتینگ فیس
در این مقاله با گامهای عملی، بررسی میکنیم چگونه با استفاده از AWS Inferentia و هوتینگ فیس، مدل BERT را برای تکمیل واضح سرعت ببخشیم و در نتیجه استهلاک و سرورها را به حداکثر برسانیم.
 مدلها
چگونه GPT‑J ۶ میلیارد پارامتر را بر روی ساجمارک خودکار بهکارگیری کنید
GPT‑J ۶ میلیارد پارامتر را با استفاده از کتابخانه Transformers و پلتفرم Amazon SageMaker بهصورت سریع و مقیاسپذیر بر روی سرورهای خود در دسترس میآوریم. راهنمای گامبهگام و نکات کلیدی را بررسی میکنیم.
 پژوهش
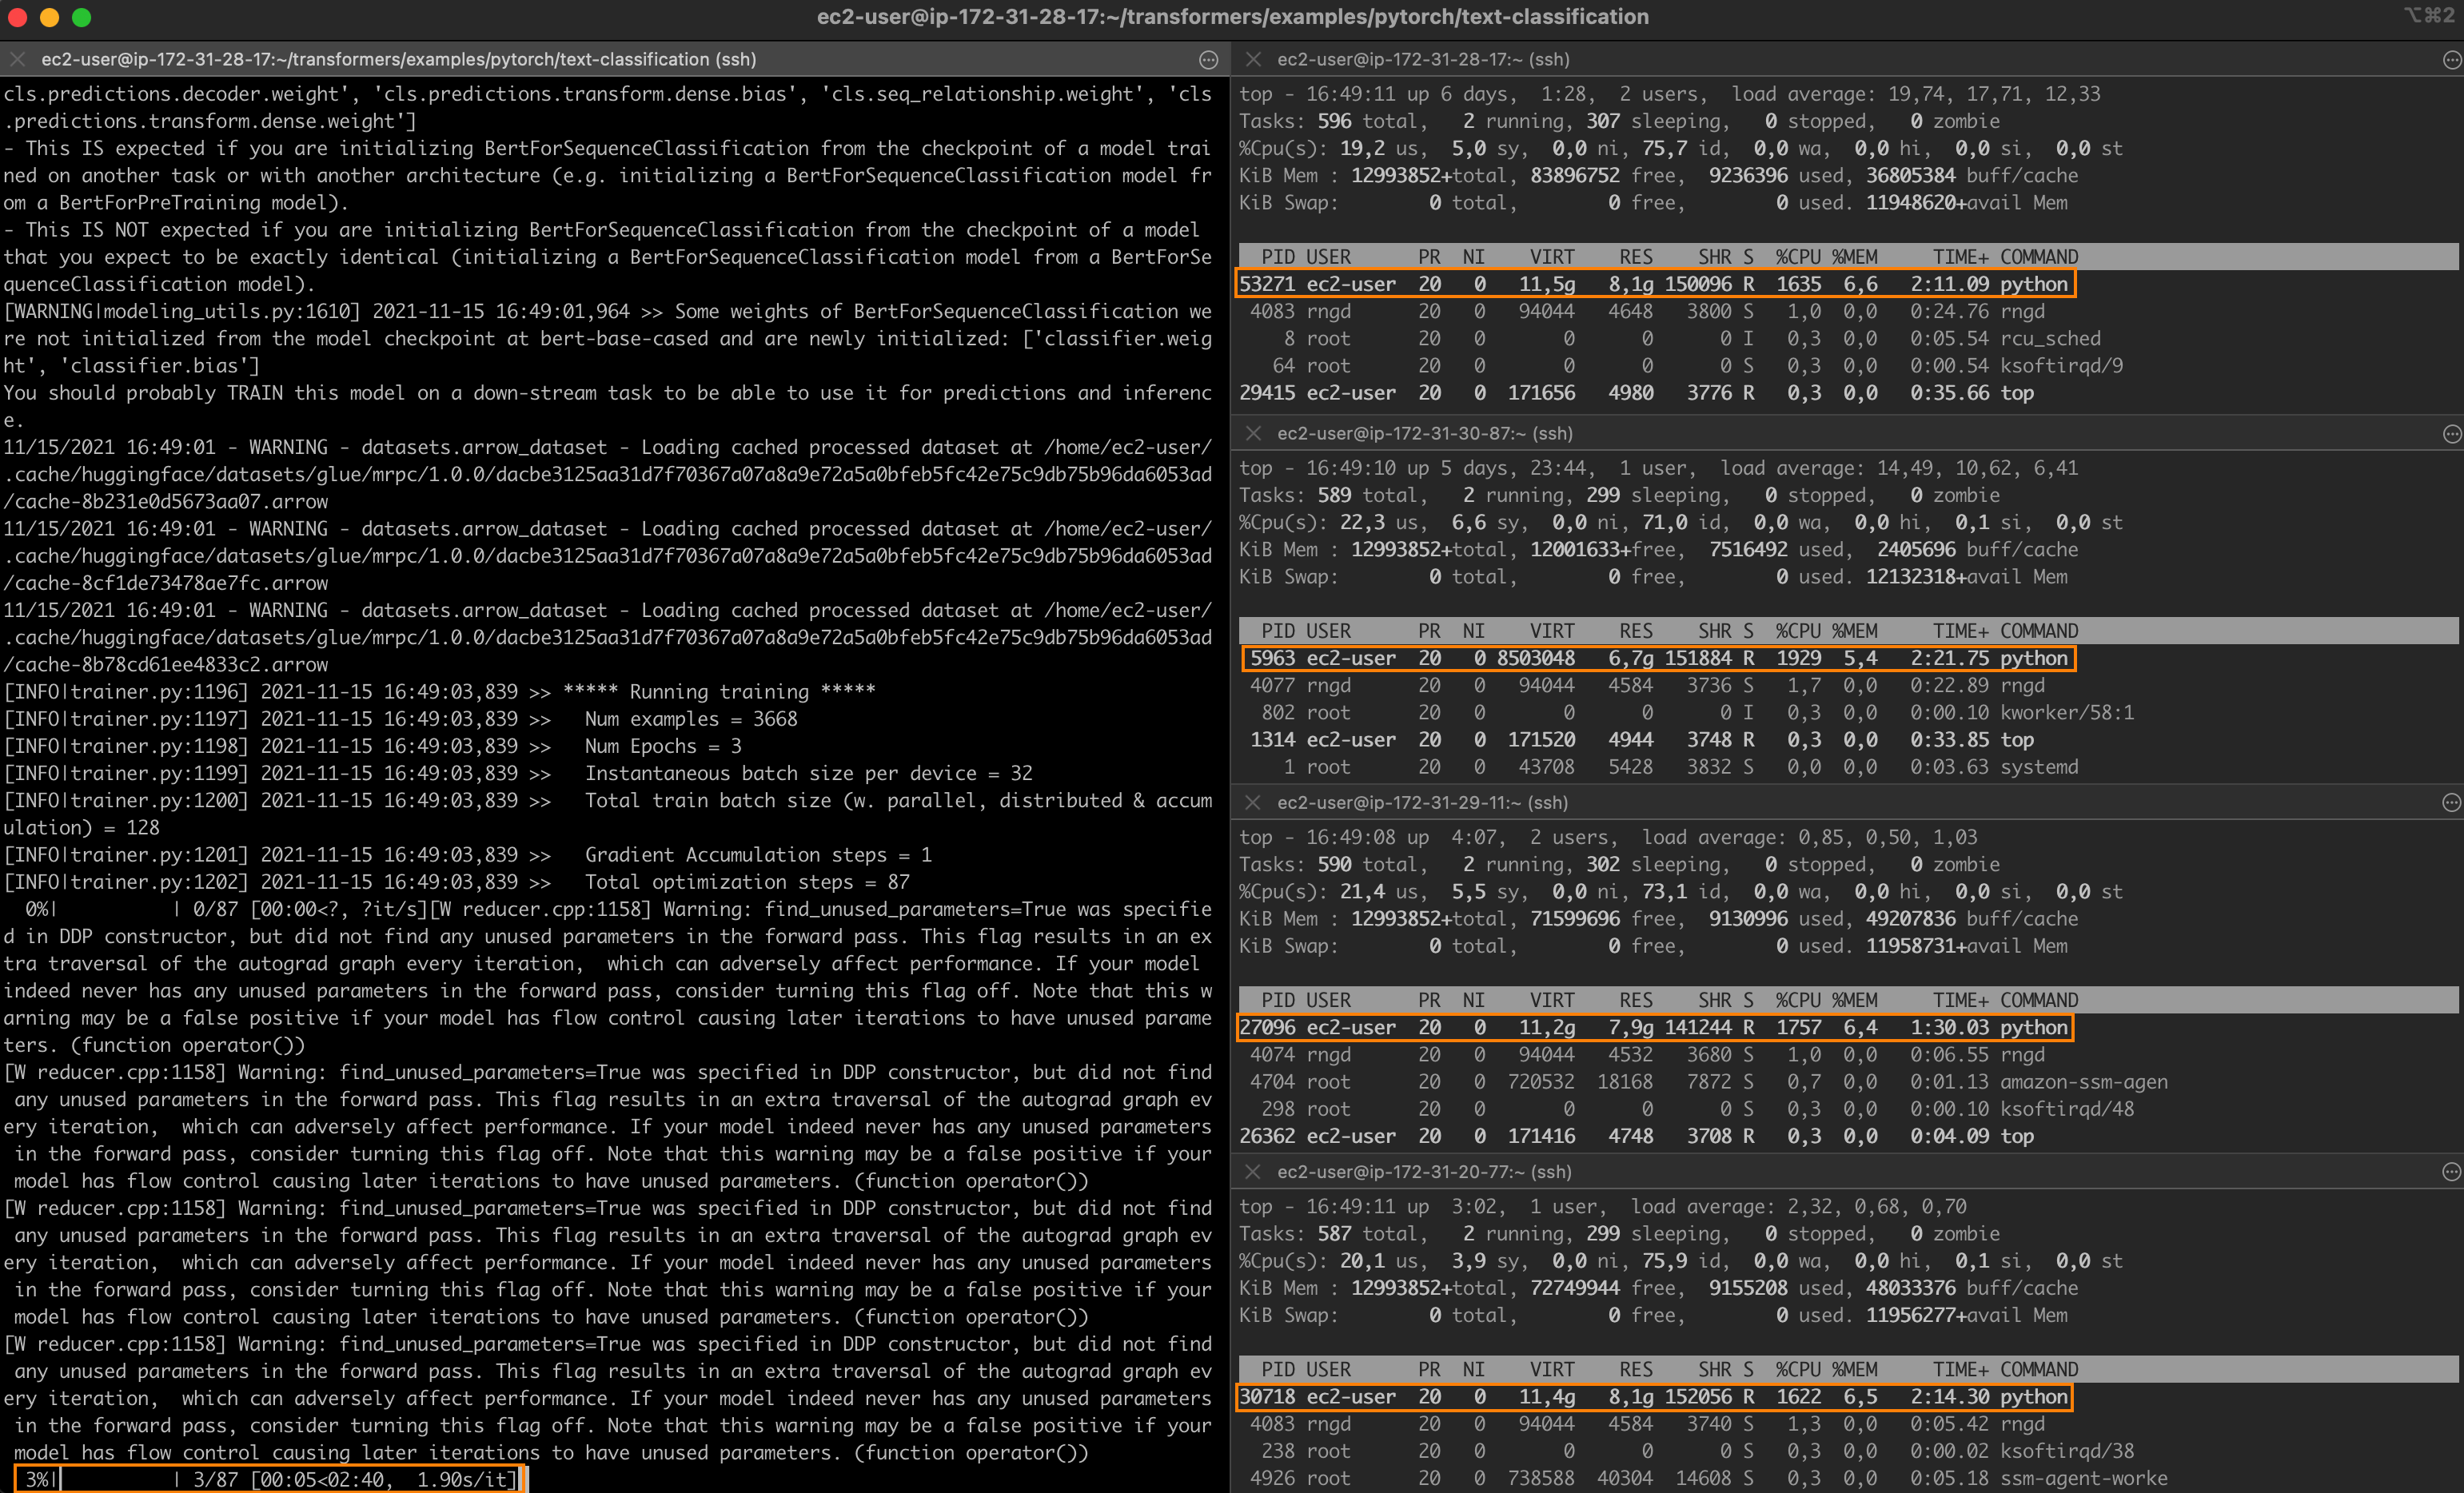
سرعتدادن فرآیند تنظیم دقیق PyTorch با فناوریهای آیندل در هوش مصنوعی
بهخاطر استفاده از سرورهای آیندل و کتابخانههای کارایی، فرآیند آموزش مدلهای PyTorch میتواند با طولانیترین زمانهای یادگیری، به سرعت قابل بهبود برسد
 آموزش
استقرار پایپلاین هوش مصنوعی ترنسفورمرز روی Google Cloud بدون سرور
در این مقاله تجربه استقرار یک پایپلاین تحلیل احساسات با ترنسفورمرز و Google Cloud را میخوانید؛ از انتخاب سرویس مناسب تا هزینهها و عملکرد.