
معرفی پروژه
تحقیقات اخیر در زمینه هوش مصنوعی با بهرهگیری از سرورهای آیندل، سرعت یادگیری مدلهای PyTorch را به طرز چشمگیری افزایش دادند. این بهروزرسانی در راستای گسترش دسترسی به فناوریهای پیشرفته و همکاریهای علمی باز اتفاق افتاده است.
مراحل راهاندازی و توزیع
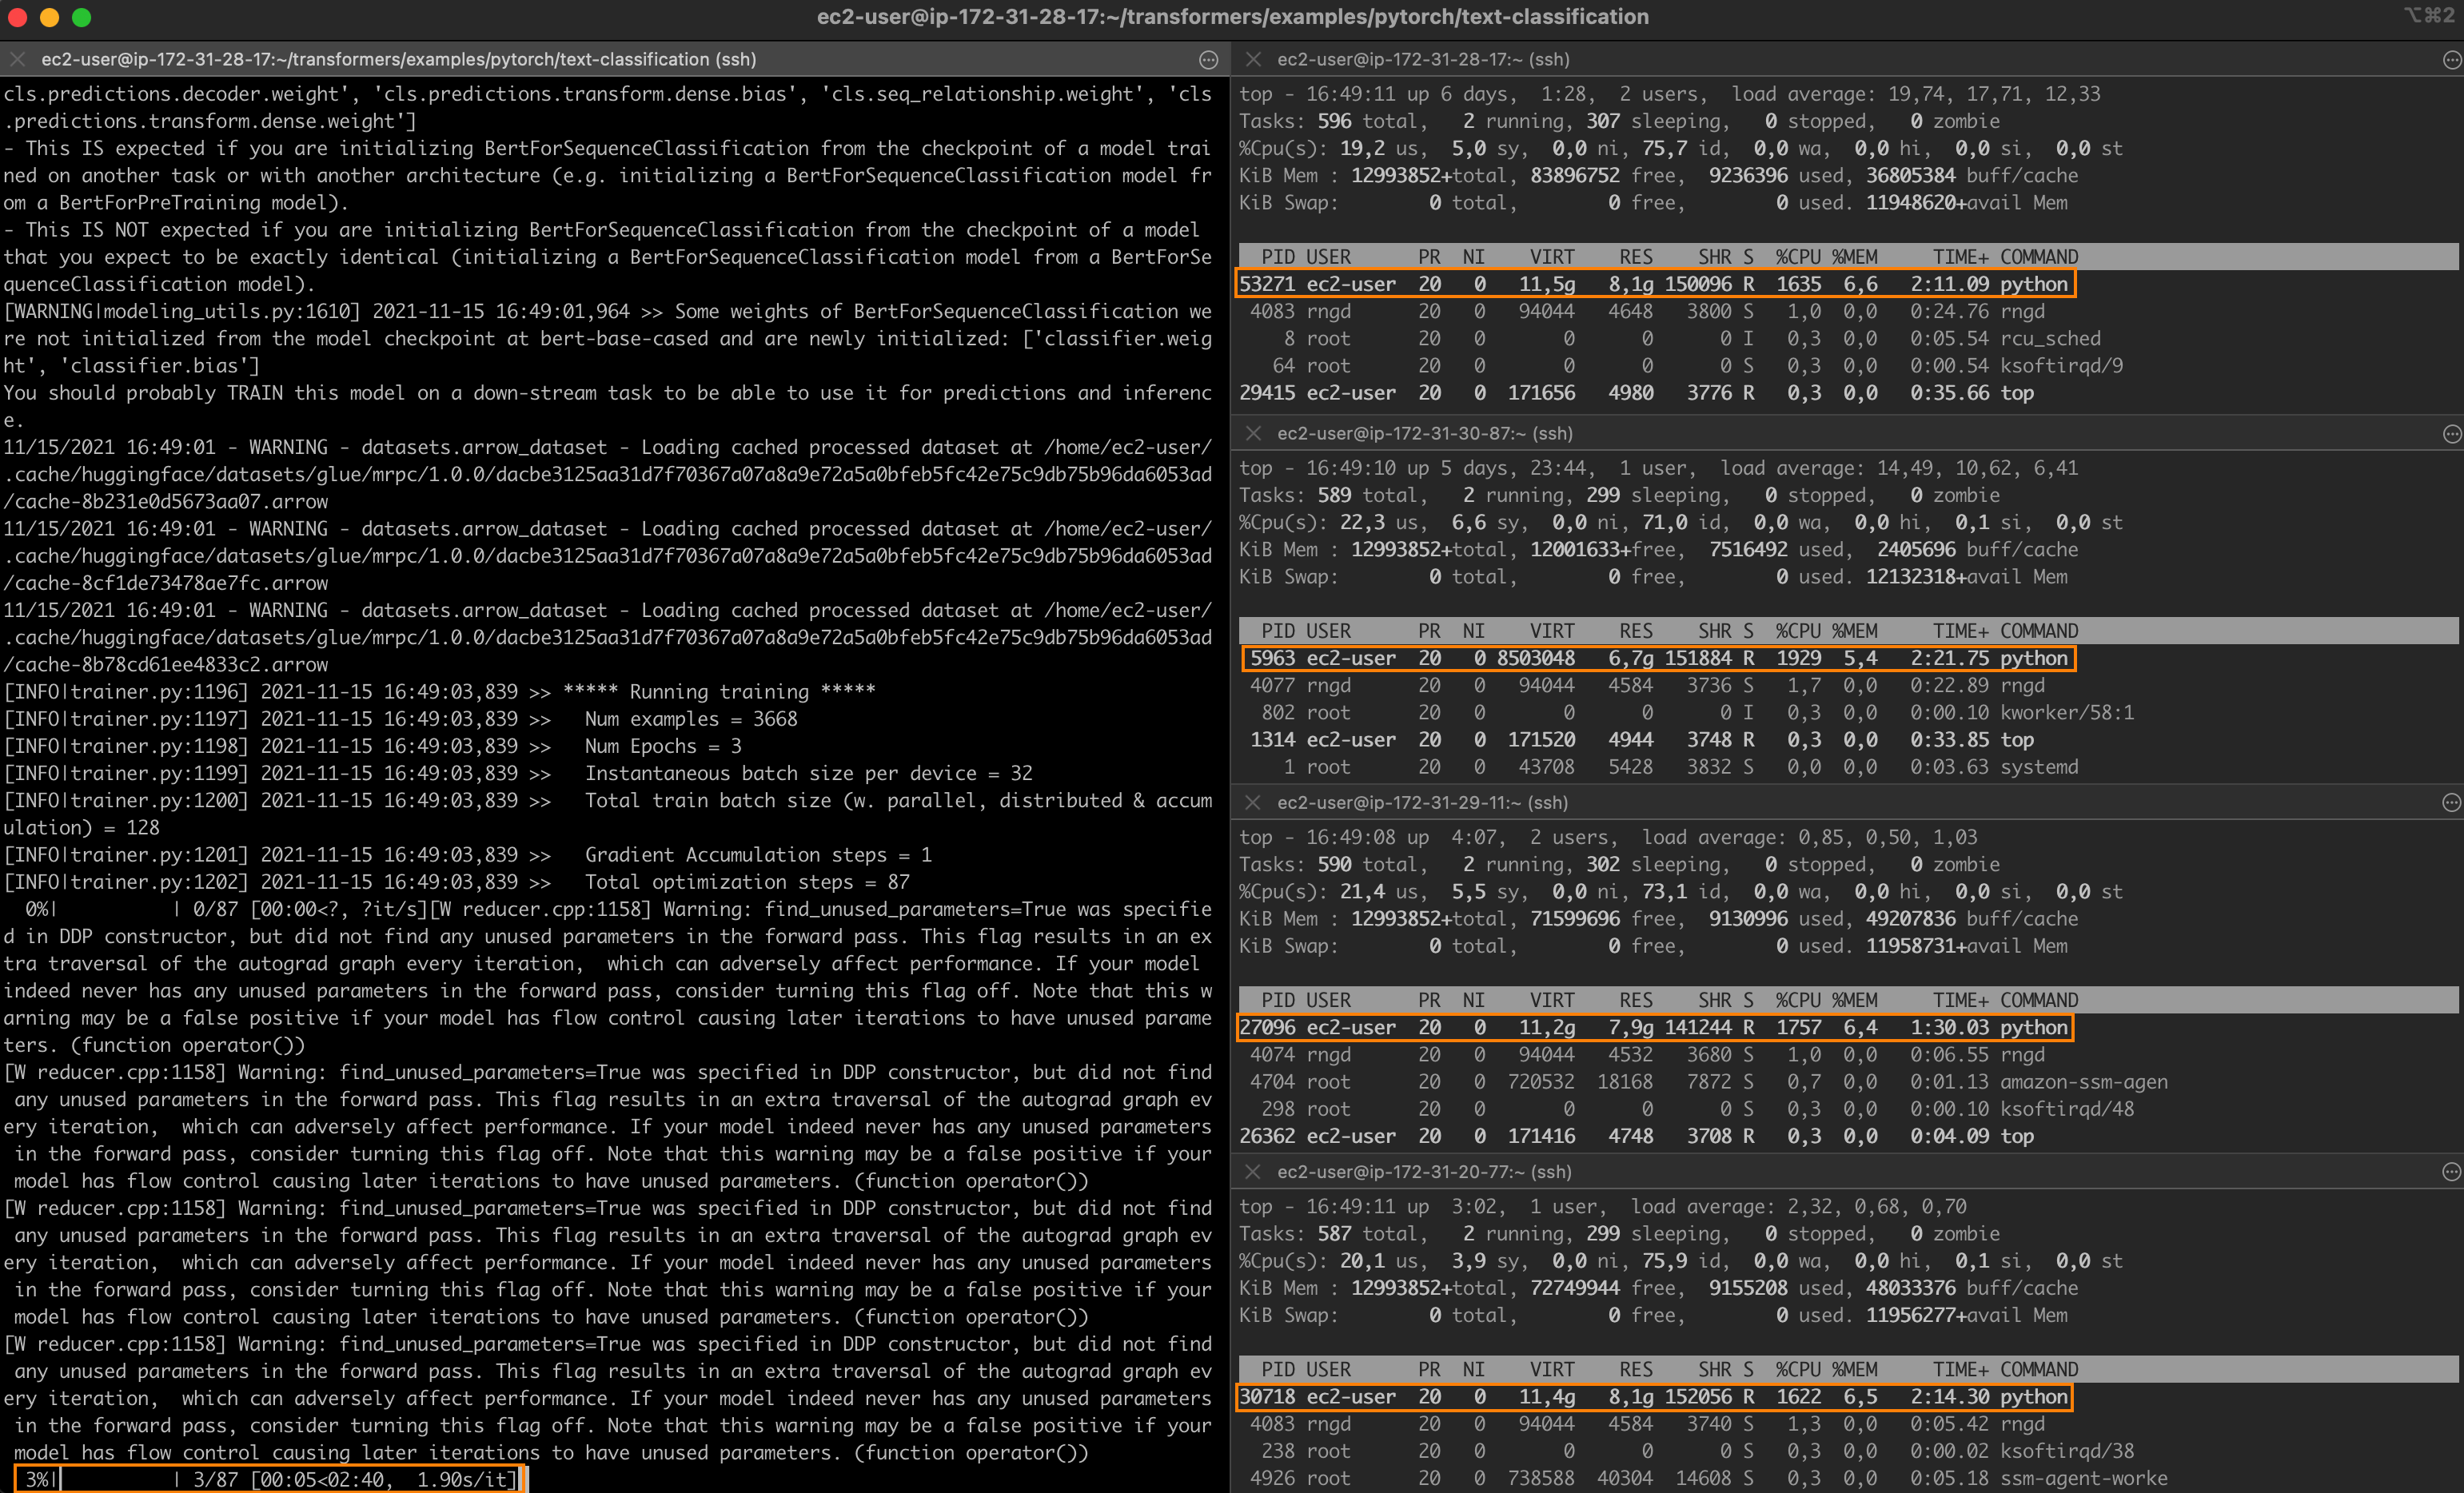
در این پروژه، ابتدا سرورهای آیندل را پیکربندی کرده و کتابخانههای بهینهسازی عملکردی نامدار CCL را نصب کردیم. سپس یک کار یکنُد انجام شد و با تکرار آن، لیلیک توزیع شده روی چندین نود راهاندازی شد.
- نصب سریع کتابخانههای بهینهسازی کارایی
- سازماندهی همزمان ۸ نود در یک کلاستر
- کنترل دقیق و تعویض مدل در زمان واقعی
نتایج و نتیجهگیری
توانایی توزیع و بهینهسازی آموزش، باعث شد که زمان مورد نیاز برای تنظیم دقیق مدل به نسبت یک کلاستر CPU یا GPU عادی، کاهش یابد. این دستاورد سهم مهمی در تسهیل تحقیق و بهکارگیری مدلهای مناسب برای کارهای خاص به عهده دارد.
پرسشهای پرتکرار
چرا از آیندل در یادگیری ماشین استفاده میکنیم؟
سرورهای آیندل با معماری پردازندههای فوقالعاده پردازشی، قابلیتهای گستردهای در بهینهسازی حافظه و الگوریتمهای موازی ارائه میدهند که برای آموزش مدلهای بزرگ در هوش مصنوعی ضروری هستند.
کدام ابزارها در این پروژه به کار رفتهاند؟
در این پروژه از کتابخانههاییستری-سایند CCL، کوانتوئِر، و سرویسهای میکروسرویس کلاستر شده توسط Docker و Kubernetes برای مدیریت سرورهای آیندل بهره گرفتیم.


