
 محصولات
TRL v1.0 منتشر شد: تحولی در آموزش پسین مدلهای هوش مصنوعی
TRL v1.0 با پشتیبانی از بیش از ۷۵ روش آموزش پسین، به ابزاری پایدار برای تولید تبدیل شده است و طراحی آن برای حرکت با نیازهای میدان تکامل مییابد.
 پژوهش
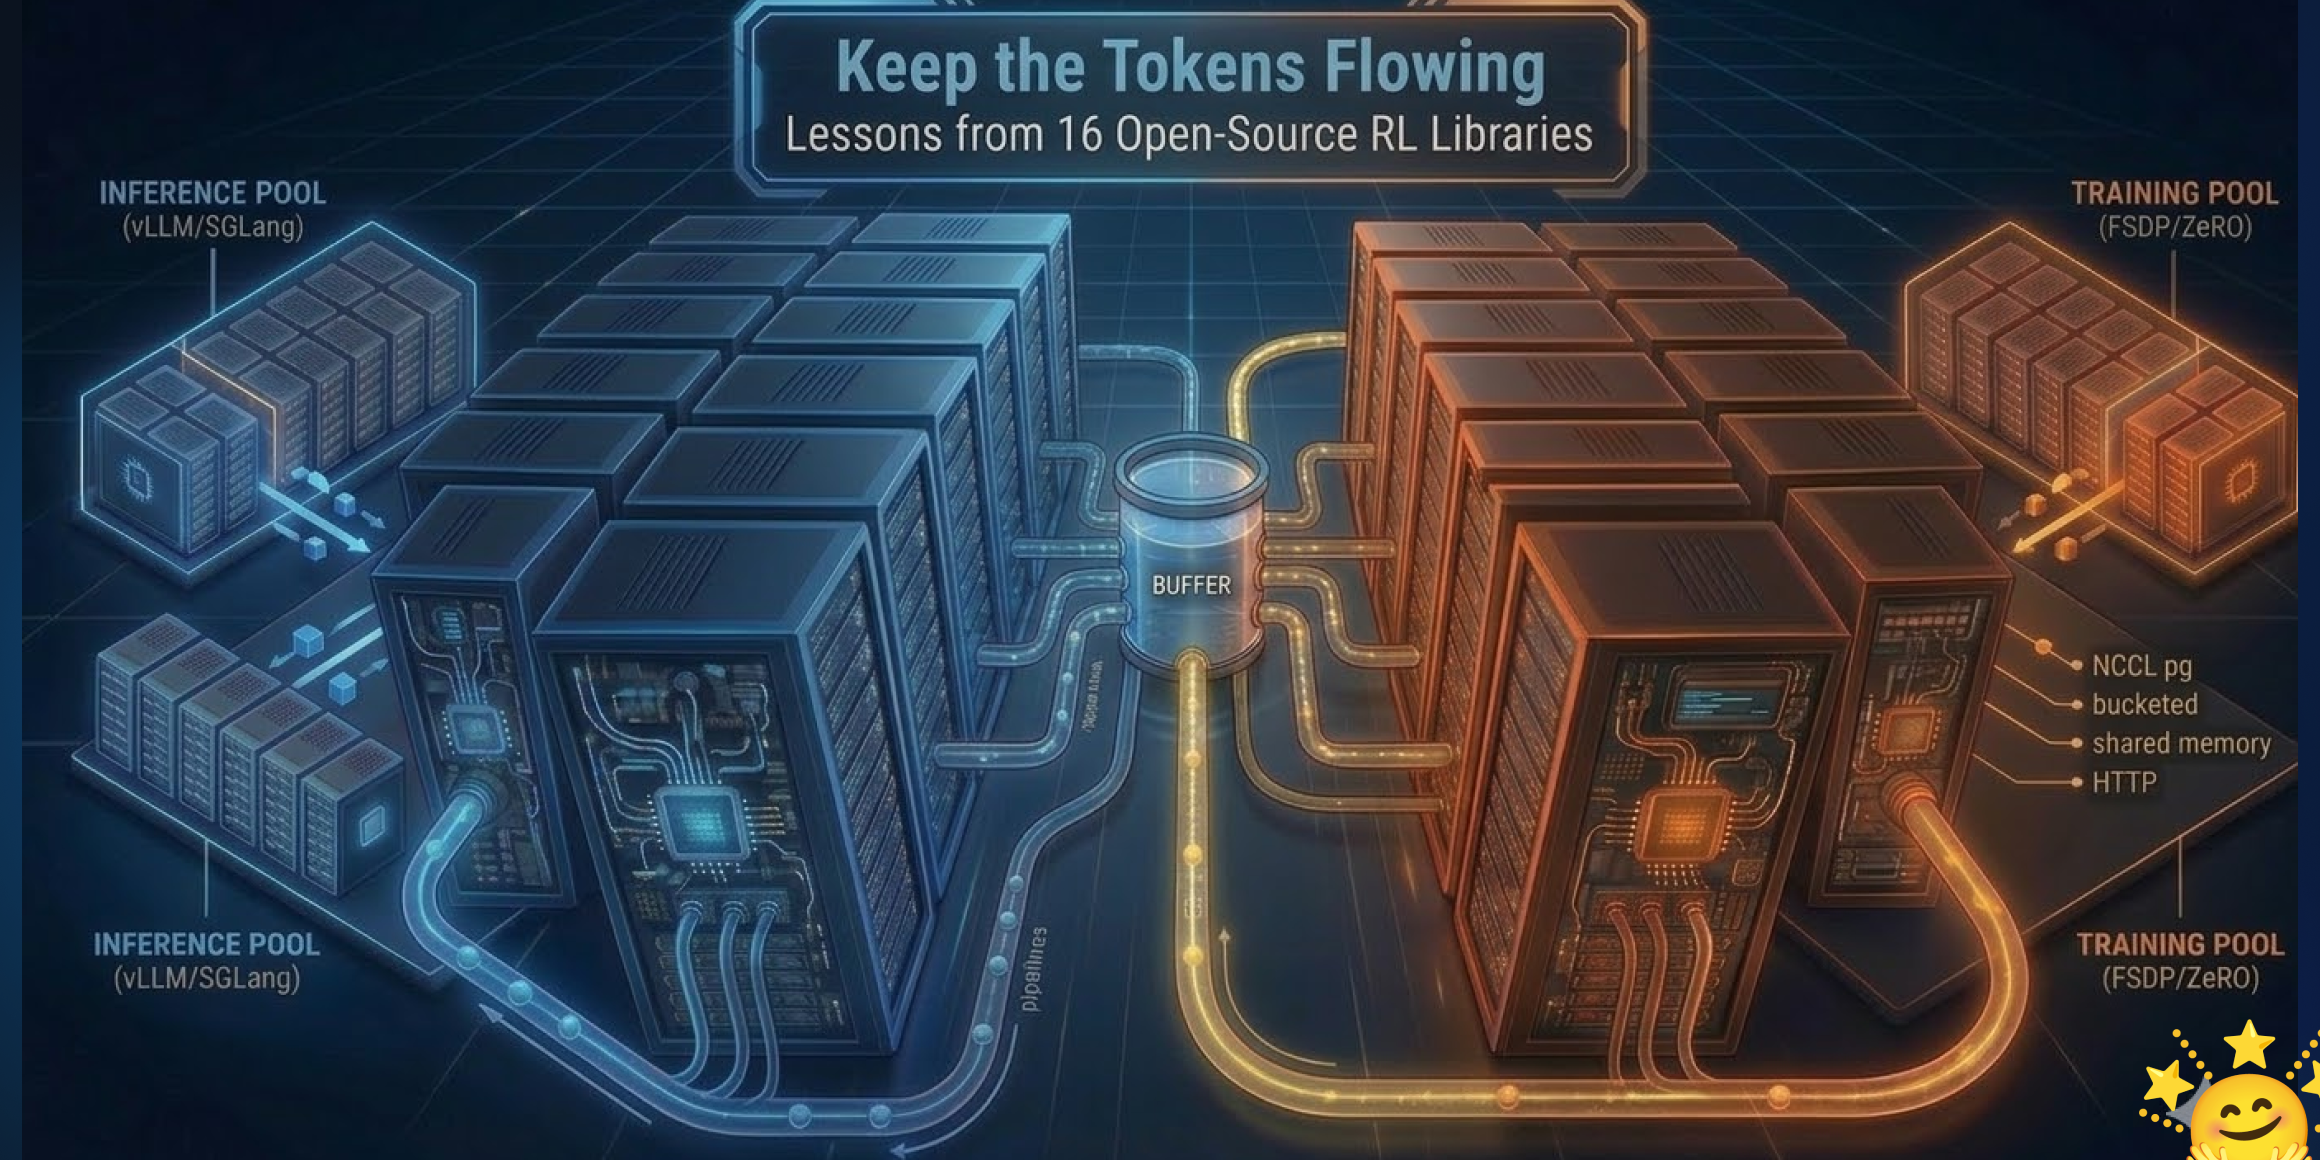
هوش مصنوعی: در وادی 16 کتابخانه RL متن باز نکات کلیدی
کاربردهای یادگیری تقویتی در فضای متن باز؛ بررسی 16 کتابخانه RL و نکاتی برای بهینهسازی مصرف GPU، طراحی معماریهای ناهمزمان، و تأثیر آن بر مقیاسپذیری.
 پژوهش
هوش مصنوعی در GPT-OSS: کشف آموزش RL عاملانه و کاربردهای عملی
مقاله فوری درباره استفاده از RL عاملانه در GPT-OSS، مشکلات و راهحلهای میدانی از تنظیم دقیق و همگامسازی MoE با FlashAttentionV3.
 اخبار
هوش مصنوعی Waypoint-1: انقلابی در ساخت ویدیوی تعاملی بلادرنگ
مدل Waypoint-1 از Overworld با یادگیری از ۱۰ هزار ساعت ویدیوی بازی، دنیای قابل تعامل با صفحهکلید و موس میسازد. وزنهای آن در Hugging Face منتشر شد.
 محصولات
20 برابر سریعتر! RapidFire AI: فاین‑تینینگ مدلهای هوش مصنوعی به سرعت 20×
RapidFire AI با یکپارچهسازی خود با Hugging Face TRL، امکان فاین‑تینینگ مدلهای زبانی را در زمان چندین برابر سرعتسازی میکند؛ در آزمایشهای داخلی به دست آوردن 16‑24× تسریع در مقایسه با روشهای متوالی.
 پژوهش
هوش مصنوعی در رباتیک: انتشار LeRobot v0.4.0 با امکانات جدید
LeRobot v0.4.0 در رباتیک متنباز، امکاناتی چون Datasets v3.0، مدلهای VLA PI0.5 و GR00T N1.5، و پشتیبانی از شبیهسازی LIBERO و Meta‑World را معرفی میکند.
 پژوهش
هوش مصنوعی در اثبات نظریه: Kimina-Prover-RL و تأثیراتش
Kimina-Prover-RL، یک پایپلاین آموزش بازآفرینی در Lean 4، ترکیبی از استدلال ساختارمند و تولید متن است که قابلیتهای جدیدی برای اثبات خودکار در حوزهی هوش مصنوعی ارائه میدهد.
 پژوهش
هوش مصنوعی در براهین ریاضیات: Kimina-Prover-RL بهعنوان چراغ نیکخورده
کامیابترین پیشرفت در زمینهٔ آموزش ماشین برای اثبات قضایا: Kimina-Prover-RL، یک پایپلاین ارزان و متنباز برای Lean 4 که امکان بهبود اتوماسیون در ریاضیات را دارد.
 پژوهش
هوش مصنوعی: نحوه همسو سازی مدلهای دید-زبان در TRL جدید و بهروز
در این مقاله به بررسی روشهای نوین همسو سازی مدلهای دید‑زبان در فریمورک TRL پرداخته، مقایسهای بین MPO، GRPO و GSPO ارائه کرده و کاربردهای عملی در علوم و صنعت را بررسی میکنیم.
 پژوهش
کِمینا‑پروور: هوش مصنوعی «Test‑Time RL» در جستجوی اثباتهای رسمی
مدل برجستهی کِمینا‑پروور با استفاده از جستجوی RL در زمان آزمون، پیشرویهای جدیدی در حل مسئلهی خودکار ریاضیات و منطق معرفی میکند. مزایا، روش و کاربردهای آن را بخوانید.