
مقدمهٔ پیشینهٔ یادگیری تقویتی
یادگیری تقویتی (RL) بهعنوان یکی از ستون فقرات هوش مصنوعی، بهاستانی در حال رشد است. اما همانگونه که مجتمعهای داده و مدلهای بزرگ پیچیدهتر میشوند، روش سنتی آموزش همزمان با حلقههای بلاککننده نتایج مطلوبی در مقیاس واقعی ایجاد نمیکند. در این راستا، پژوهشگران به سمت معماریهای ناهمزمان (async) حرکت کردهاند تا فشار بر GPUها کاهش یابد و بهرهوری زمانی بالاتری حاصل شود.
پرورش سریع کتابخانههای متن باز RL
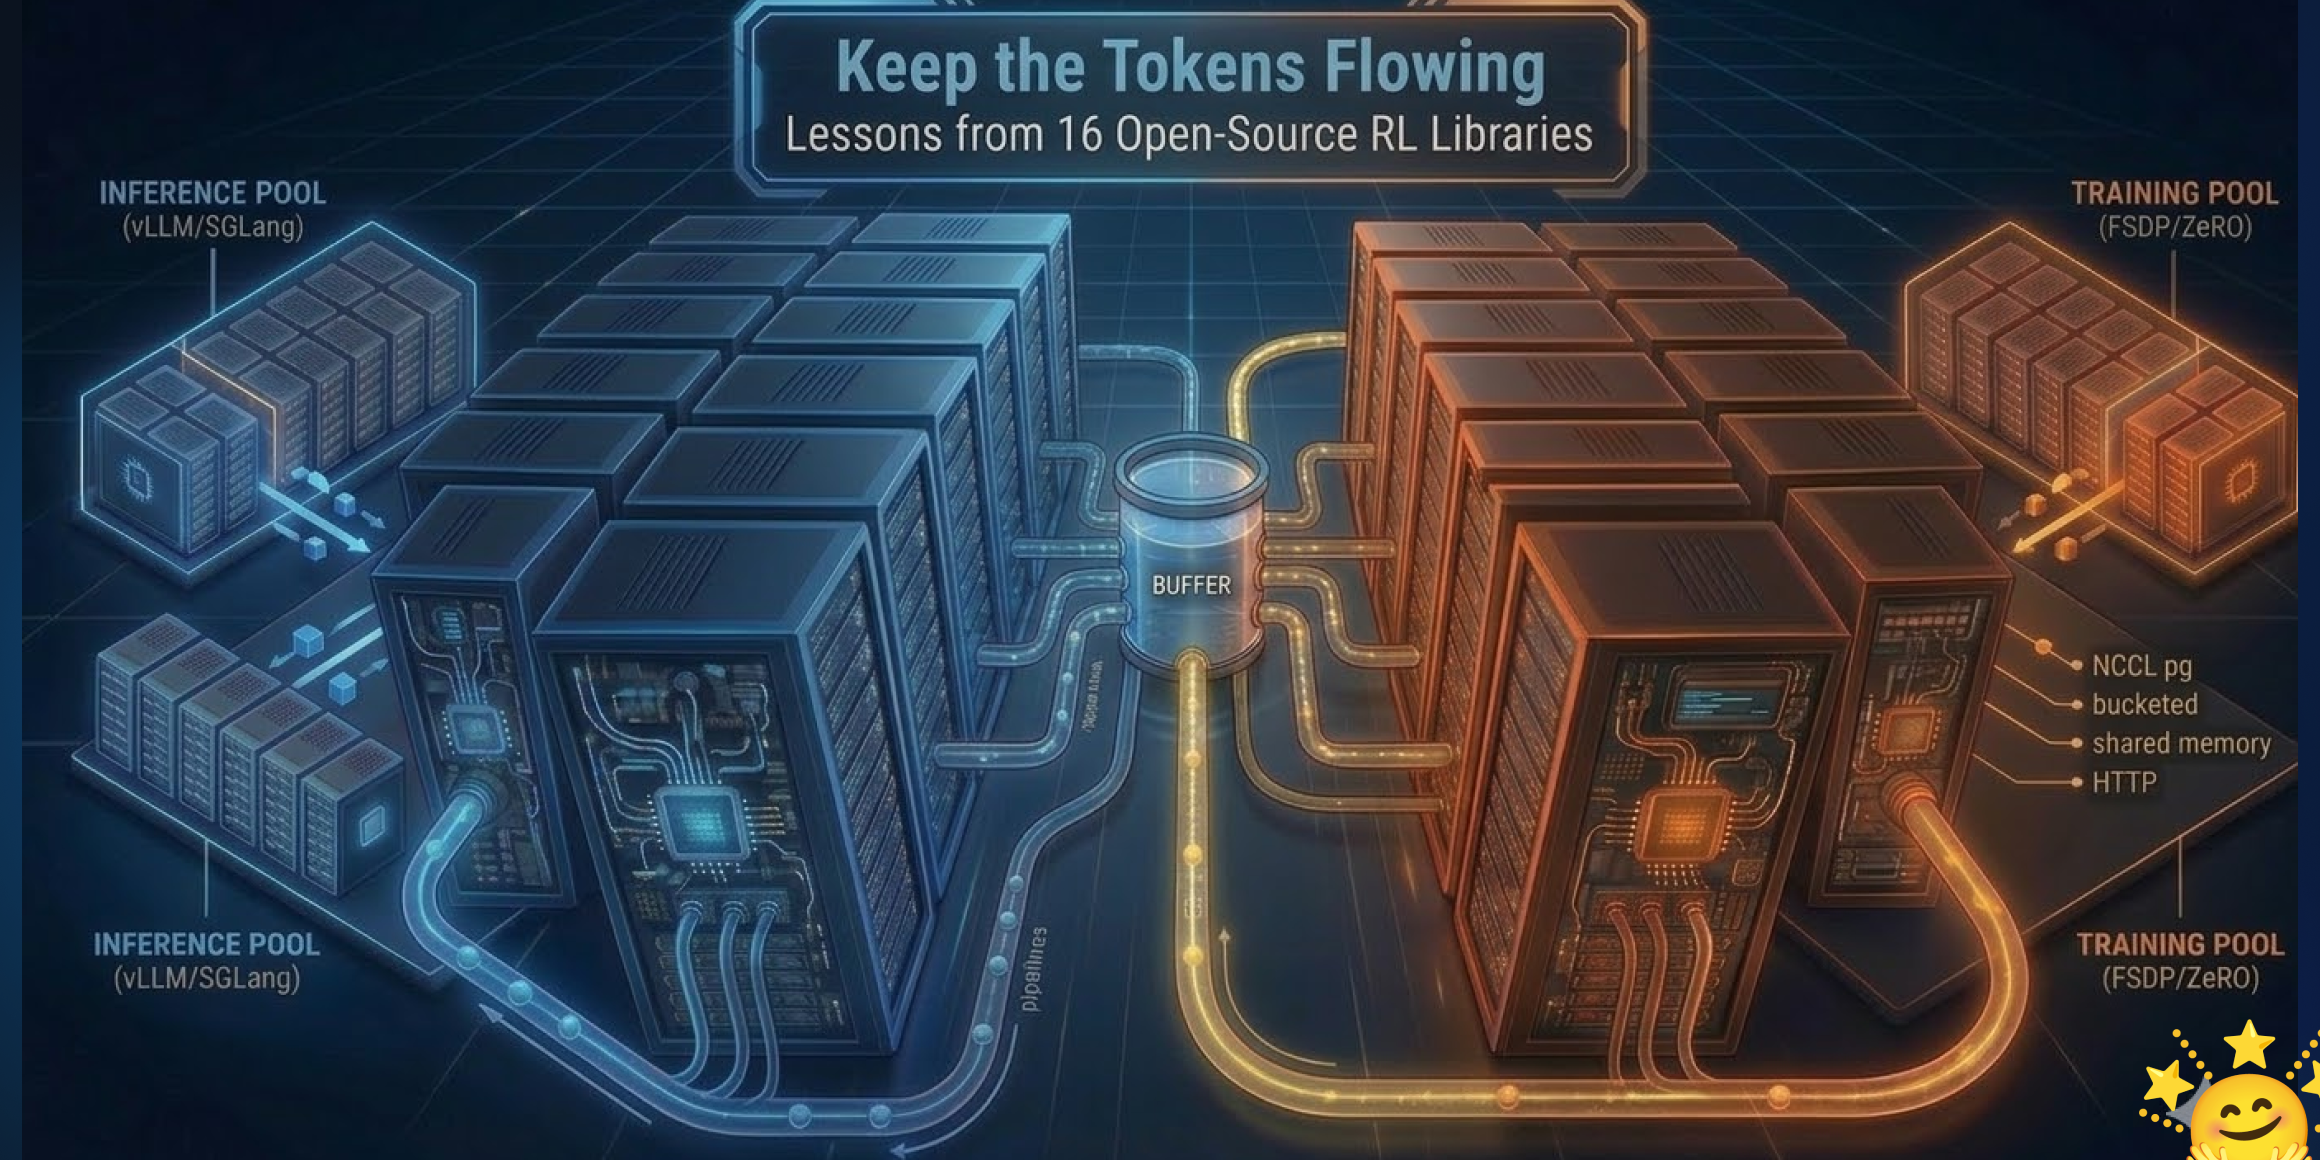
در سال ۲۰۲۶، سایت Hugging Face پست تبلیغاتی به نام «Keep the Tokens Flowing: Lessons from 16 Open-Source RL Libraries» را منتشر کرد که بهدقت 16 کتابخانهی متن باز RL را مقایسه و نکات کلیدی آنها را استخراج کرده است. این مقاله، نقطهٔ آغاز مذاکراتی دربارهٔ چگونگی ساخت ابزارهای پرکاربرد و قابل دسترس برای جامعهٔ برنامهنویسان و دانشمندان داده را رقم زد.
- کاهش مصرف GPU تا ۶۰٪ در مقایسه با اداری شدن ساختارهای همزمان.
- پشتیبانی از چندین محیط بازی و پلتفرم RL در یک رکورد منظم.
- امکان ادغام سریع با کتابخانههای پردازش متن و تصویر.
- سازگاری ساده با ابزارهای CI/CD و Docker برای مقیاسپذیری سریع.
- بهروزرسانیهای مداوم و جامعهٔ فعال در GitHub برای گسترش ویژگیها.
پیچیدگیهای معماری async و راهکارهای پیشنهادی
مرکز اصلی مقایسه این کتابخانهها، سازههای معماری async بود؛ بهعنوان مثال، محدودیتهای زمانبندی دستورات، برقراری ارتباط بین عامل و محیط، و توزیع مناسب دادهها در میان گرههای مختلف. نتایج از پژوهشگران نشان میدهد: با بهینهسازی روشهای “worker–experience–managers” و استفاده از صفهای سهبرابر، میتوان تا ۳× بیش از سرعت ساختارهای همزمان به دست آورد.
نکات عملی برای توسعهدهندگان
اگر میخواهید یک پروژه RL با استفاده از کتابخانه متن باز را راهاندازی کنید، حتماً به نکات زیر توجه کنید:
- از ماژولهای “gymnasium” یا “wrappers” برای جبران مختل شدن معماریهای ساختاری استفاده کنید.
- کاربرد “torch.distributed” برای پارالل کردن ترکیب تجربیات (experience replay).
- سازماندهی حاکی از روندهای جدید به صورت continuous integration و استقرار در سرورهای GPU.
- نگهداری مستندات در قالب Markdown در داخل مخزن برای راحتی استفاده از دیگران.
نتیجهگیری
ارائهٔ 16 کتابخانه RL متن باز، قدمی بزرگ در جهت آسانتر کردن دسترسی به ابزارهای پیچیده یادگیری تقویتی بود. این پست نه تنها مزایای معماری async را نشان داد، بلکه مثالهای عملی و پیادهسازیهای در دسترس برای پیشرفتهترین کاربران در دسترس قرار داد، که باعث میشود توسعهدهندگان بتوانند با مصرف کم کد، به نتایج با کیفیت بالاتر دست یابند.
پرسشهای پرتکرار
آیا میتوانم چند کتابخانه RL را همزمان در یک پروژه استفاده کنم؟
بله، با استفاده از رابطهای سازگار مانند gymnasium میتوانید چند محیط و کتابخانه را در یک پروژه ترکیب کنید، اما بهتر است مدیریت هماهنگی بار روی GPUها را به دقت نظارت کنید.
بهترین راه برای کاهش مصرف GPU در مدلهای RL چیست؟
استفاده از معماریهای ناهمزمان، تقسیم دقیق تجربیات، و فیچرهای “gradient accumulation” کمک میکند تا مصرف GPU کاهش یابد و بهینهسازی زمان اجرا حاصل شود.


