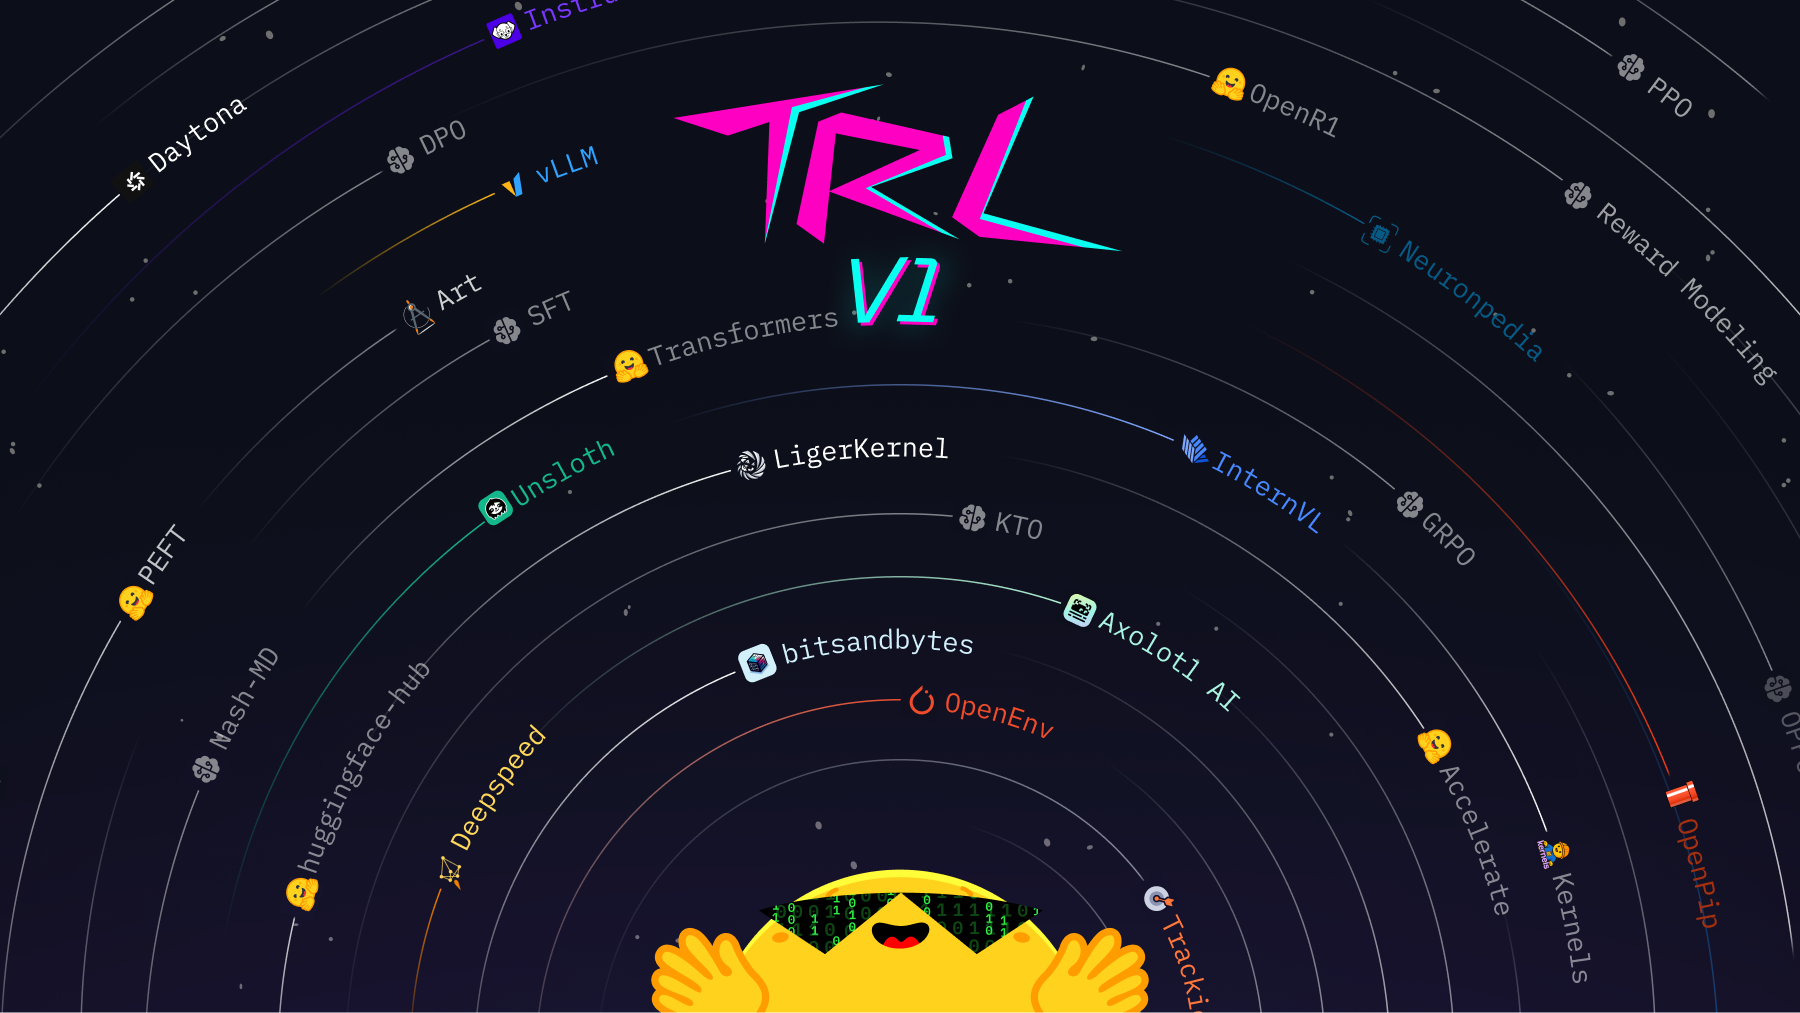
کتابخانه TRL که سالها بهعنوان یک پروژه تحقیقاتی در اکوسیستم Hugging Face شناخته میشد، حالا با انتشار نسخه ۱.۰ به بلوغی تازه رسیده است. این نسخه صرفاً یک بهروزرسانی عددی نیست؛ بلکه بازتعریفی از جایگاه TRL در دنیای هوش مصنوعی است. TRL v1.0 اکنون نهتنها یک ابزار تحقیقاتی، بلکه زیرساختی قابل اتکا برای سیستمهای تولیدی محسوب میشود.
چرا TRL v1.0 نقطه عطفی برای آموزش پسین است؟
آموزش پسین (Post-Training) یکی از حیاتیترین مراحل ساخت مدلهای زبانی است؛ جایی که مدل از یک شبکه خام به دستیاری هوشمند تبدیل میشود. TRL v1.0 با پشتیبانی از بیش از ۷۵ روش آموزشی، این مرحله را برای پژوهشگران و توسعهدهندگان شفافتر و در دسترستر کرده است. با این حال، تمرکز اصلی کتابخانه صرفاً بر تعداد روشها نیست، بلکه بر قابلیت آزمایش، مقایسه و استفاده عملی از آنهاست.
- پشتیبانی از بیش از ۷۵ روش آموزش پسین مانند PPO، DPO و GRPO
- طراحی پایدار برای استقرار در محیطهای تولیدی
- تفکیک شفاف میان قابلیتهای پایدار و آزمایشی
- محدودسازی عمدی انتزاعها برای درک بهتر و انعطاف بیشتر
- یکپارچگی کامل با اکوسیستم Transformers و Datasets
تغییر در طراحی: از پروژه تا قرارداد
پیش از این، TRL بیشتر شبیه یک انبار کد تحقیقاتی بود؛ اما نسخه ۱.۰ این رویکرد را تغییر داده است. توسعهدهندگان حالا با یک قرارداد رفتاری روشن مواجهاند: کدها قابل پیشبینیاند، مستندات کامل است و انتظار پایداری از نسخههای منتشرشده وجود دارد. این تغییر به معنی کاهش انعطاف نیست، بلکه به معنی حرفهای شدن مسیر تکامل کتابخانه است.
یکی دیگر از اصول طراحی نسخه جدید، محدود کردن عمدی انتزاعهاست. بسیاری از کتابخانههای یادگیری ماشین با لایههای متعدد انتزاع، کاربر را از جزئیات دور میکنند؛ اما TRL تلاش کرده تا با شفافیت بیشتر، سازگاری بهتری با نیازهای متغیر میدان ایجاد کند. به همین دلیل، استفاده از آن برای تازهکارها و حرفهایها به یک اندازه میسر است.
TRL در اکوسیستم هوش مصنوعی و مسیر آینده
TRL بخشی از یک زنجیره بزرگتر در اکوسیستم Hugging Face است. از مدلها و دیتاستها گرفته تا ابزارهای ارزیابی، همه بهگونهای طراحی شدهاند که TRL بتواند در کنار آنها به شکلی هماهنگ عمل کند. این کتابخانه حالا نه فقط برای آزمایشهای آکادمیک، بلکه برای استقرار مدلهای زبانی در محصولات واقعی بهکار میرود.
نقشه راه آینده TRL نیز نشان میدهد که این کتابخانه قصد توقف ندارد. از جمله برنامههای پیش رو میتوان به پشتیبانی از GRPO ناهمزمان (Asynchronous GRPO)، ارتقای تدریجی روشهای آزمایشی به وضعیت پایدار، مقیاسپذیری بهتر برای آموزش در مقیاس بزرگ، و شفافسازی فرایند آموزش برای عاملهای خودکار اشاره کرد.
جمعبندی
انتشار TRL v1.0 نشانهای از بلوغ ابزارهای متنباز در حوزه هوش مصنوعی است. این نسخه تعهدی عملی از سوی تیم Hugging Face به جامعه توسعهدهندگان است؛ تعهدی که در آن پایداری، شفافیت و کاربرد واقعی در مرکز توجه قرار گرفتهاند. برای هر کسی که با آموزش پسین مدلهای زبانی سروکار دارد، TRL v1.0 اکنون یک گزینه جدی و معتبر است.
پرسشهای پرتکرار
TRL v1.0 چیست؟
TRL v1.0 کتابخانه متنباز Hugging Face برای آموزش پسین مدلهای زبانی است که با پشتیبانی از بیش از ۷۵ روش و طراحی پایدار، برای محیطهای تولیدی نیز قابل استفاده شده است.
تفاوت اصلی TRL v1.0 با نسخههای قبلی چیست؟
تفاوت اصلی در تغییر ماهیت آن از یک کد تحقیقاتی به یک کتابخانه با قرارداد پایداری است؛ به عبارت دیگر، TRL v1.0 برای تولید واقعی طراحی شده و انتزاعها را بهصورت عمدی محدود کرده تا انعطاف بیشتری داشته باشد.