
 سیاست و قانون
حکمرانی هوش مصنوعی؛ گامی برای آینده ابرهوشمند
OpenAI بر ضرورت تفکر درباره حکمرانی ابر هوش مصنوعی تأکید کرده است. این مقاله به بررسی مفاهیم، چالشها و راهکارهای پیشنهادی در این زمینه میپردازد.
 محصولات
اپلیکیشن رسمی ChatGPT برای آیفون منتشر شد؛ هوش مصنوعی در جیب شما
اپلیکیشن رسمی ChatGPT برای iOS با ورودی صوتی و همگامسازی گفتگوها عرضه شد. جدیدترین مدلهای هوش مصنوعی اکنون در دسترس کاربران آیفون است.
 مدلها
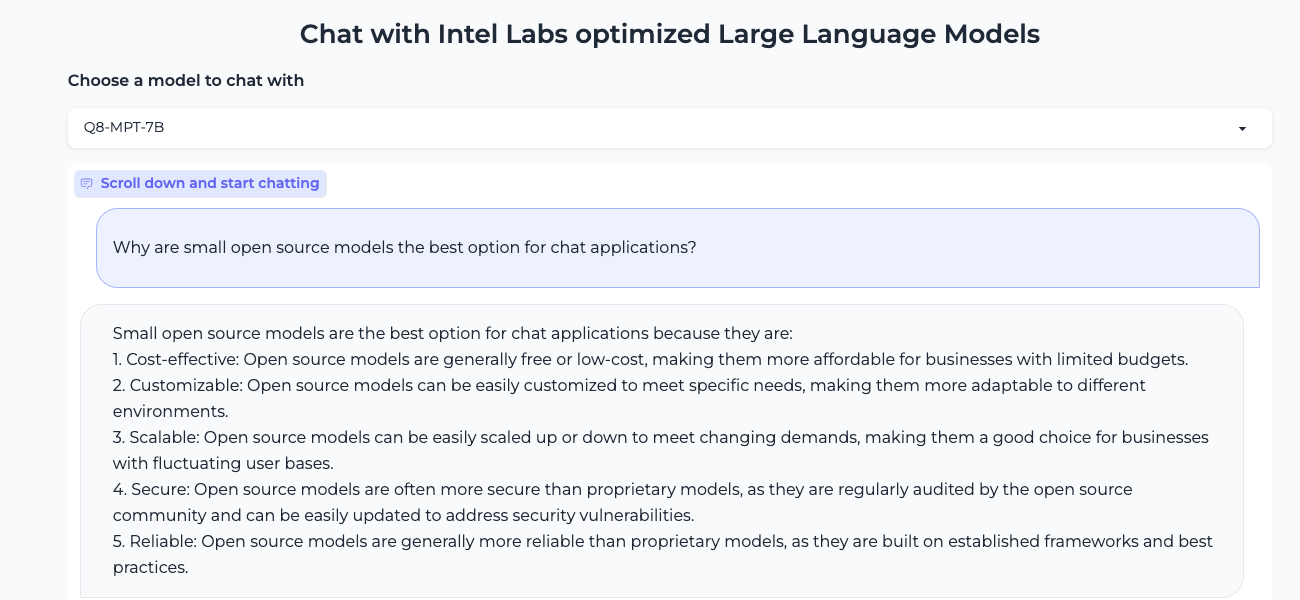
هوش مصنوعی مولد روی CPU؛ معرفی Q8-Chat برای سرورهای Xeon اینتل
با تکنیک کوانتیزاسیون، مدلهای زبانی بزرگ مثل Q8-Chat روی CPU اجرا میشوند؛ راهکاری مقرونبهصرفه برای کسبوکارها بدون نیاز به GPU.
 مدلها
معماری RWKV؛ ترکیب هوش مصنوعی بازگشتی با توانمندی ترنسفورمر
معماری RWKV با ادغام شبکههای بازگشتی (RNN) و ترنسفورمر، راهکاری نوین و کارآمد برای مدلهای زبانی بزرگ ارائه میدهد. در این مقاله به بررسی ویژگیها، کاربردها و آینده آن میپردازیم.
 مدلها
اجرای چتبات شبیه ChatGPT با هوش مصنوعی روی یک GPU AMD؛ ممکن شد
در این مقاله وبلاگ هوش مصنوعی هما، نحوه اجرای مدل Vicuna روی یک کارت گرافیک AMD با فناوری ROCm را بررسی میکنیم. راهکاری مناسب برای ساخت چتبات شبیه ChatGPT
 پژوهش
هوش مصنوعی زبان مدلها را توضیح میدهد؛ گامی به سوی شفافیت
OpenAI با کمک GPT-4 توضیحاتی خودکار برای رفتار نورونهای مدلهای زبانی بزرگ نوشته و دادههای کامل نورونهای GPT-2 را منتشر کرد.
 اخبار
همکاری دیتابریکس و هاگینگ فیس: آموزش مدلهای هوش مصنوعی تا ۴۰٪ سریعتر
دیتابریکس با افزودن پشتیبانی درجهیک اسپارک به هاگینگ فیس، آموزش و تنظیم مدلهای زبانی هوش مصنوعی را تا ۴۰ درصد سریعتر کرده و کد آن را متنباز منتشر میکند.
 سیاست و قانون
ChatGPT با امکان غیرفعالسازی تاریخچه گفتوگوی هوش مصنوعی در تنظیمات جدید
در ChatGPT، امکان غیرفعال کردن تاریخچه گفتگو به کاربران اجازه میدهد بر روی دادههای خود داشته باشند و فقط گفتگوهای منتخب را برای آموزش مدلها استفاده کنند.
 آموزش
وبلاگ جدید هوش مصنوعی برای چینیها: همکاریمان در دنیای علمی
هَوکفِیفِی با راهاندازی وبلاگ مخصوص فارسیزبانان چینی، مجموعهای از مقالات، دورهها و منابع آموزشی را برای جامعه هوش مصنوعی چینی در دسترس قرار داد و امکان همکاری و یادگیری مشترک را تسهیل میکند.
 پژوهش
سرعتگذاری مدلهای ترنسفورمر به کمک AWS Inferentia2 در هوش مصنوعی
AWS Inferentia2، سختافزار جدید ابری، توانایی شتابزدهسازی مدلهای ترنسفورمر هفینگ فیس را افزایش داده و هزینههای اجرایی را به شکل چشمگیری کاهش میدهد. انطباق با پلتفرم هفینگ فیس امکان استفاده آسان از ترنسفورمری را در پروژههای عملی فراهم میکند.