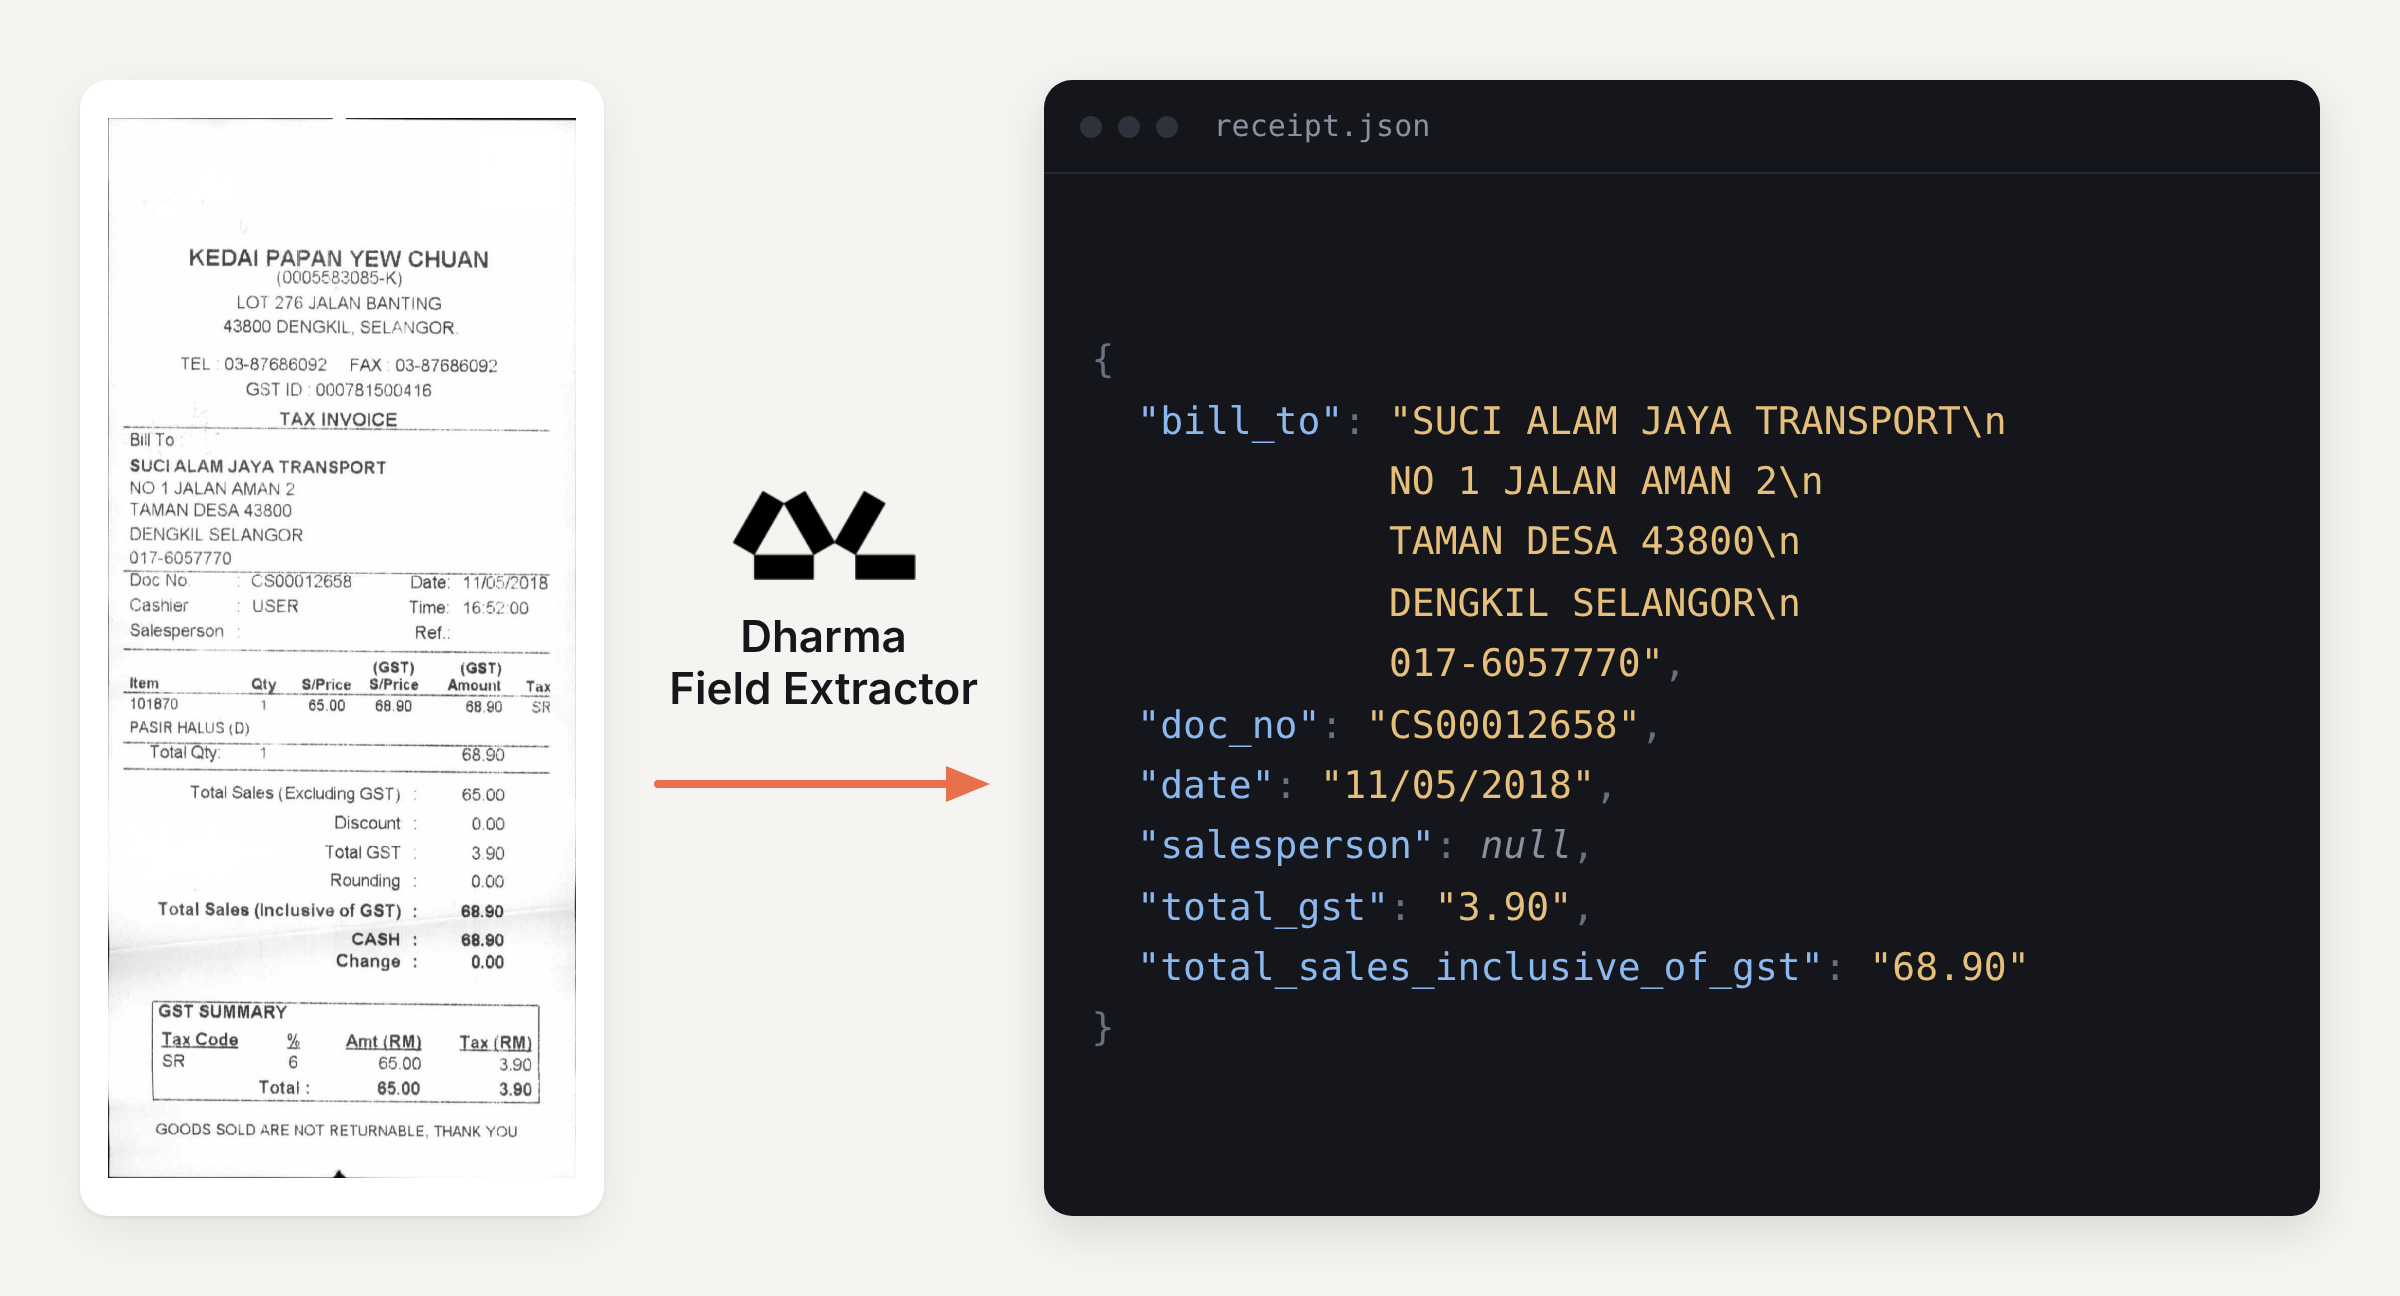
شرکت Dharma-AI با معرفی مدل هوش مصنوعی جدید به نام Dharma Field Extractor، گامی مهم در زمینه استخراج اطلاعات از اسناد مبتنی بر متن برداشته است. این مدل که دارای ۲ میلیارد پارامتر است، طراحی شده است تا از انواع مختلف مدارک، اعم از قراردادها، فاکتورها، هویتنامهها و فرمهای اداری، دقیقاً همان فیلدها و اطلاعاتی که کاربر درخواست داده است را استخراج کرده و به صورت ساختاریافتهای به زبان JSON بازنمایی کند.
تمرکز بر تخصصمندی به جای عمومی بودن
برخلاف مدلهای زبانی بزرگ (LLM) که تلاش میکنند برای هر مسئلهای پاسخ دهند، مدل Dharma بر اساس فلسفه «تخصصمندی» طراحی شده است. این رویکرد از نسخه قبل، DharmaOCR-LITE that در آوریل امسال منتشر شد، ادامه دارد. اگرچه مدلهای عمومی میتوانند در درک کل سند عالی باشند، اما برای استخراج دقیق دادههای مشخص، یک مدل کوچکتر اما تکلیفمحور (مثل Dharma Field Extractor) اغلب دقت بالاتری دارد و خطاهای کمتری ایجاد میکند.
هزینه کمتر، عملکرد بالاتر
یکی از مهمترین مزیتهای این مدل، ترکیب کیفیت بالا و هزینه پایین آن است. در آزمایشهای مقایسهای انجام شده توسط تیم Dharma-AI، این مدل با مقیاس ۲ میلیارد پارامتر، عملکرد خود را در برابر مدلهای پیشرو و بزرگتر بازار بینظیر نشان داد. در حالی که استفاده از API های مدلهای بزرگ برای پردازش حجم بالای اسناد میتواند هزینههای گستردهای داشته باشد، Dharma Field Extractor میتواند این فرآیند را با کسری از هزینه انجام دهد، همانطور که در بنچمارکهای منتشر شده نیز مشهود است.
کاربرد در صنایع مختلف
این قابلیت برای صنایعی که با حجم عظیمی از دادههای متنی سروکار دارند، حیاتی است. از طریق این مدل، سازمانها میتوانند فرآیندهای خودکار کنند:
- استخراج خودکار اطلاعات مشتریان از فاکتورها
- تبدیل اسناد حقوقی به دادههای ساختاریافته برای سیستمهای ERP
- پردازش سریع فرمهای اداری و شناسایی
پیامدهای این نوآوری نشان میدهد که آینده هوش مصنوعی جهت اسناد، نه لزوماً بزرگتر شدن مدلها، بلکه هوشمندتر شده و متناسبسازی آنها با وظایف خاص است.
پرسشهای پرتکرار
مدل Dharma Field Extractor چه تفاوتی با مدلهای OCR عادی دارد؟
مدلهای عادی OCR معمولاً از متن صفحه به عنوان یک کندیت یکپارچه استفاده میکنند. اما Dharma Field Extractor به جای فقط متن، اطلاعات را به صورت فیلدهای ساختاریافته JSON استخراج میکند که برای مصرف توسط دیگر سیستمها مناسب است.
آیا این مدل برای اسناد فارسی نیز کارایی دارد؟
بر اساس اطلاعات اولیه، تمرکز اصلی مدل روی اسناد آنگلیسی بوده است. با این حال، معماری آن برای تنوع اسناد طراحی شده و استفاده از آن برای زبانهای دیگر نیازمند ارزیابی یا فاینتیونینگ جداگانه است.