
 پژوهش
هوش مصنوعی بر روی سرورهای Xeon: SetFit با سرعتشده توسط Intel
SetFit با بهرهگیری از Optimum Intel بر روی پردازندههای Xeon با سرعت بیسابقهای به قضاوتهای چند-خطی دست مییابد؛ مقاله این راهحل و روند بهینهسازی را بررسی میکند.
 مدلها
هوش مصنوعی در حقوق: Harvey و OpenAI، مدل شخصیسازی شده برای وکلا
OpenAI و Harvey یک مدل هوش مصنوعی مخصوص حقوقی طراحی کردهاند تا به وکلا در تحلیل پروندهها با سرعت و دقت بالاتر، بررسی دقیقتر فهرست مستندات، شناسایی نواقص قانونی، و ارائه راهکارهای استراتژیک کمک کند.
 پژوهش
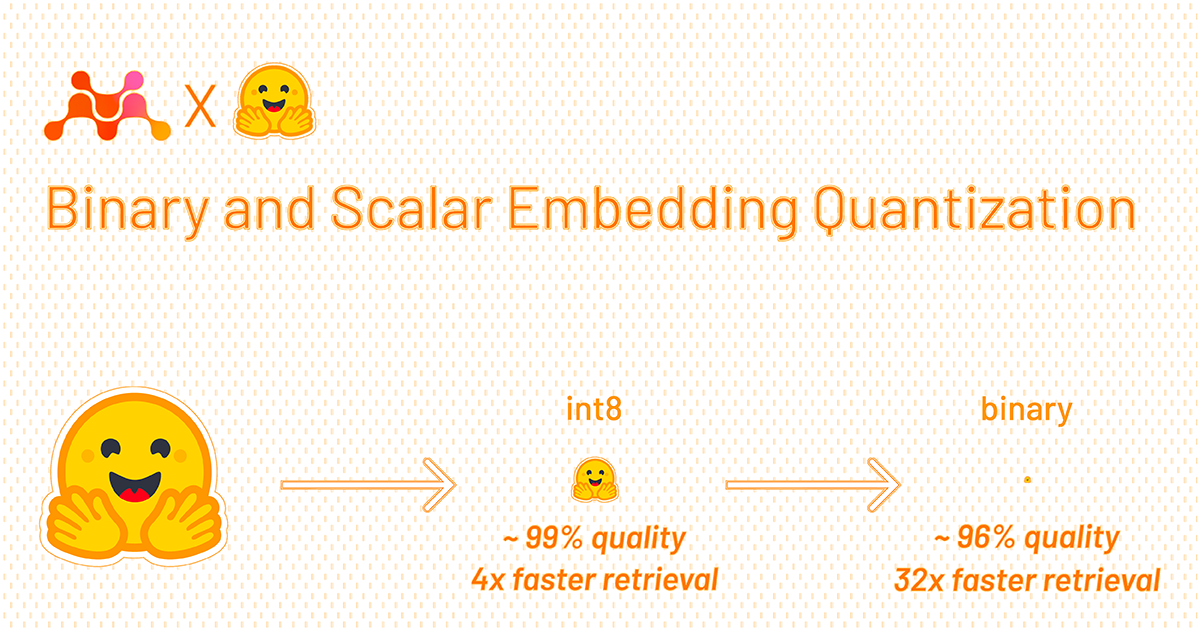
کمتر شدن هزینه و افزایش سرعت بازیابی دادهها با کوانتیزهسازی هوش مصنوعی
Hugging Face روشهای کوانتیزهسازی باینری و اسکالر را برای کاهش بهمراتب مصرف حافظه و افزایش سرعت بازیابی مدلهای ادغام در ۴۱ میلیون سند ویکیپدیا معرفی کرد. این فناوری دموکراتیزاسیون هوش مصنوعی را تسهیل میکند.
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.
 پژوهش
سرعتگذاری پیشرفته SD Turbo و SDXL Turbo با ONNX Runtime و Olive
معرفی بهروزرسانیهای سرعتسازی مدلهای SD Turbo و SDXL Turbo با ONNX Runtime و Olive، اجازه میدهد تا تصاویر گرافیکی در کمتر از یک گام، در محیطهای C# و Java ایجاد شوند.
 پژوهش
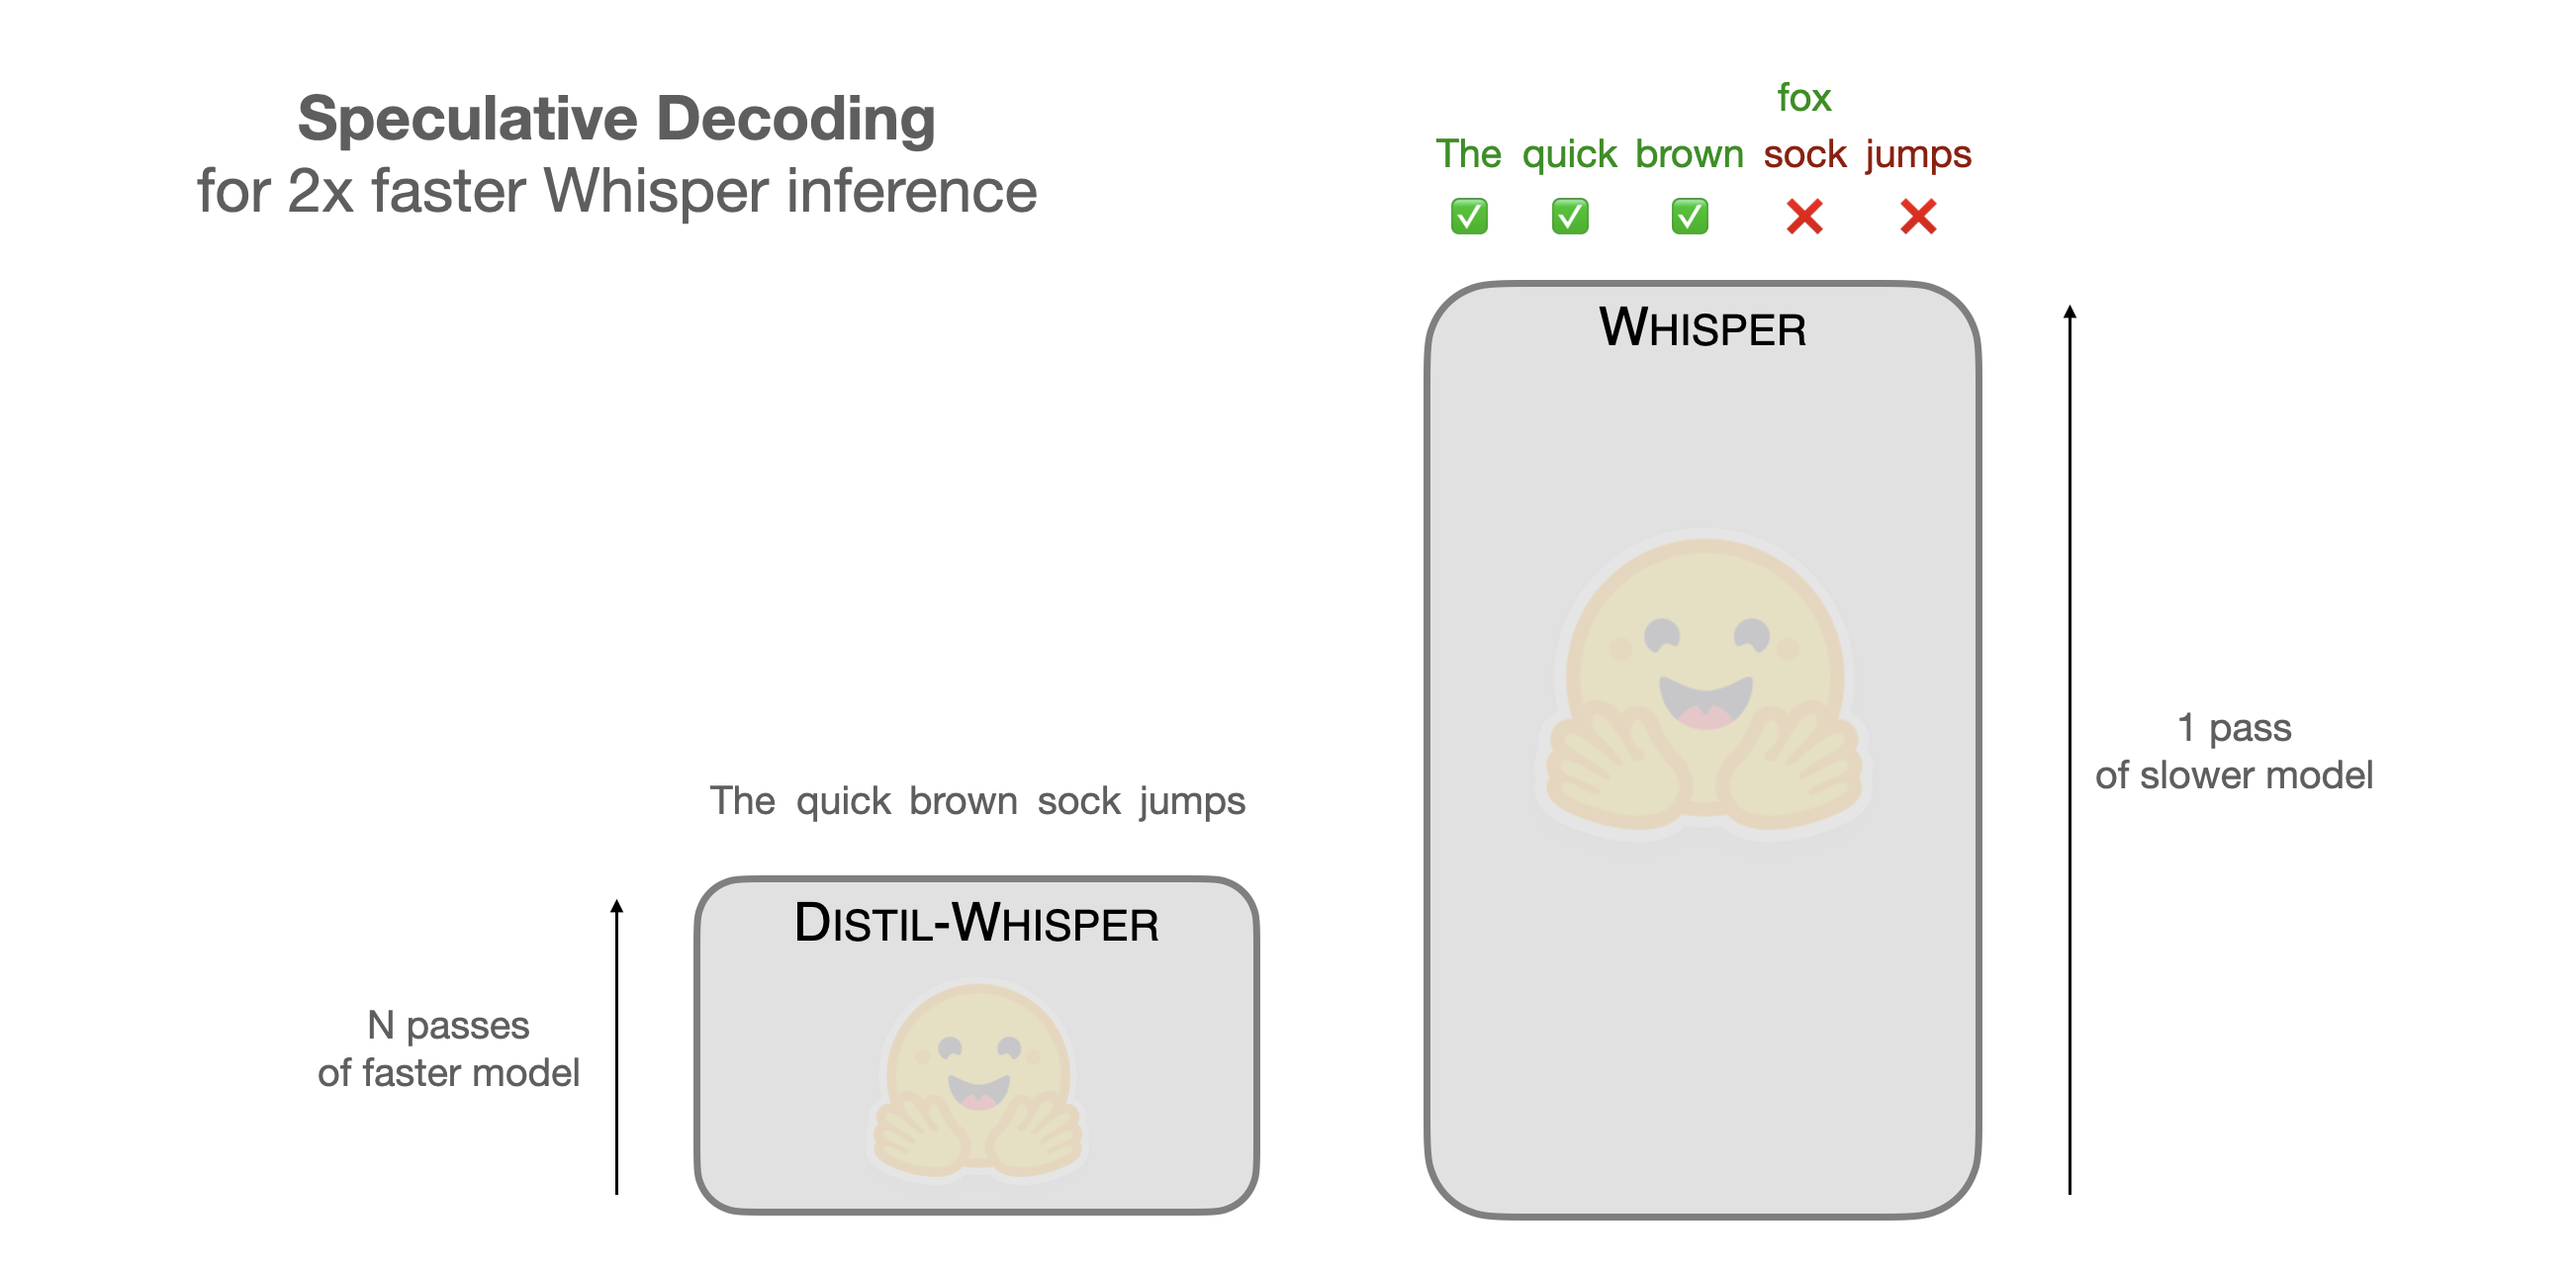
دو برابر سرعت ورایشر با Speculative Decoding در پردازش گفتار
استفاده از تکنیک Speculative Decoding در مدل Whisper، سرعت پردازش گفتار را دو برابر میکند و دقت آن را حفظ میدارد؛ یک گام مهم در توسعهٔ هوش مصنوعی
 پژوهش
OpenAI با ۱۰۰ میلیتبلون بر سر سوپرهارمونی هوش مصنوعی، گرنتهای سریع را راهاندازی کرد
OpenAI با اعلام جایزههای سریع ۱۰۰ میلیون دلاری سوپرهارمونی، به پژوهشگران امکان میدهد نسبت به امنیت سیستمهای هوش مصنوعی بهسرعت پیش ببرند تحقیقات کنند.
 مدلها
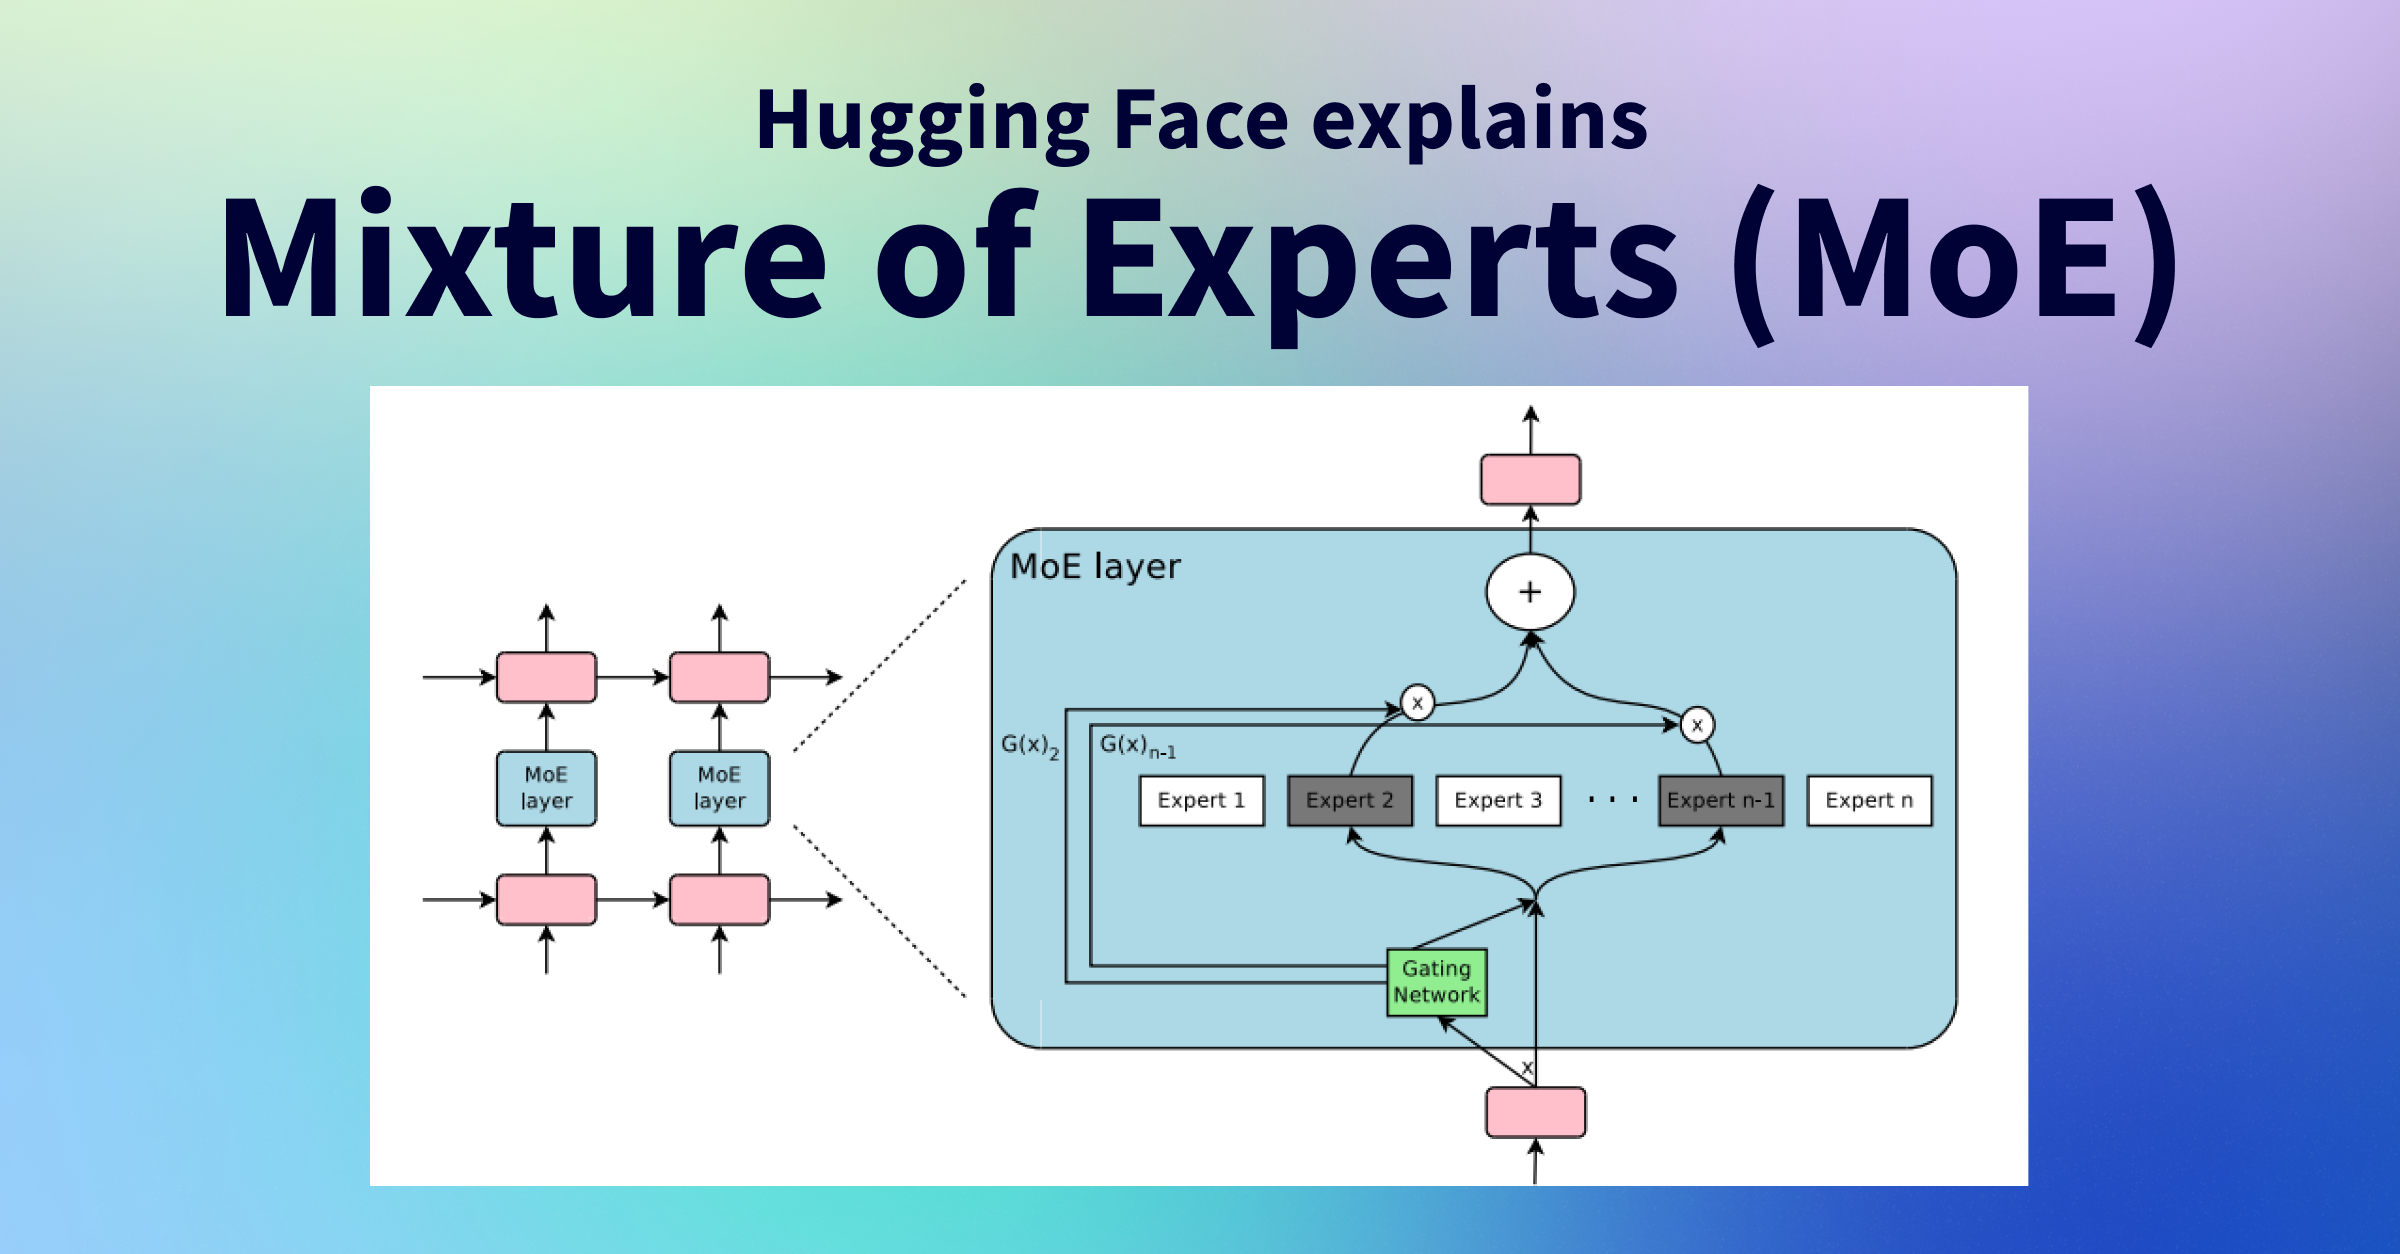
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 پژوهش
هوش مصنوعی: SetFitABSA راهحلی خلاق برای تحلیل احساسات بر محور ویژگی
SetFitABSA، یک مدل کمنشانداد (few-shot) مبتنی بر SetFit، برای تحلیل دقیق احساسات پیرامون ویژگیهای خاص در متن، با سرعت و دقت بالا در دسترس است.