
چالشها در مقیاسپذیری مدلهای هوش مصنوعی
مدلهای هوش مصنوعی مدرن، به ویژه آنهایی که بر پایه بردارهای ادغام (Embeddings) برای جستجو و بازیابی اطلاعات کار میکنند، با چالشهای جدی در مقیاسپذیری مواجه هستند. حجم بالای دادههای برداری، مصرف زیادی از حافظه و ظرفیت دیسک را در پی دارد که هزینههای زیرساختی را افزایش میدهد. در این راستا، تیم توسعه Hugging Face راهکارهایی نوآورانه برای بهینهسازی فرآیند بازیابی دادهها ارائه کرده است.
روشهای کوانتیزهسازی باینری و اسکالر
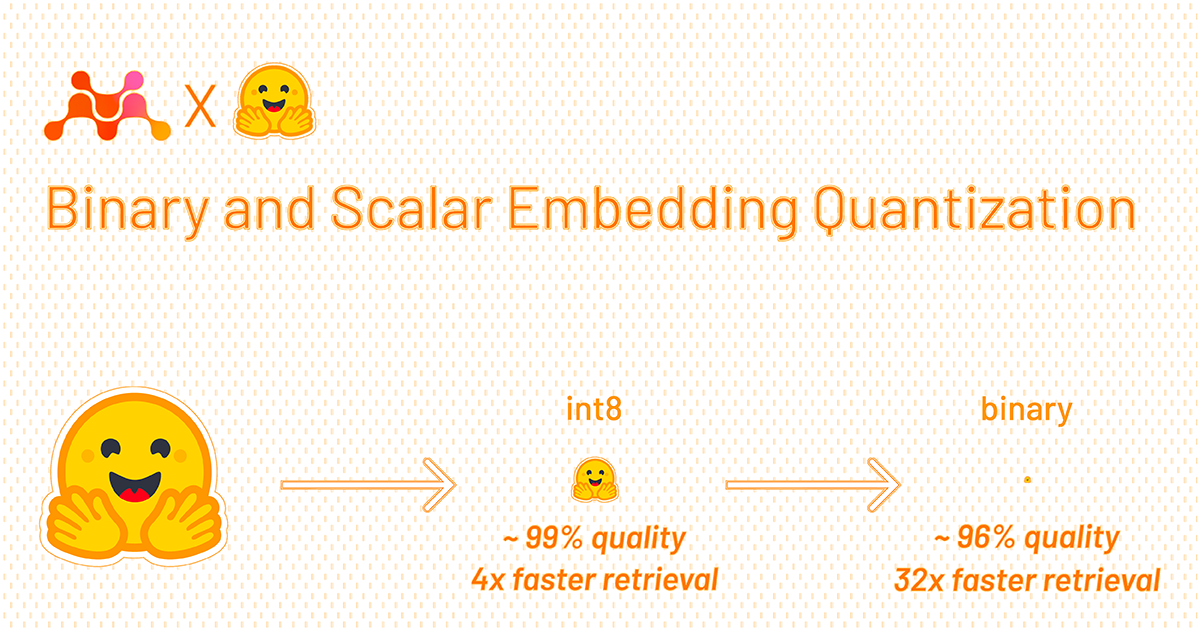
کوانتیزهسازی فرآیندی است که دقت عددیِ مقادیر داخل مدل را کاهش میدهد تا فضای ذخیرهسازی کمتری占用 کند. در مقاله جدید، دو روش اصلی معرفی شده است: کوانتیزهسازی باینری (Binary) که مقادیر را به صفر و یک کاهش میدهد و کوانتیزهسازی اسکالر (Scalar) معمولاً با هسته ۸ بیتی (int8).
- کوانتیزهسازی باینری میتواند مصرف رم را تا ۳۲ برابر کاهش دهد.
- ادغام این دو روش میتواند تعادلی mezi دقت و سرعت ایجاد کند.
- امکان پیادهسازی آسان در کتابخانههای Sentence Transformers و پایگاههای داده برداری.
نتایج عملی و دمو با ۴۱ میلیون سند
برای اثبات صحت این مؤلفهها، یک دموی واقعی با استفاده از ۴۱ میلیون متن از ویکیپدیا اجرا شد. نتایج نشان داد که با اعمال کوانتیزهسازی، سرعت بازیابی اطلاعات بهطور چشمگیری افزایش یافته و هزینههای کلان بهینهسازی شده است. این پیشرفت گامی مهم در جهت دموکراتیزاسیون هوش مصنوعی از طریق علم متنباز محسوب میشود.
پرسشهای پرتکرار
کوانتیزهسازی بردارهای ادغام چیست؟
فرآیندی است که دقت عددی دادههای برداری را کاهش میدهد تا فضای ذخیرهسازی کمتر و سرعت پردازش بالاتری ایجاد شود، بدون افت محسوس کیفیت نتایج.
مزایای اصلی این روش برای توسعهدهندگان چیست؟
کاهش قابل توجه هزینههای زیرساختی، مصرف کمتر رم و ظرفیت دیسک، و افزایش سرعت پاسخگویی سیستمهای بازیابی اطلاعات در مقیاس بالا.


