
مقدمه
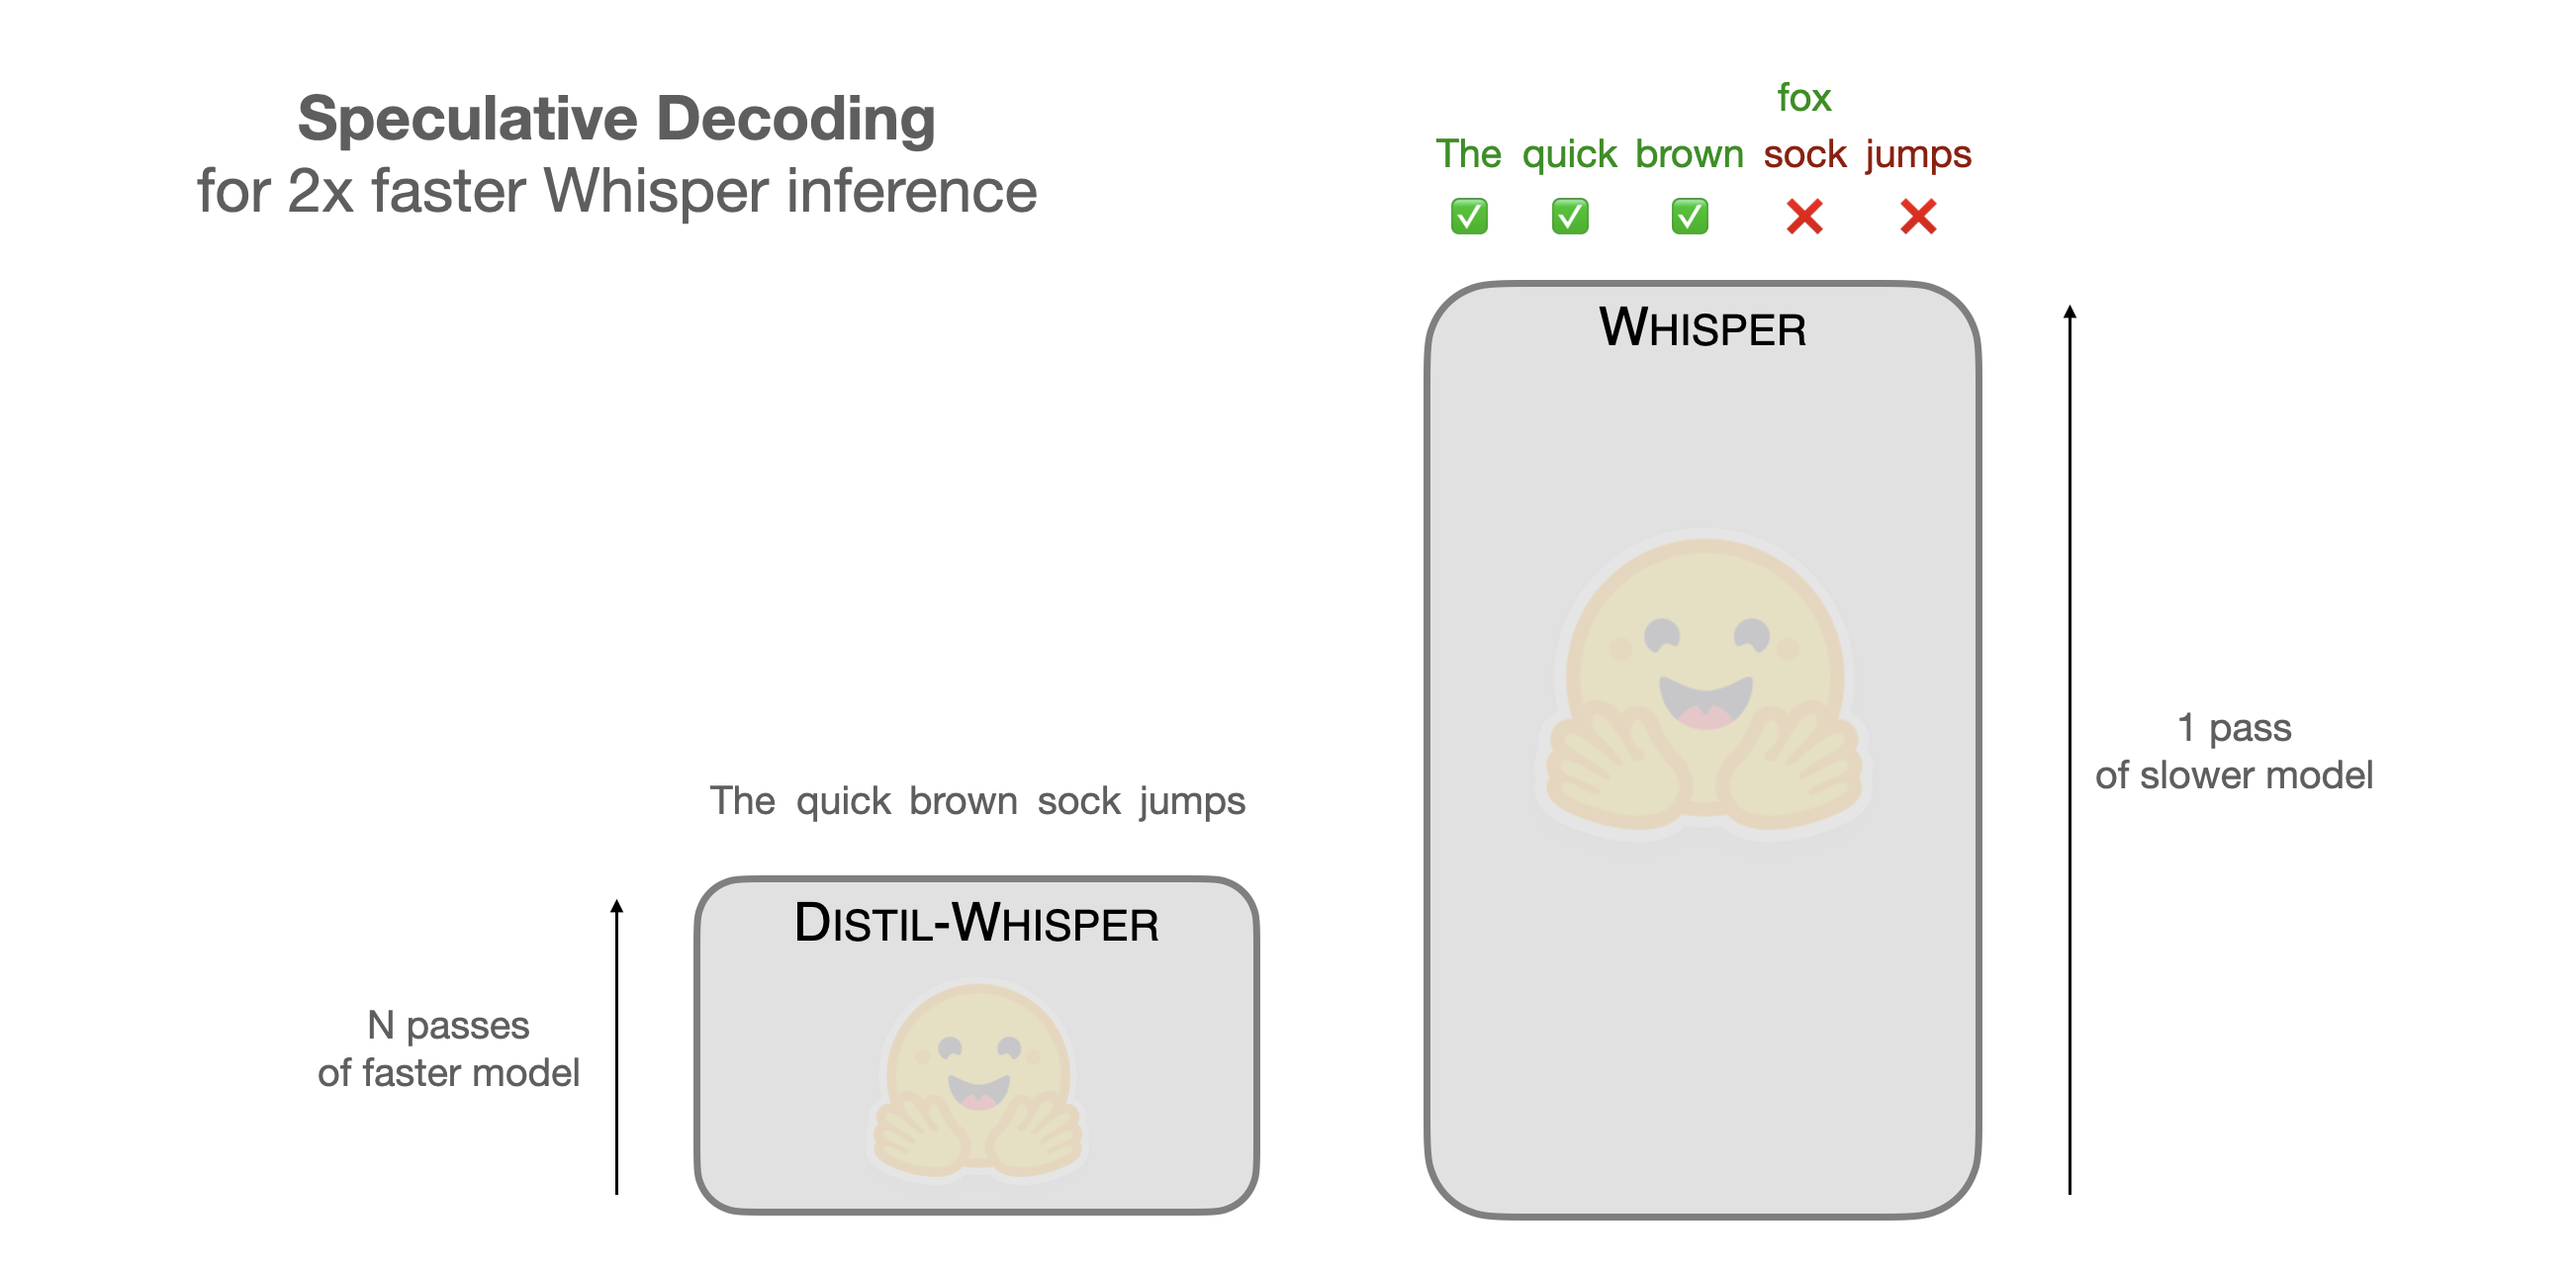
در دنیای هوش مصنوعی، مدلهای تشخیص گفتار همچون Whisper از OpenAI برترین ابزارهای موجود به شمار میآیند. با این حال، عملکرد آنها در مقایسه با معیارهای تجاری باعث مواجهه ما با چالشهای سرعت پاچهخور میشود. در این میان، Speculative Decoding یک راهحل ابتکاری معرفی کرده است که سرعت اجرای Whisper را دو برابر میکند در حالی که دقت را حفظ میکند.
چگونه Speculative Decoding کار میکند؟
این تکنیک در اصل یک روش از پیشبینی چند گام جلوه دارد. به جای انتظار خروجی دقیق برای یک کلمه در هر مرحله، مدل به صورت موازی چند احتمال احتمالی را تولید میکند؛ سپس ماندهی پردازش بر اساس بهترین نتیجه انتخاب میشود. الگوریتمی خوب طراحی شده است که مطمئن میشود در انتهای کار، وزن خروجی همانطور که در حالت عادی میبودن، بماند.
نتایج آزمایشها و ارزش افزوده Whisper
با اجرای Speculative Decoding روی مدل بزرگ v3 Whisper، برای یک ضبط صوت یک ساعته روی کارت گرافیک 16GB T4، زمان پردازش از 6 دقیقه به حدود 3 دقیقه کاهش یافت. علاوه بر این، WER (خطای واژه) در ۴۲ زبان از ۵۸ زبان آزمایششده در مجموعه Common Voice 15 به کمتر از 30٪ باقی ماند.
- دو برابر کردن سرعت پردازش
- حفظ یا بهبود دقت ترجمه صوتی
- استفاده آسان در محیطهای ابری و محلی
- توزیع آزاد و بدون بستهبندی کد (Open Source)
چند نکته برای بالا بردن بهرهوری
توصیه میشود که برای استفاده تجاری از Speculative Decoding، در کنار آن از تکنیکهای دیگری مانند Half-Precision, Flash Attention و Chunking بهره بگیرید تا بردارهای ممکن را به صورت کامل به حداقل برسانید.
پرسشهای پرتکرار
Speculative Decoding چیست و چگونه سرعت را دو برابر میکند؟
Speculative Decoding یک الگوریتم پیشبینی چندگام جلوه است که در هر مرحله چندین گزینه پیشبینی میکند و سپس با حذف آنها که احتمالاً درست نیستند، محدودیت میتواند مفروض شود. این امر باعث میشود که مدل در مقایسه با اجرای یکنواخت در هر مرحله، زمان لازم برای پیشبینی کلمات به میزان معناداری کاهش یابد.
آیا دقت اجرای Whisper با Speculative Decoding کاهش پیدا میکند؟
خیر، در این پژوهش با تکنیک Speculative Decoding دقت حفظ شده و معیارهای WER در تعداد زیر 30٪ باقی ماند، در حالی که سرعت دوگانه شد.


