Mixture of Experts چیست؟
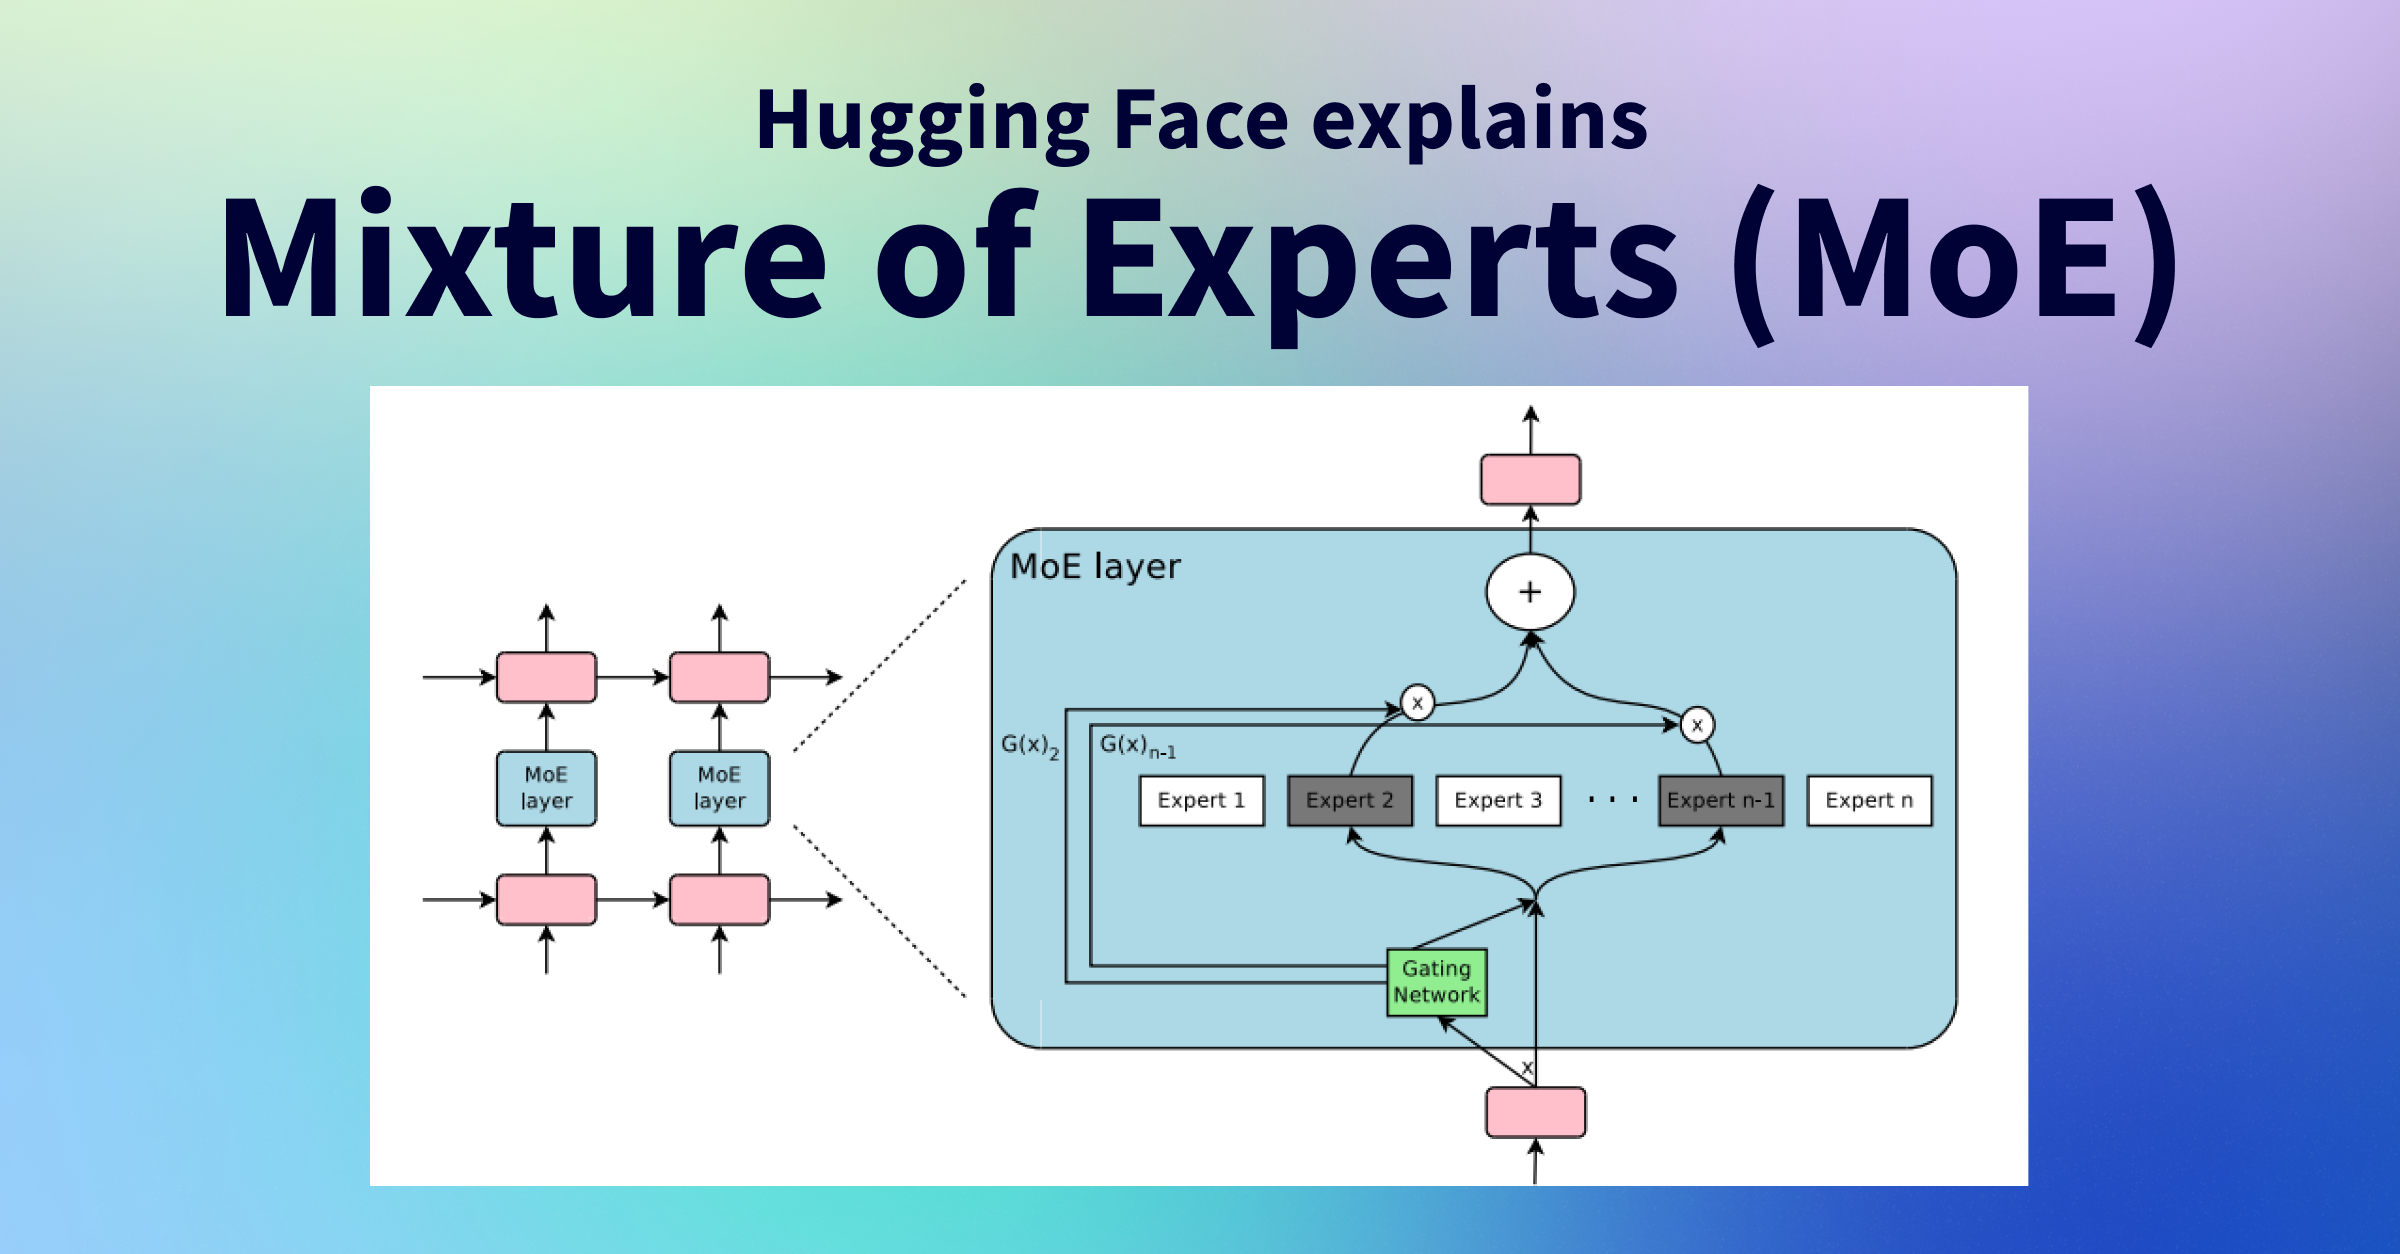
Mixture of Experts (MoE)، رویکردی است که در آن چند تخصص (expert) مختلف، مسئول توزیع کار را بر عهده دارند. هر تخصص به صورت مشروط به ورودیهای خاصی فعال میشود و این امکان را میدهد که حافظه مصرفی کاهش یابد و در عین حال دقت عملکرد بالا حفظ شود.
مزایا و کاربردهای مدلهای MoE در هوش مصنوعی
استفاده از MoE باعث میشود که موارد زیر بهصورت در عمل تحقق یابد:
- کاهش مصرف حافظه در مدلهای بزرگ
- افزایش سرعت پردازش در دستههای خاص
- توانایی یادگیری کاربردهای نایاب و مختلف بدون نیاز به طبقهبندی مجدد
- قابلیت مقیاسپذیری در حجم داده و پارامترها
چالشها و راهحلهای فعلی در مهندسی MoE
هرچند MoE مزایایی دارد، اما با چالشهای خویش روبهرو است. یکی از مهمترین مسائل، عدم توزیع یکسان تسکها بر میان تخصصها (load balancing) است؛ اگر تخصصی بیش از حد فعال باشد، بهینهسازی کند میشود. الگوریتمهای روتر (router) و تکنیکهای Z‑Loss به منظور تثبیت آموزش و بهبود تعادل دستهبندی میآیند.
علاوه بر این، هزینههای ارتباطی و نیاز به زمانبندی مناسب در محیطهای توزیعشده، راهحلهای جدیدی مثل حافظهٔ ذخیره (bucket) و نقطهٔ پایان (endpoint) ساختاریافته را بهدرخواست میاندازد.
پرسشهای پرتکرار
Mixture of Experts در مقایسه با مدلهای چگال چه مزیتی دارد؟
MoE با بهکارگیری تخصصهای محدود و شرطی، حافظه مصرفی کمتری مینویسد و سرعت بالا را حفظ میکند؛ در حالی که مدلهای چگال نیازمندی به ذخیره تمام پارامترها دارند.
برای شروع کار با MoE میتوانم از کدام کتابخانه استفاده کنم؟
کتابخانهٔ Transformers در هاجینگ فیس از MoE پشتیبانی میکند و مستندات کلاسهٔ "First Class Citizens" برای آغاز کار در دسترس است.