
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 پژوهش
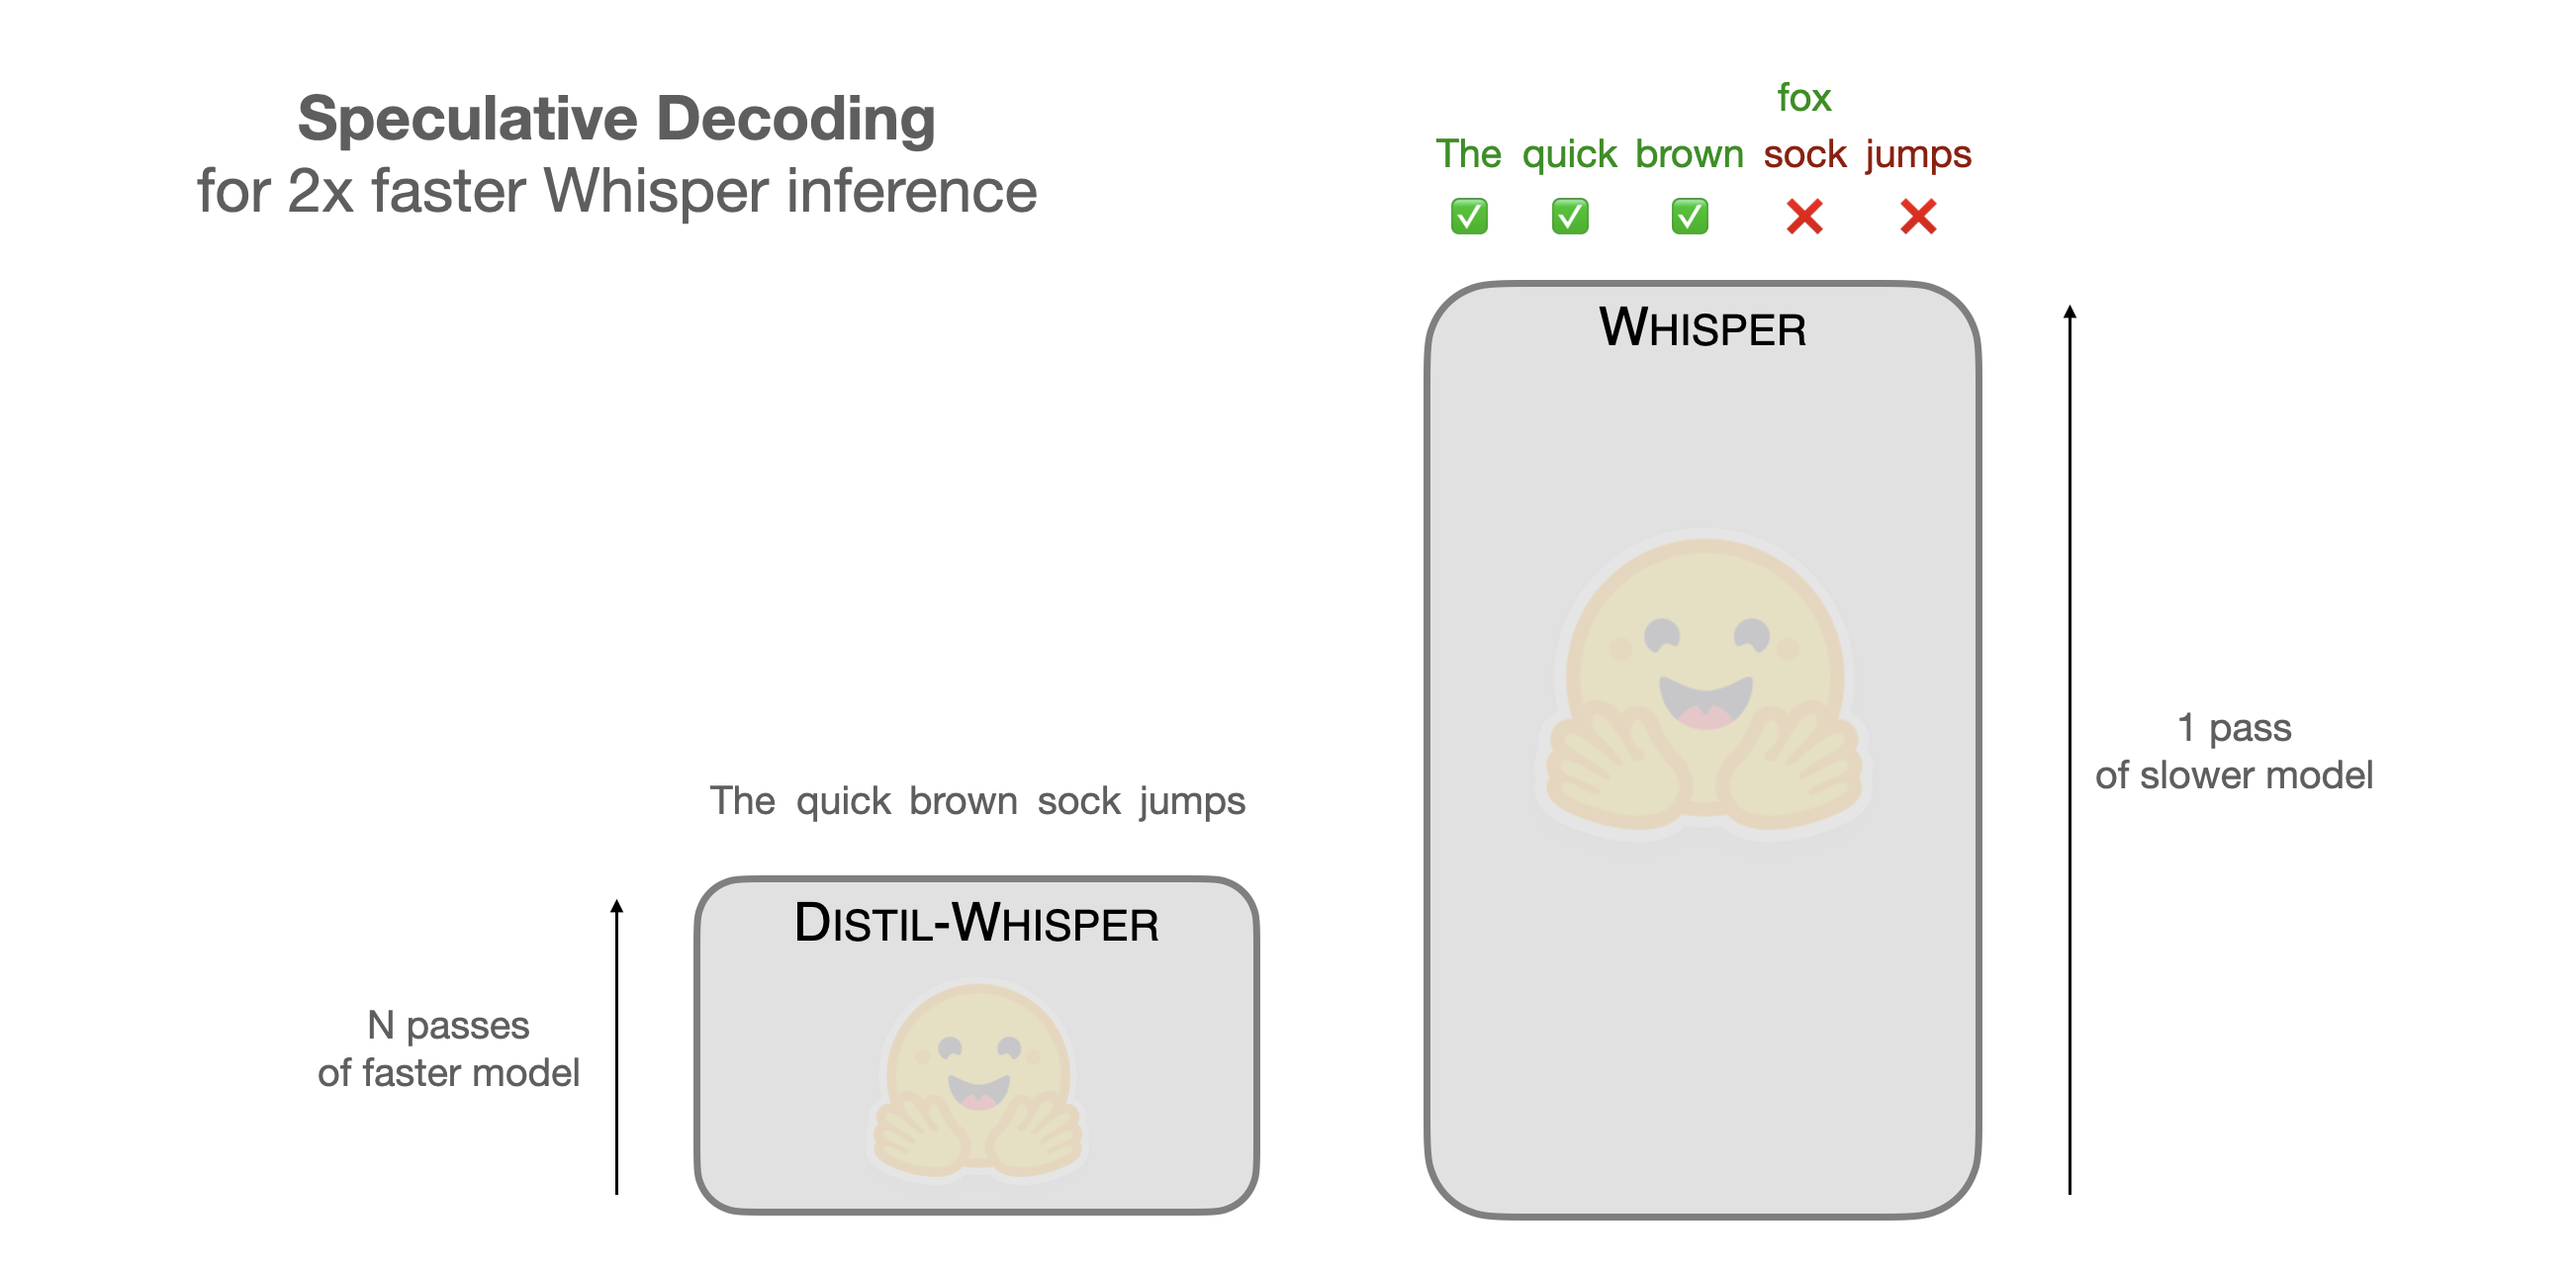
دو برابر سرعت ورایشر با Speculative Decoding در پردازش گفتار
استفاده از تکنیک Speculative Decoding در مدل Whisper، سرعت پردازش گفتار را دو برابر میکند و دقت آن را حفظ میدارد؛ یک گام مهم در توسعهٔ هوش مصنوعی
 مدلها
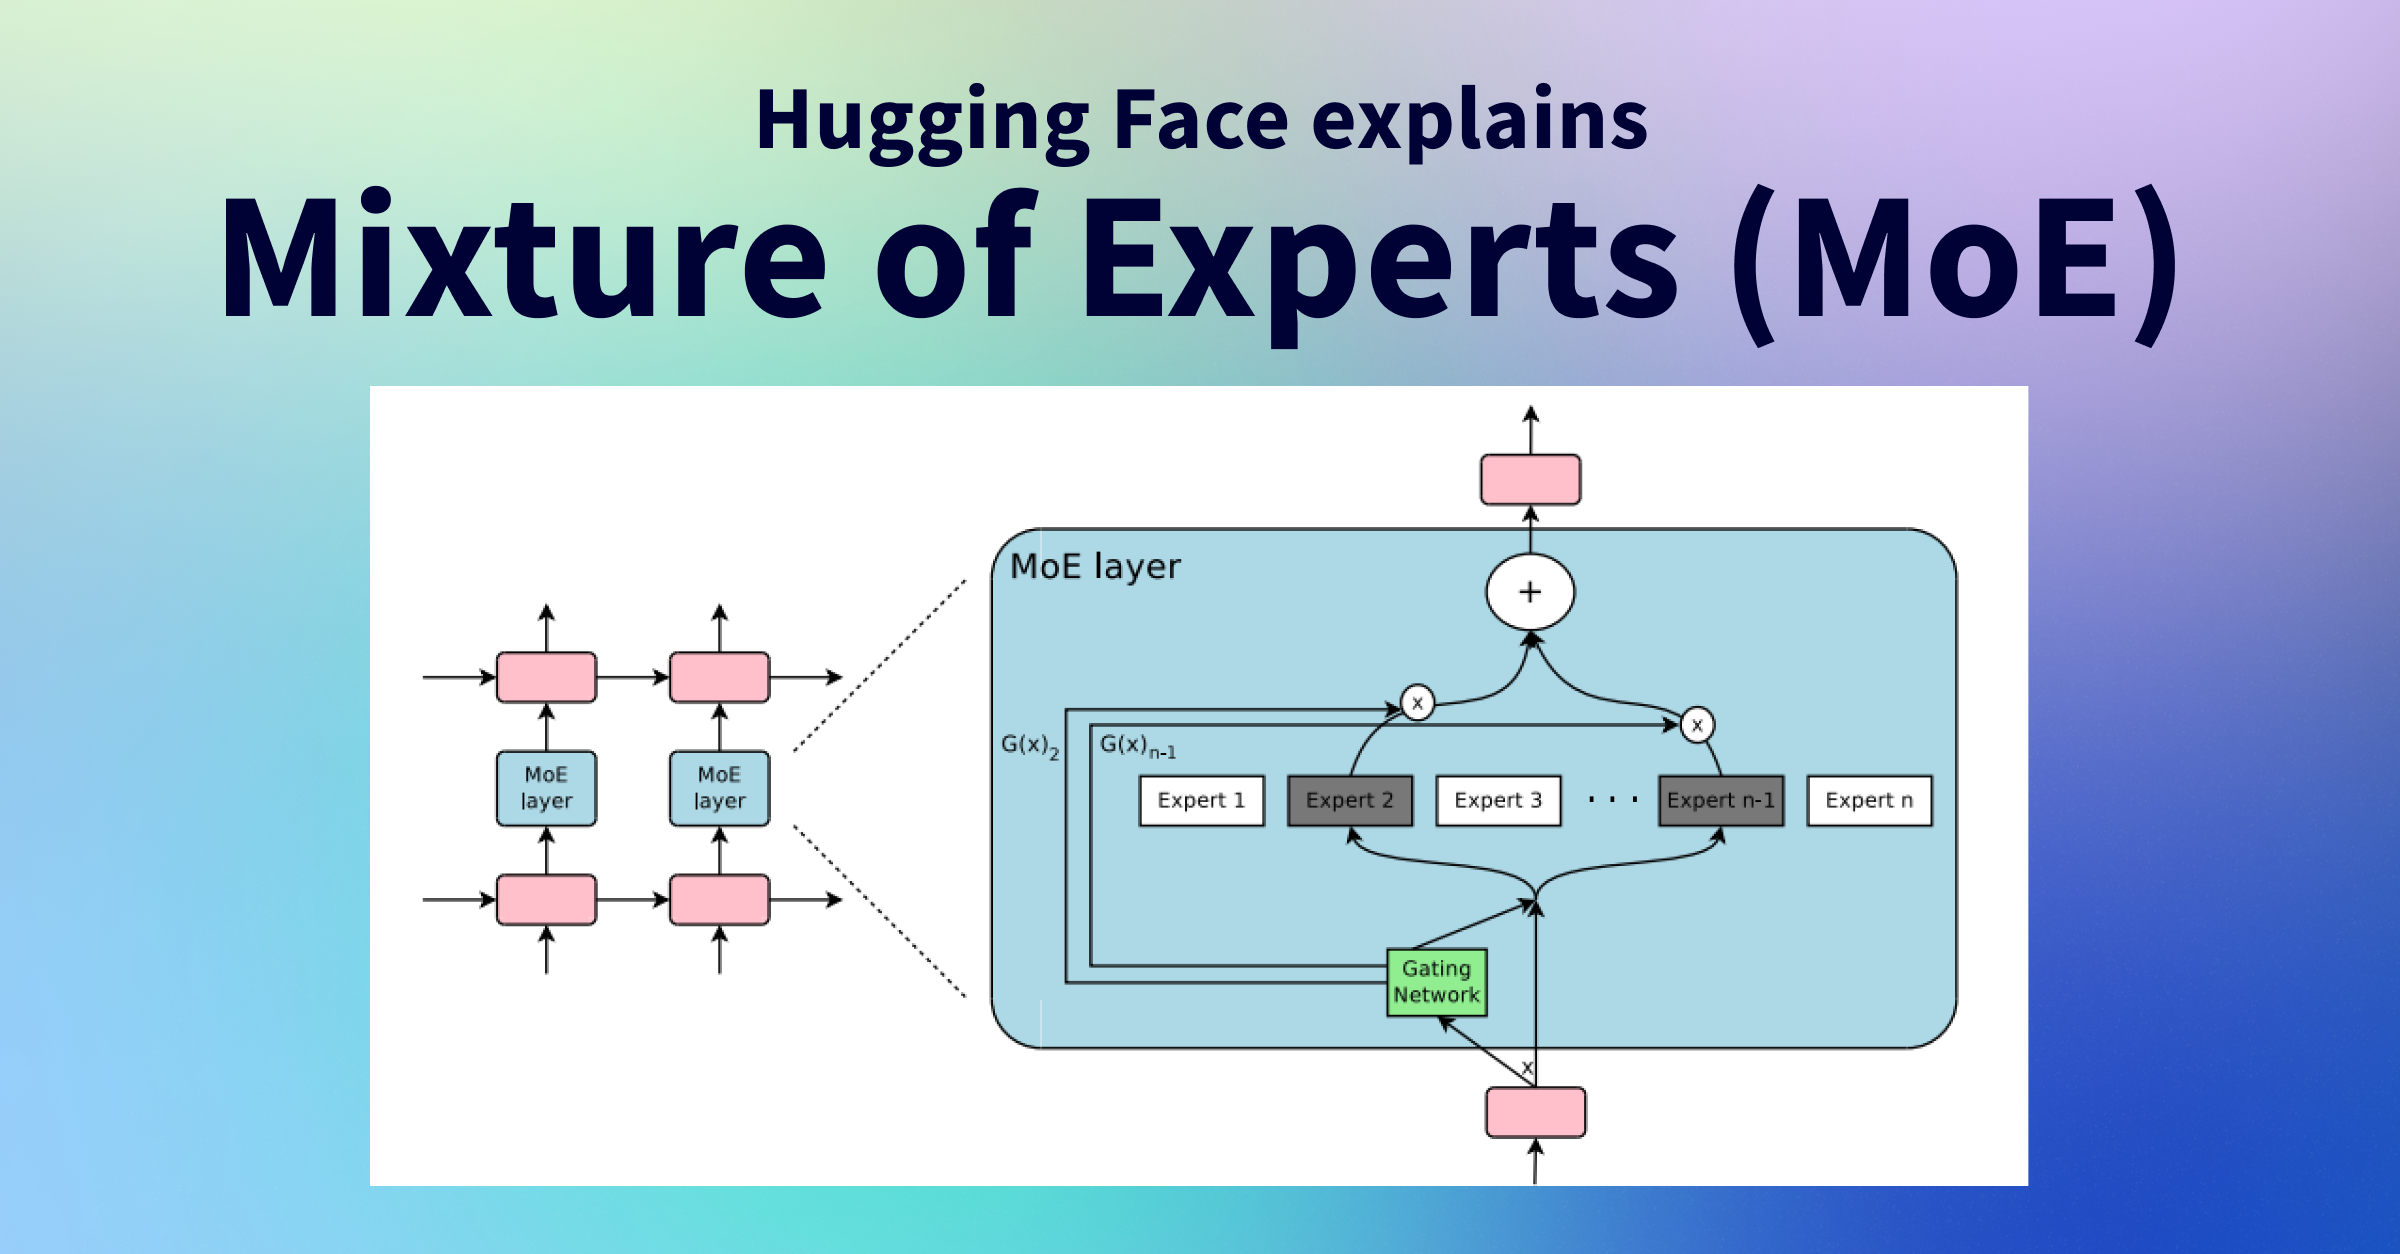
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 پژوهش
هوش مصنوعی در تحلیل توییتهای بلایای طبیعی: مقایسه RoBERTa، Llama 2 و Mistral با LoRA
در این مقاله، عملکرد مدلهای RoBERTa، Llama 2 و Mistral 7B را در پردازش توییتهای بلایای طبیعی با استفاده از تکنیک LoRA بررسی میکنیم.
 محصولات
قاطعترین گام در هوش مصنوعی: Prodigy-HF، ادغام مستقیم با Hugging Face
تحلیل تازه از ادغام Prodigy-HF با Hugging Face، کدهای سفارشی و امکانات آموزشی برای توسعهدهندگان هوش مصنوعی و پژوهشگران در زمینه پردازش زبان طبیعی.
 مدلها
پیشرفت هوش مصنوعی: تلاش برای بهینهسازی ساده SDXL جهت سرعت و حافظه
یادآورترین نکات بهینهسازی ساده SDXL، مدل پیشرفته تولید تصویر هوش مصنوعی، با تأکید بر سرعت، حافظه و کارایی در مقالهٔ تازه ما.
 پژوهش
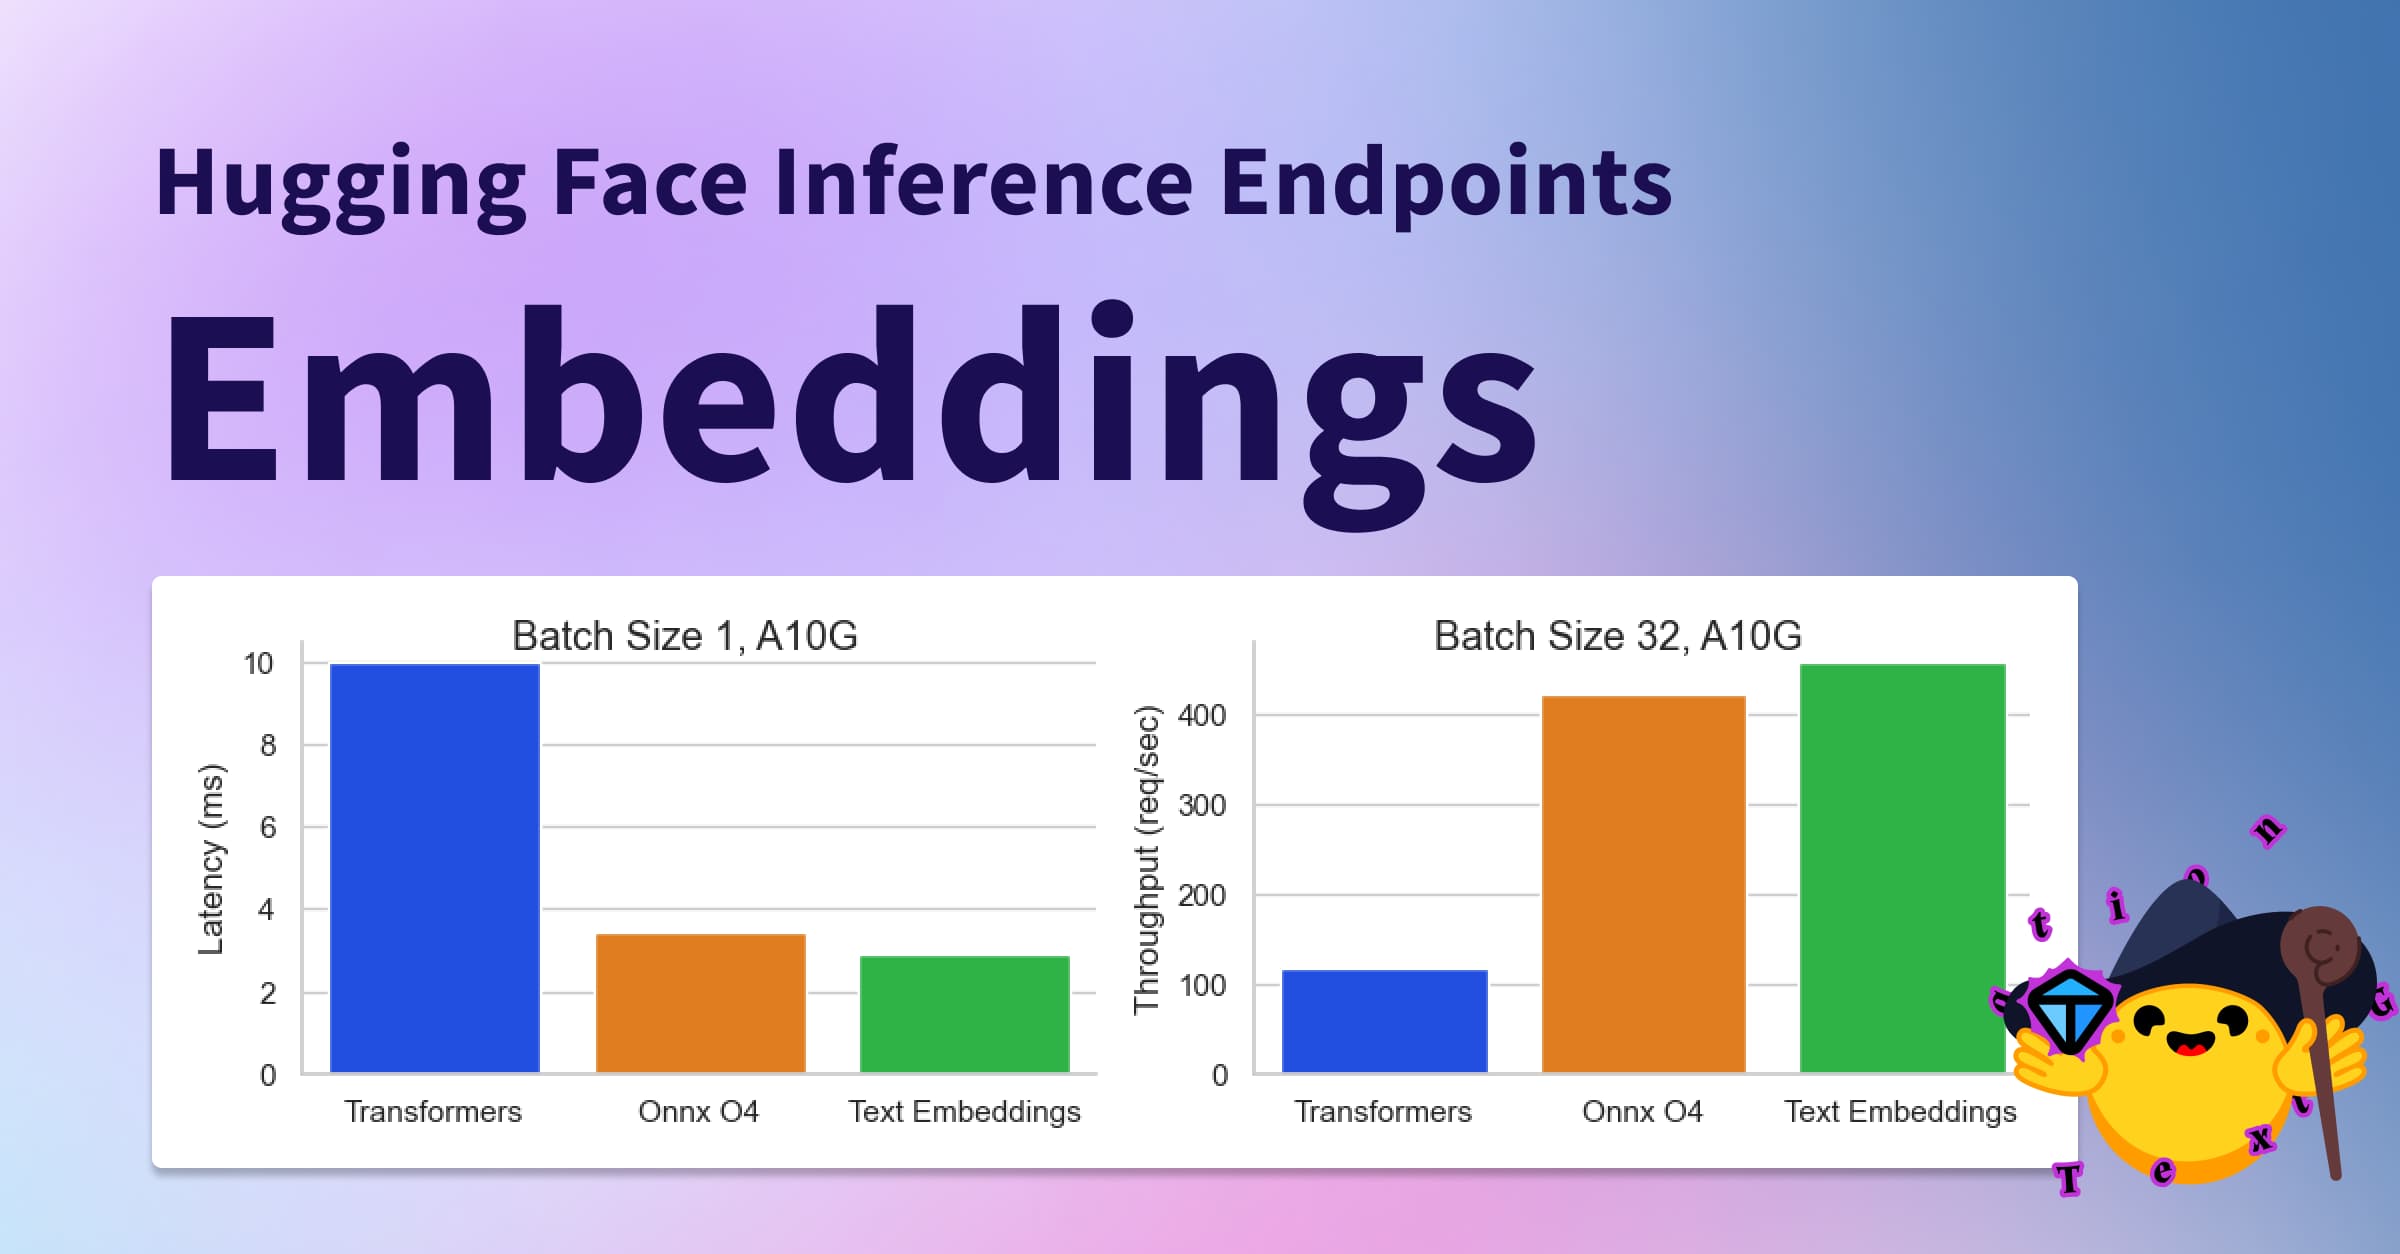
هوش مصنوعی در خدمت دنیای دادهها: انتشار مدلهای ایمبدینگ در Hugging Face
پست جدید هوش مصنوعی در Hugging Face با توضیح گام به گام جهت استقرار مدلهای ایمبدینگ، سرعت پردازش بالاتر و استفاده در تجزیه و تحلیل دادههای متنی و تصویری با مقایسه عملکرد و نکات عملکردی.
 سختافزار
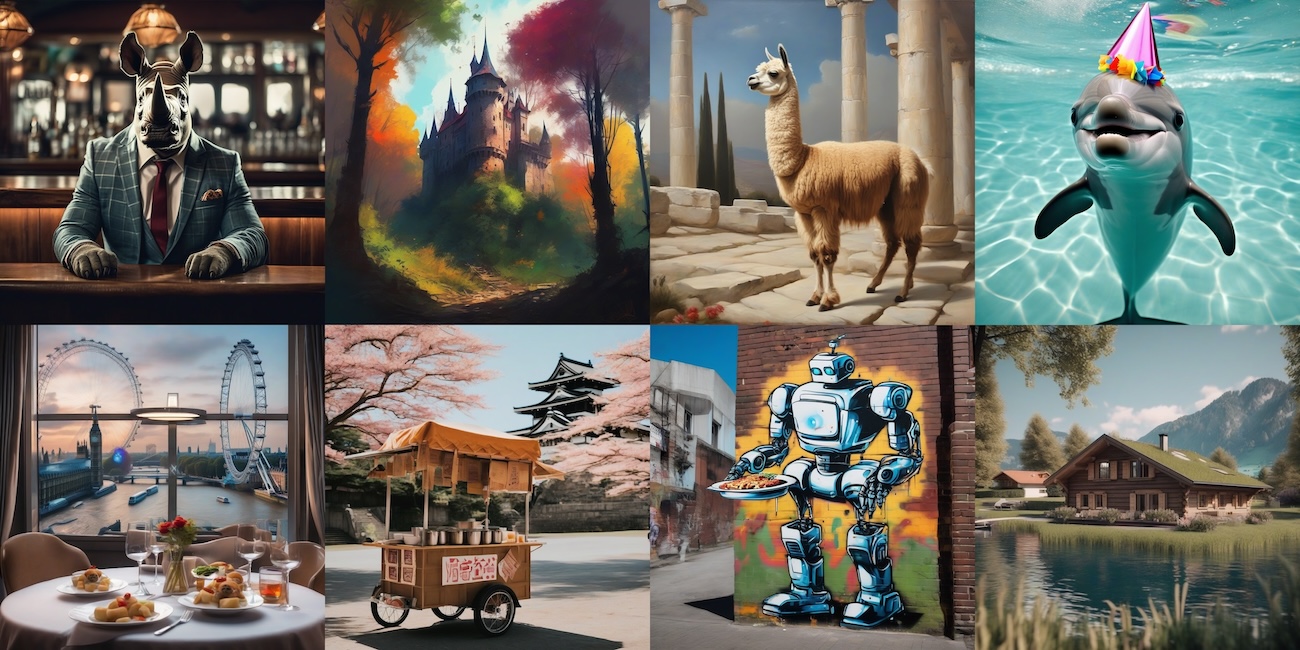
هوش مصنوعی بر روی Cloud TPU v5e: سرعتبخشی SDXL با JAX
کشف روش جدیدی برای پردازش مدل Stable Diffusion XL با بهرهگیری از JAX بر روی Google Cloud TPU v5e؛ بهبود کارایی، کاهش هزینه و افزایش سرعت تولید تصویر عالی در شرایط واقعی.
 مدلها
هوش مصنوعی GPT‑4V: امکانات تصویری و جزئیات سیستمکارت از OpenAI
GPT‑4V با قابلیت تشخیص تصویر و پاسخدهی به سؤالات بصری، جزئیات کامل در سیستم کارت OpenAI ارائه میدهد؛ توضیحات فنی، محدودیتها و راهکارها.