
مقدمه
در دنیای امروز، مدلهای استخراج جاسازی یا Embedding معیار اصلی برای شناخت و ربط معنایی دادهها است. در این مطلب به نحوهی ساده و موثر استقرار این مدلها با استفاده از درگاههای استنتاج (Inference Endpoints) در پلتفرم Hugging Face میپردازیم.
Hugging Face Inference Endpoints چیست؟
درگاههای استنتاج سرویسمحور هستند که به توسعهدهندگان امکان میدهند مدلهایشان را بهسرعت در اینترنت بهاشتراک بگذارند. این سرویس بهطور خودکار مقیاسپذیری را بر عهده میگیرد و نیازی به مدیریت زیرساخت فیزیکی یا VPS نیست.
چرا مدلهای ایمبدینگ؟
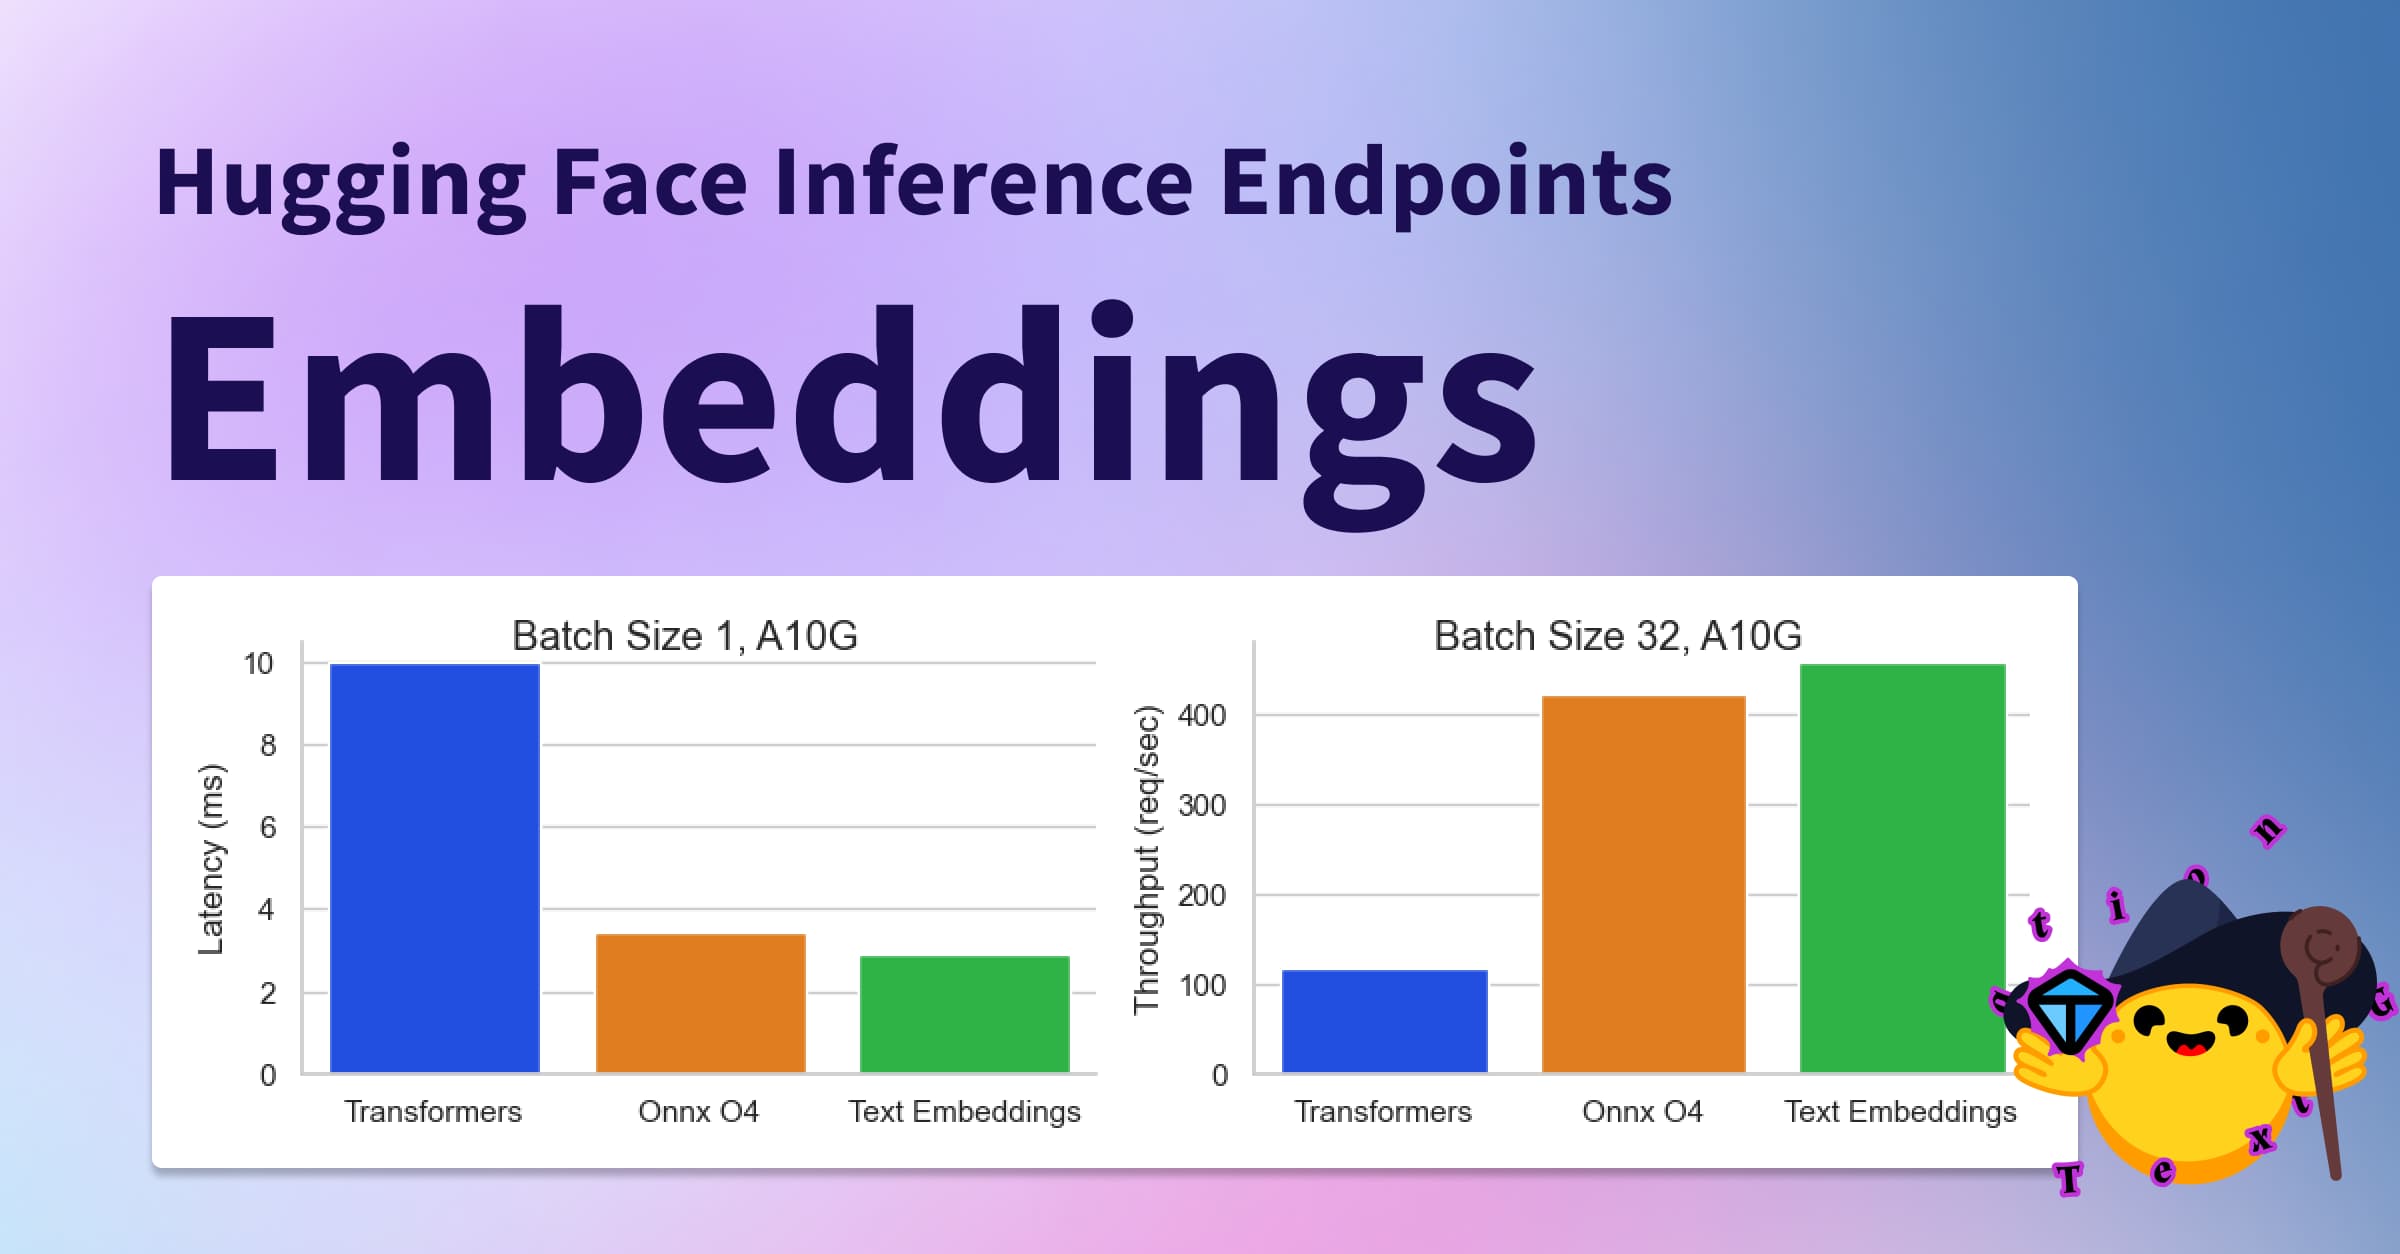
مدلهای ایمبدینگ، بردارهای چندبعدی متن، تصویر یا کد را تولید میکنند. این بردارها امکان مقایسهی معنایی، جستجوی مشابهسازی و ترکیب با مدلهای بزرگ مانند LLM را فراهم میآورند و بهدلیل سبک بودن، پردازش سریعتری نسبت به LLM دارند.
نحوهی استقرار مدل ایمبدینگ
اولین گام در خواهم آوردن یک مدل مناسب از Hugging Face Hub بوده و سپس در بخش Inference Endpoints آن را بارگذاری کنید. فرایند در سه مرحله سادهای انجام میشود:
- انتخاب مدل و پیکربندی پارامترها
- فعالسازی endpoint و تنظیم رندرینگ سرعت
- ارسال درخواست و دریافت بردارهای ایمبدینگ
پس از ساخت، میتوانید درخواست دهید و بردارها را در زمان واقعی دریافت کنید. بهدلیل زمانبندی پایین، تجربه کاربری در برنامههای ربطشده بهبودگی بالاست.
مثالی ساده
برای نمونه، در زیر کد پایتون کوتاهی برای ارسال متن و دریافت بردار آورده شده است:
import requests endpoint = "https://api-inference.huggingface.co/models/your-model" payload = {"inputs":"متنی برای جاسازی"} headers = {"Authorization":"Bearer YOUR_TOKEN"} r = requests.post(endpoint, headers=headers, json=payload) print(r.json())نتیجهگیری
استقرار مدلهای ایمبدینگ در Inference Endpoints نهتنها ساده است، بلکه برای پروژههای پردازش زبان، تحلیل تصویر و ایجاد سیستمهای پیشنهاددهنده بسیار مفید میباشد. مبانی این راهنما کمک شایانی به تسریع فرآیند تحقیق و توسعه میکند.
پرسشهای پرتکرار
چگونه میتوانم یک مدل ایمبدینگ را بر روی Inference Endpoint بارگذاری کنم؟
در بخش Inference Endpoints از حساب Hugging Face خود، گزینهی Create new endpoint را انتخاب کرده، مدل مورد نظر را از Hub انتخاب و تنظیمات مورد نیاز را وارد کنید. بعد از ساخت، میتوانید از URL ارائه شده برای درخواستهای POST استفاده کنید.
تفاوت سرعت مدل ایمبدینگ و LLM چیست؟
مدلهای ایمبدینگ معمولاً سبکتر و با حجم کمتر هستند؛ به همین دلیل میتوانند در زمان کمتر بردارهای چندمضرعی تولید کنند. در حالی که LLM برای تولید متن طولانی و پاسخهای جملات پیچیده به کاربرد میآید، اما زمان پردازش بالاتری دارد.


