
 سختافزار
همکاری هوش مصنوعی: Hugging Face و Graphcore برای تسریع ترنسفورمرها با IPU
پلتفرم جدید Graphcore IPU در همکاری با Hugging Face سرعت اجرای مدلهای ترنسفورمر پیشرفته را بدون کدنویسی پیچیده، در مقیاس تولید، افزایش داده و به توسعهدهندگان امکان میدهد بهسرعت مدلهای برتر را مستقر کنند.
 اخبار
استقرار آسان مدلهای هوش مصنوعی Hugging Face با Amazon SageMaker
با همکاری Hugging Face و آمازون، اکنون میتوانید مدلهای ترنسفورمر را تنها با یک خط کد در SageMaker مستقر کنید.
 مدلها
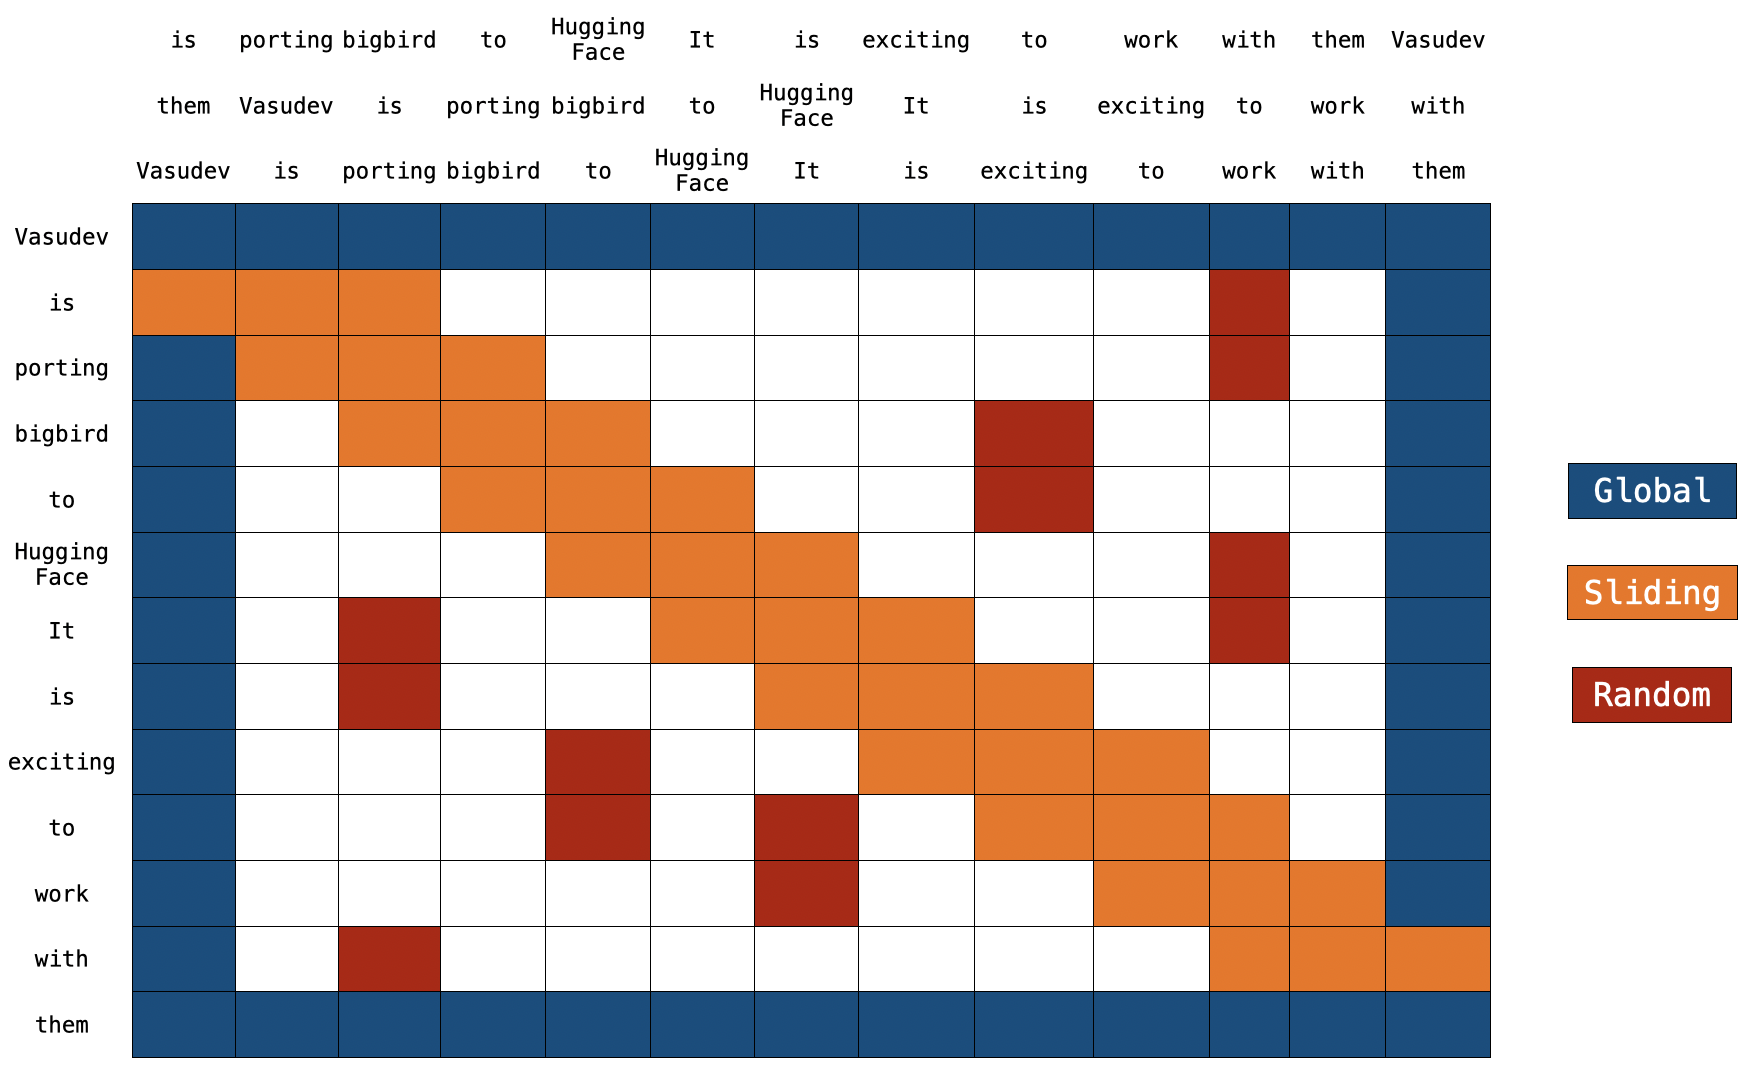
هوش مصنوعی BigBird: راهکاری نوین برای پردازش متنهای طولانی
مدل BigBird با بهرهگیری از توجه پراکنده بلوکی، پردازش متنهای طولانی را در هوش مصنوعی ممکن کرده است. این مدل در خلاصهسازی و پرسش و پاسخ عملکرد برجستهای دارد.
 آموزش
استقرار پایپلاین هوش مصنوعی ترنسفورمرز روی Google Cloud بدون سرور
در این مقاله تجربه استقرار یک پایپلاین تحلیل احساسات با ترنسفورمرز و Google Cloud را میخوانید؛ از انتخاب سرویس مناسب تا هزینهها و عملکرد.
 پژوهش
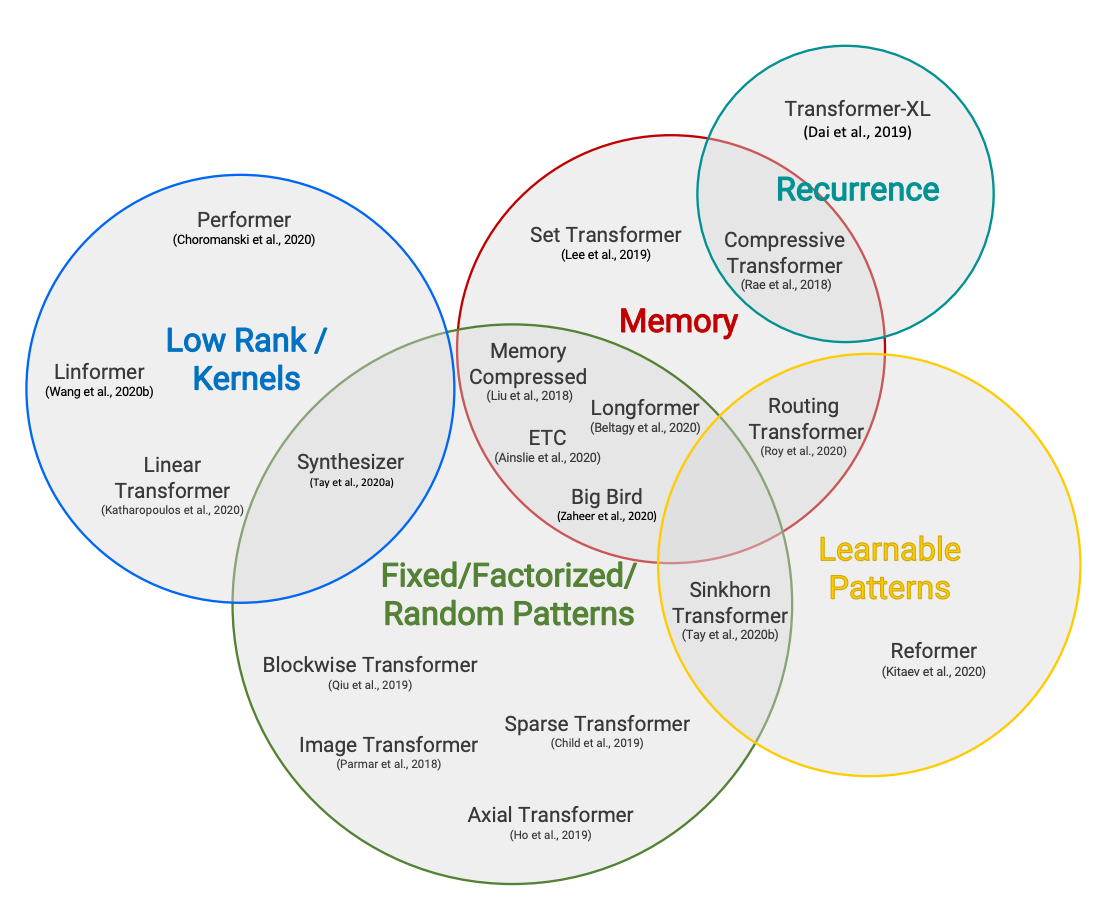
هوش مصنوعی در خواندن متنهای طولانی: معرفی ترنسفورمهای بلنددامنه
در این مقاله از سری خواندنیهای هوش مصنوعی، به معرفی ترنسفورمهای بلنددامنه و راهکارهای کاهش پیچیدگی محاسباتی برای پردازش متنهای طولانی میپردازیم.
 مدلها
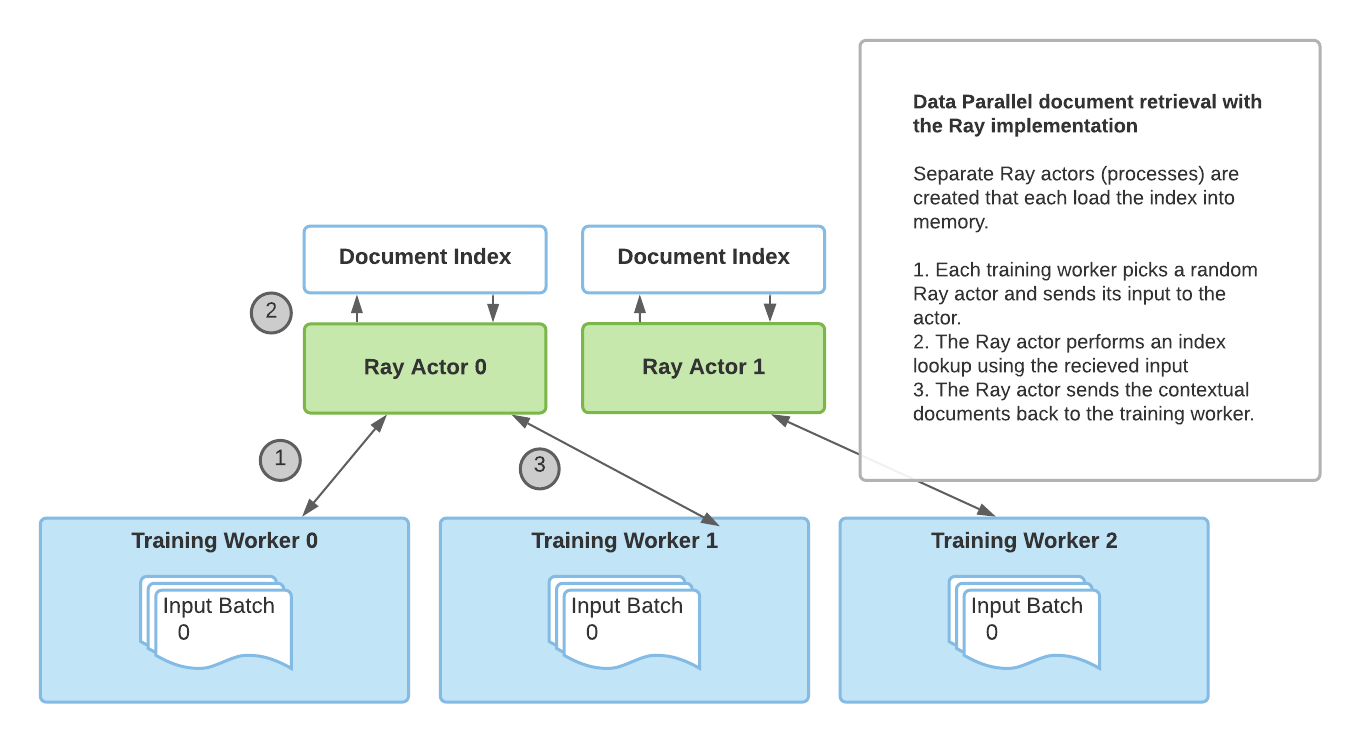
هوش مصنوعی با RAG و Ray: افزایش سرعت بازیابی متن تا ۲ برابر
با ترکیب RAG و Ray، سرعت بازیابی اسناد در مدلهای زبانی هوش مصنوعی تا ۲ برابر افزایش یافته و مقیاسپذیری تنظیم دقیق توزیعشده نیز بهطور چشمگیری بهبود مییابد.
 مدلها
افزایش ۱۰ درصدی سرعت مدلهای TensorFlow در ترنسفورمرز هوگینگ فیس
هوگینگ فیس با بهینهسازی مدل BERT در کتابخانه ترنسفورمرز، عملکرد TensorFlow Serving را تا ۱۰ درصد نسبت به پیادهسازی رسمی گوگل بهبود بخشید و سرعت را نسبت به نسخه قبلی دو برابر کرد.
 اخبار
چگونه با هوش مصنوعی سرعت استنتاج ترنسفورمرها را ۱۰۰ برابر کردیم؟
هافینگ فیس با ترکیب تکنیک های بهینه سازی و کامپایلرهای تخصصی، استنتاج ترنسفورمرها را برای مشتریان API خود ۱۰۰ برابر سریع تر کرد. در این مقاله بررسی می کنیم.
 پژوهش
گرمآغاز کردن مدلهای Encoder-Decoder با هوش مصنوعی؛ راهکاری برای بهبود عملکرد
در این مقاله از وبلاگ هوما، روش گرمآغاز کردن مدلهای زبانی Encoder-Decoder با استفاده از checkpointهای BERT و GPT2 بررسی میشود. این تکنیک در ترجمه ماشینی، خلاصهسازی و سایر وظایف seq2seq عملکرد بهتری به ارمغان میآورد.
 آموزش
بهینهسازی فراپارامتر در ترنسفورمر با Ray Tune؛ راهنمای عملی
با Ray Tune، تنظیم فراپارامتر مدلهای ترنسفورمر را هوشمندانه انجام دهید و عملکرد مدل را بدون از دست دادن انعطافپذیری بهبود بخشید.