مدلهای زبانی مبتنی بر ترنسفورمر، مانند BERT، با افزایش طول متن دچار چالشی جدی میشوند. پیچیدگی محاسباتی توجه بهصورت درجه دوم رشد میکند و به همین دلیل پردازش اسناد بلند عملاً غیرممکن میشود. مدل BigBird که در سال ۲۰۲۱ معرفی شد، با ارائهٔ «توجه پراکنده بلوکی» راهکاری عملی برای این مسئله ارائه میدهد. در این مقاله به بررسی دقیق این معماری و کاربردهای آن میپردازیم.
مشکل توجه کامل در مدلهای زبانی
در مدلهایی مانند BERT، هر توکن باید به همهٔ توکنهای دیگر توجه کند. این «توجه کامل» باعث میشود حافظه و زمان محاسبات بهطور درجه دوم با طول ورودی افزایش یابد. بهعنوان مثال، اگر طول متن دو برابر شود، نیاز محاسباتی چهار برابر خواهد شد. همین مسئله استفاده از ترنسفورمرها را برای اسناد طولانی مانند مقالات علمی یا قراردادها محدود میکند.
توجه پراکنده بلوکی در BigBird چیست؟
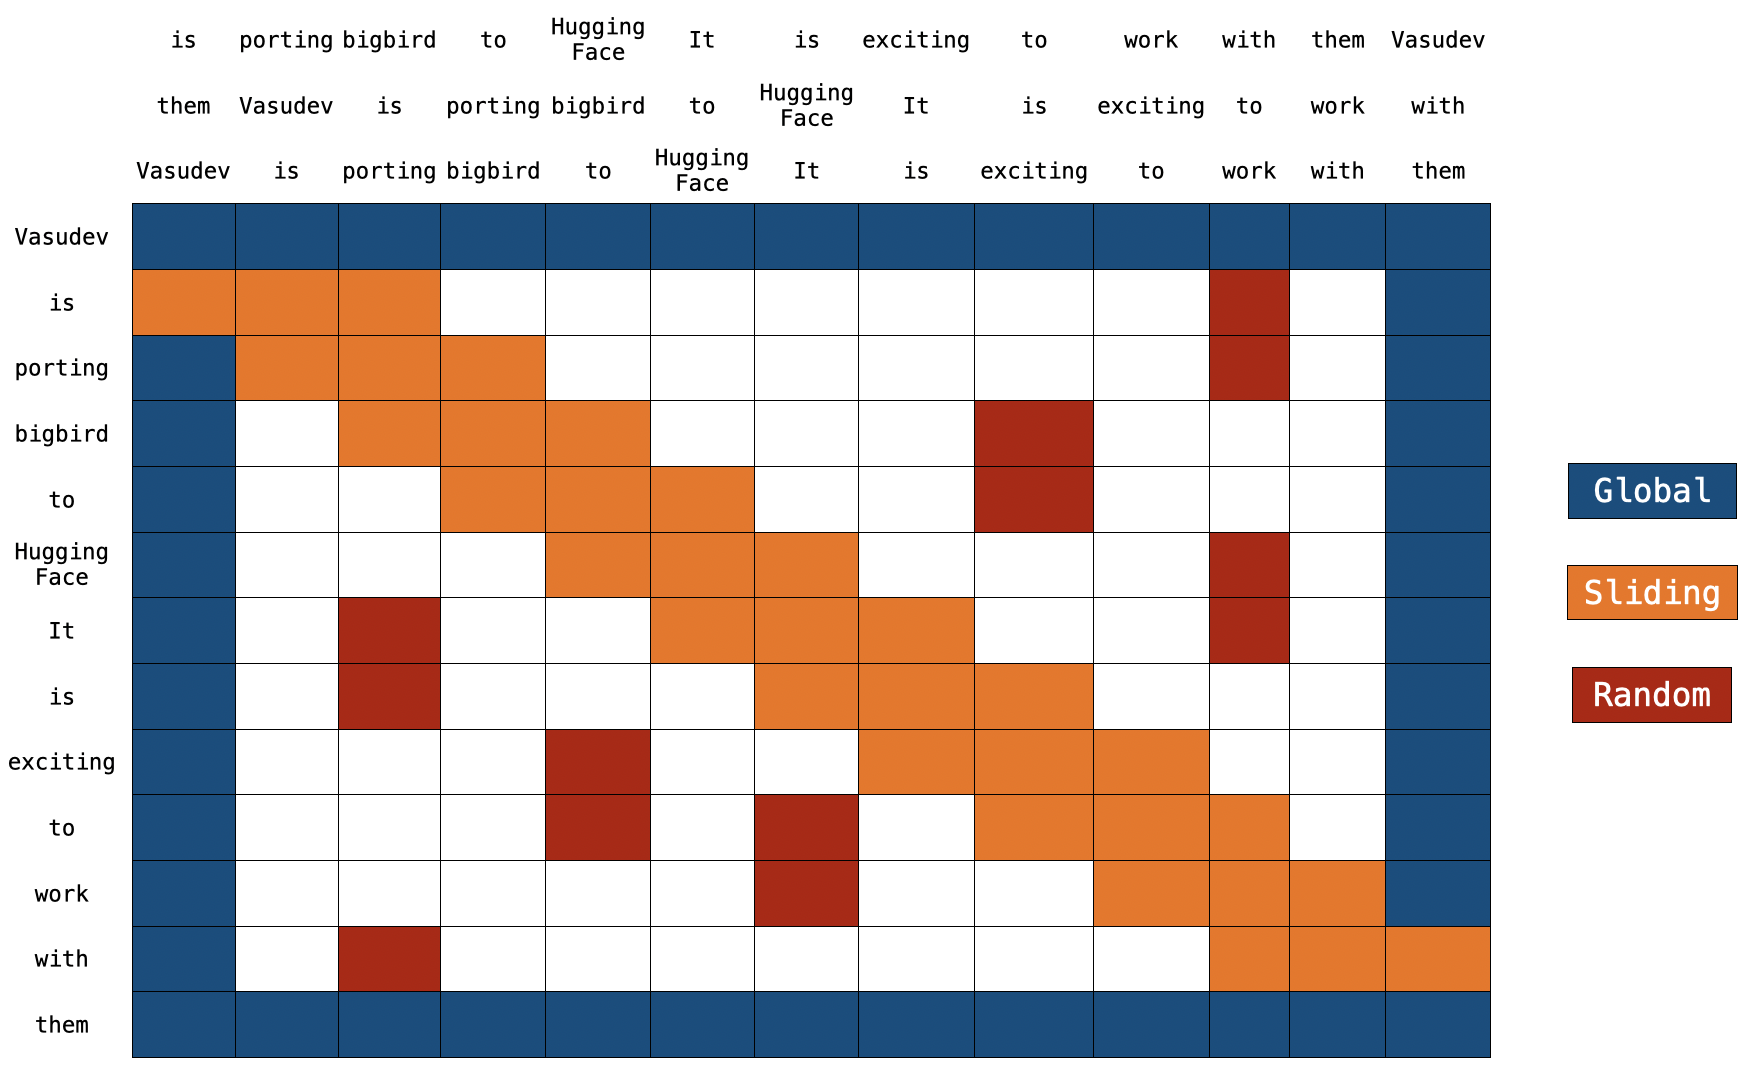
BigBird با معرفی سه نوع توجه، پیچیدگی محاسباتی را به میزان قابل توجهی کاهش میدهد: توجه پنجرهای، توجه جهانی و توجه تصادفی. در توجه پنجرهای، هر توکن به همسایگان محلی خود نگاه میکند. توجه جهانی به توکنهای مشخصی اجازه میدهد به کل دنباله دسترسی داشته باشند و توجه تصادفی نیز اتصالاتی تصادفی ایجاد میکند تا جریان اطلاعات در سراسر دنباله حفظ شود. ترکیب این سه مکانیزم، تقریبی کارآمد از توجه کامل به دست میدهد.
- کاهش هزینه محاسباتی نسبت به توجه کامل
- پشتیبانی از دنبالههایی تا طول ۴۰۹۶ توکن
- عملکرد پیشرو در خلاصهسازی اسناد بلند
- دسترسی آسان از طریق کتابخانه Transformers
کاربردهای BigBird در وظایف زبانی
این مدل در آزمونهای استاندارد مربوط به متنهای طولانی، نتایجی همتراز با مدلهای پیشین و گاه بهتر ارائه داده است. از جمله کاربردهای موفق BigBird میتوان به خلاصهسازی خودکار مقالات بلند و سیستمهای پرسش و پاسخ با زمینهٔ گسترده اشاره کرد. به این ترتیب، هوش مصنوعی میتواند برای تحلیل اسناد حجیم نیز بهکار گرفته شود.
دسترسی به BigBird در Hugging Face
پژوهشگران و توسعهدهندگان میتوانند از طریق کتابخانهٔ Transformers به مدل BigBird دسترسی داشته باشند. این کتابخانه، استقرار مدل را ساده کرده و امکان تنظیم دقیق آن را برای کاربردهای مختلف فراهم میکند. وجود این مدل در پلتفرم Hugging Face نشاندهندهٔ حرکت صنعت به سمت باز و دموکراتیک کردن هوش مصنوعی است.
جمعبندی
BigBird نمونهای از تلاش برای غلبه بر محدودیتهای محاسباتی در مدلهای زبانی است. اگرچه توجه پراکنده یک تقریب است و در شرایط ایدئال توجه کامل بهتر است، اما در دنیای واقعی که منابع محاسباتی محدودند، این روش امکان پردازش متنهای بسیار طولانی را فراهم میکند. به این ترتیب، ابزارهای هوش مصنوعی برای حجم وسیعتری از اطلاعات کاربردی خواهند بود.
پرسشهای پرتکرار
مدل BigBird چه مزیتی نسبت به BERT دارد؟
BigBird با استفاده از توجه پراکنده بلوکی، طول متن تا ۴۰۹۶ توکن را با هزینه محاسباتی بسیار پایینتر پردازش میکند، در حالی که توجه کامل BERT از نظر حافظه رشد درجه دوم دارد.
توجه پراکنده بلوکی چگونه کار میکند؟
این روش ترکیبی از سه نوع توجه است: پنجرهای برای همسایگان محلی، جهانی برای توکنهای کلیدی، و تصادفی برای حفظ ارتباط سراسری. این ترکیب تقریبی کارآمد از توجه کامل فراهم میکند.