
 پژوهش
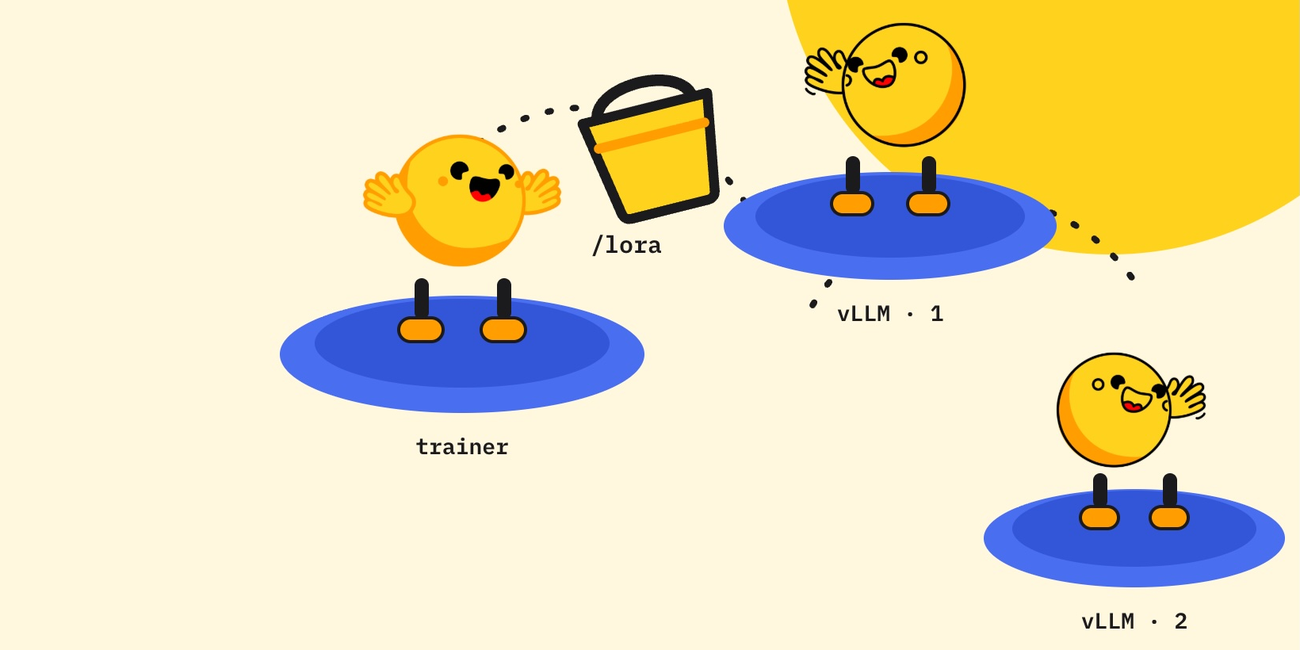
آموزش ناهمزمان GRPO با LoRA؛ گامی نو در هوش مصنوعی متنباز
TRL v1.14 با پشتیبانی LoRA در AsyncGRPOTrainer، آموزش و استنتاج را از هم جدا میکند. مقاله به بررسی معماری سهلایه و استفاده از Storage Buckets میپردازد.
 پژوهش
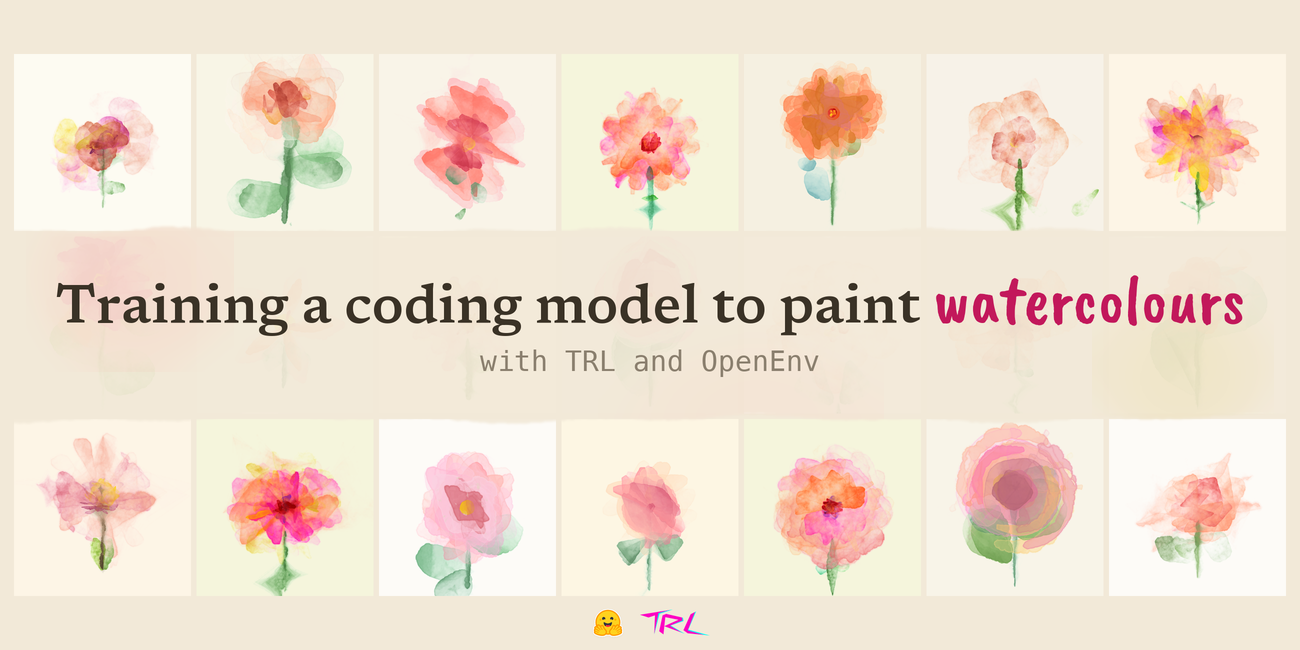
آموزش مدل هوش مصنوعی برای نقاشی آبرنگ با کد جاوااسکریپت
در این مقاله، روشی برای آموزش مدلهای زبانی به منظور خلق نقاشیهای آبرنگ با استفاده از یادگیری تقویتی و محیط باز معرفی میشود. با ما همراه باشید.
 آموزش
افزایش دقت هوش مصنوعی در خروجی ساختاریافته با GRPO و TRL
در این راهنمای متنباز، مدل LFM2.5-350M با روش GRPO و کتابخانه TRL در ۱۰۰ گام آموزش داده میشود و دقت خروجی ساختاریافته از ۲۲.۶٪ به ۲۹.۷٪ میرسد.
 پژوهش
همراهی هزارتن پارامتر: همگامسازی دلتای وزن در هاب با هوش مصنوعی
Hugging Face با فناوری Delta Weight Sync در TRL، همزمانی وزن مدلهای بزرگ را با استفاده از هاب باتک به صورت امن و بهسرعت بالا اجرا میکند؛ راهکاری ساده برای انتقال هزارتن پارامتر.
 محصولات
TRL v1.0 منتشر شد: تحولی در آموزش پسین مدلهای هوش مصنوعی
TRL v1.0 با پشتیبانی از بیش از ۷۵ روش آموزش پسین، به ابزاری پایدار برای تولید تبدیل شده است و طراحی آن برای حرکت با نیازهای میدان تکامل مییابد.
 محصولات
20 برابر سریعتر! RapidFire AI: فاین‑تینینگ مدلهای هوش مصنوعی به سرعت 20×
RapidFire AI با یکپارچهسازی خود با Hugging Face TRL، امکان فاین‑تینینگ مدلهای زبانی را در زمان چندین برابر سرعتسازی میکند؛ در آزمایشهای داخلی به دست آوردن 16‑24× تسریع در مقایسه با روشهای متوالی.
 پژوهش
هوش مصنوعی: نحوه همسو سازی مدلهای دید-زبان در TRL جدید و بهروز
در این مقاله به بررسی روشهای نوین همسو سازی مدلهای دید‑زبان در فریمورک TRL پرداخته، مقایسهای بین MPO، GRPO و GSPO ارائه کرده و کاربردهای عملی در علوم و صنعت را بررسی میکنیم.
 پژوهش
هوش مصنوعی بدون GPU: چگونگی افزایش کارایی با vLLM هممحور در TRL
این مقاله روش Co‑Located vLLM در TRL را معرفی و نشان میدهد چگونه با استفاده از GPUهای مشترک، کارایی مدلهای LLM را بدون هزینه اضافی به حداکثر میرساند.
 پژوهش
هوش مصنوعی در Liger GRPO: تقویت TRL با بهینهسازی حافظه و مقیاسپذیری
در این خبر، Liger GRPO با کاهش مصرف حافظه ۴۰٪ و افزودن امکانات FSDP و PEFT، آموزش RL را برای مدلهای بزرگ بهینه میکند و به تسهیل مقیاسپذیری در چند گپ تبدیل میشود.
 پژوهش
بهینهسازی ترجیح برای مدلهای دید-زبان: گام جدیدی در هوش مصنوعی
پیشنیازهای جدیدی برای مدلهای دید-زبان، از طریق بهینهسازی ترجیح و کتابخانه TRL که در هگینگی فیس معرفی شده، امکان آموزش دقیقتر و مقرونبهصرفهتر را فراهم میکند.