
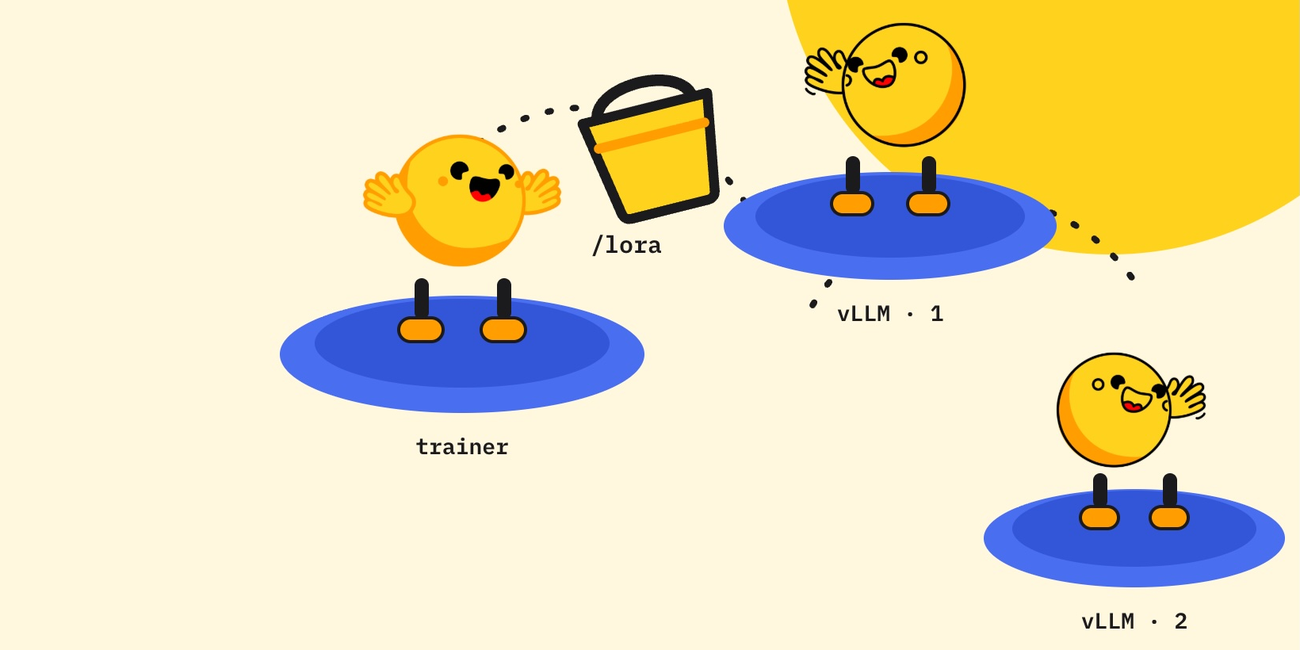
در دنیای امروز، آموزش مدلهای زبانی بزرگ به یکی از پیچیدهترین چالشهای مهندسی هوش مصنوعی تبدیل شده است. خوشبختانه، اکوسیستم متنباز Hugging Face با معرفی قابلیت جدید در TRL v1.14، گامی بلند در جهت سادهسازی این فرایند برداشته است. با پشتیبانی از LoRA در AsyncGRPOTrainer، حالا میتوان آموزش و استنتاج را بهطور کامل از یکدیگر جدا کرد و بدون نیاز به NCCL، مدلها را در مقیاس وسیع آموزش داد.
معماری سهلایه: آموزش، استنتاج و یک پروکسی هوشمند
در این رویکرد جدید، سه Job جداگانه روی زیرساخت Hugging Face Jobs اجرا میشوند. هر Job مسئولیت خاصی را بر عهده دارد و ارتباط میان آنها از طریق Storage Buckets انجام میشود. این طراحی نهتنها پیچیدگیهای شبکهای را کاهش میدهد، بلکه انعطافپذیری بالایی برای تیمهای محقق فراهم میکند.
- vLLM replicas: سرویس استنتاج که پاسخهای مدل را تولید میکند و بهعنوان محیط تعامل با محیطهای یادگیری تقویتی عمل میکند.
- Trainer: وظیفه آموزش و بهروزرسانی وزنهای LoRA را بر عهده دارد و بهجای مدل کامل، فقط آداپترها را همگامسازی میکند.
- Proxy: نقش مسیریاب را ایفا میکند و با استفاده از پیشوند KV، درخواستها را بین آموزش و استنتاج هماهنگ میکند.
همگامسازی سبک؛ بدون نیاز به NCCL
یکی از نکات قابل توجه این مقاله، حذف وابستگی به NCCL است. در معماری سنتی، آموزش و استنتاج نیازمند ارتباط مستقیم و پرسرعت بین GPUها هستند. اما با استفاده از Storage Buckets بهعنوان بستر ارتباطی، تبادل دادهها بهسادگی انجام میشود. آداپترهای LoRA بهصورت دورهای روی سرورهای استنتاج بارگذاری میشوند و نتایج بهصورت Rollout از طریق همان بستر بازگردانده میشوند.
آزمایشهای تجربی و تعقیب تنگناها
تیم Hugging Face برای ارزیابی این معماری، مجموعهداده «Sanity set» را انتخاب کردند و پنج پیکربندی مختلف را آزمایش کردند. این آزمایشها از یک Trainer که توان همگامسازی نداشت تا تنظیمات پیشرفتهتر با سه نسخه vLLM را شامل میشد. مهمترین یافته، شناسایی تنگنا در محاسبات Forward بود که با تکنیک Packing مایکروبچ حل شد.
نتایج نشان میدهد که با حذف checkpointing اضافی و افزایش درخواستهای همزمان، میتوان به بهرهوری بسیار بالاتری رسید. جدول امتیازات نهایی در ادامه مقاله، مقایسه کاملی از پنج اجرا را نمایش میدهد.
جمعبندی: قدمی به سوی آموزش نامتقارن در هوش مصنوعی
ترکیب Async GRPO با LoRA یک الگوی قدرتمند برای پروژههای واقعی است. این قابلیت در PR #7017 به TRL اضافه شده و از نسخه v1.14 در دسترس عموم قرار دارد. توسعهدهندگان میتوانند همین امروز این الگو را روی زیرساخت Hugging Face پیادهسازی کنند و از مزایای جداسازی کامل آموزش و استنتاج بهرهمند شوند.
پرسشهای پرتکرار
Async GRPO با LoRA چه مزیتی نسبت به روشهای سنتی دارد؟
این روش بهجای همگامسازی مدل کامل، فقط آداپترهای LoRA را بین آموزش و استنتاج منتقل میکند. این کار باعث کاهش حجم ارتباطات، حذف نیاز به NCCL و جداسازی کامل زیرساخت آموزش و استنتاج میشود.
از کدام نسخه TRL میتوان از AsyncGRPOTrainer با LoRA استفاده کرد؟
این قابلیت در PR #7017 اضافه شده و از نسخه v1.14 به بعد در دسترس است.


