
 مدلها
مدل بزرگ هوش مصنوعی Beam با ۵۰۱ میلیارد پارامتر منتشر شد
مدل باز Beam با ۵۰۱ میلیارد پارامتر از Reflection منتشر شد؛ معماری MoE با ۲۳ میلیارد پارامتر فعال، زمینه ۱ میلیون توکن و تمرکز بر کدنویسی و عاملها.
 پژوهش
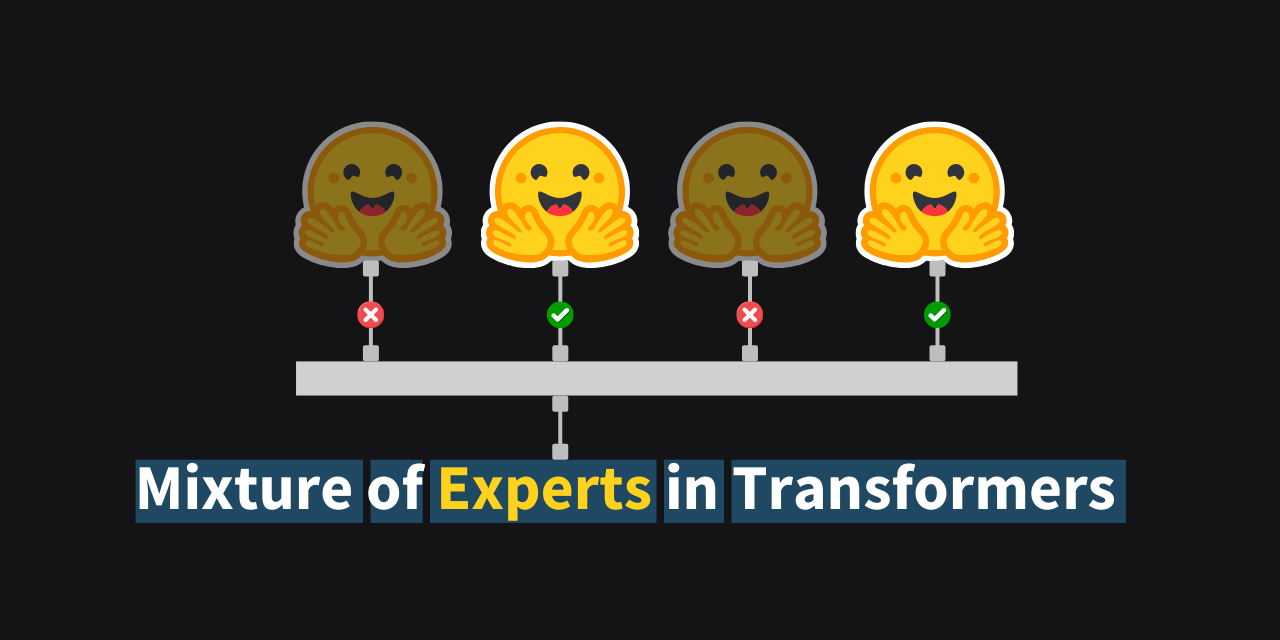
هوش مصنوعی در ترنسفورمرها: MoE (Mixture of Experts) و انقلاب در مدلها
مروری بر هندسه «Mixture of Experts» در ترنسفورمرها، چگونگی افزایش مقیاسپذیری مدلهای زبانی و نقش آن در آیندهی هوش مصنوعی. این مقاله به بررسی معماری MoE، بارگذاری وزن، و نتایج اجرای آن میپردازد.
 پژوهش
چین با معماریهای نوآورانه، هوش مصنوعی را به سطح جدیدی میبرد
در دو سال گذشته، چین با انتخابهای معماریی نوین، مدلهای کوچک و تخصصی، و لایسنسهای باز، جایگاه پیشرو در اکوسیستم هوش مصنوعی متنباز را تثبیت کرده است.
 مدلها
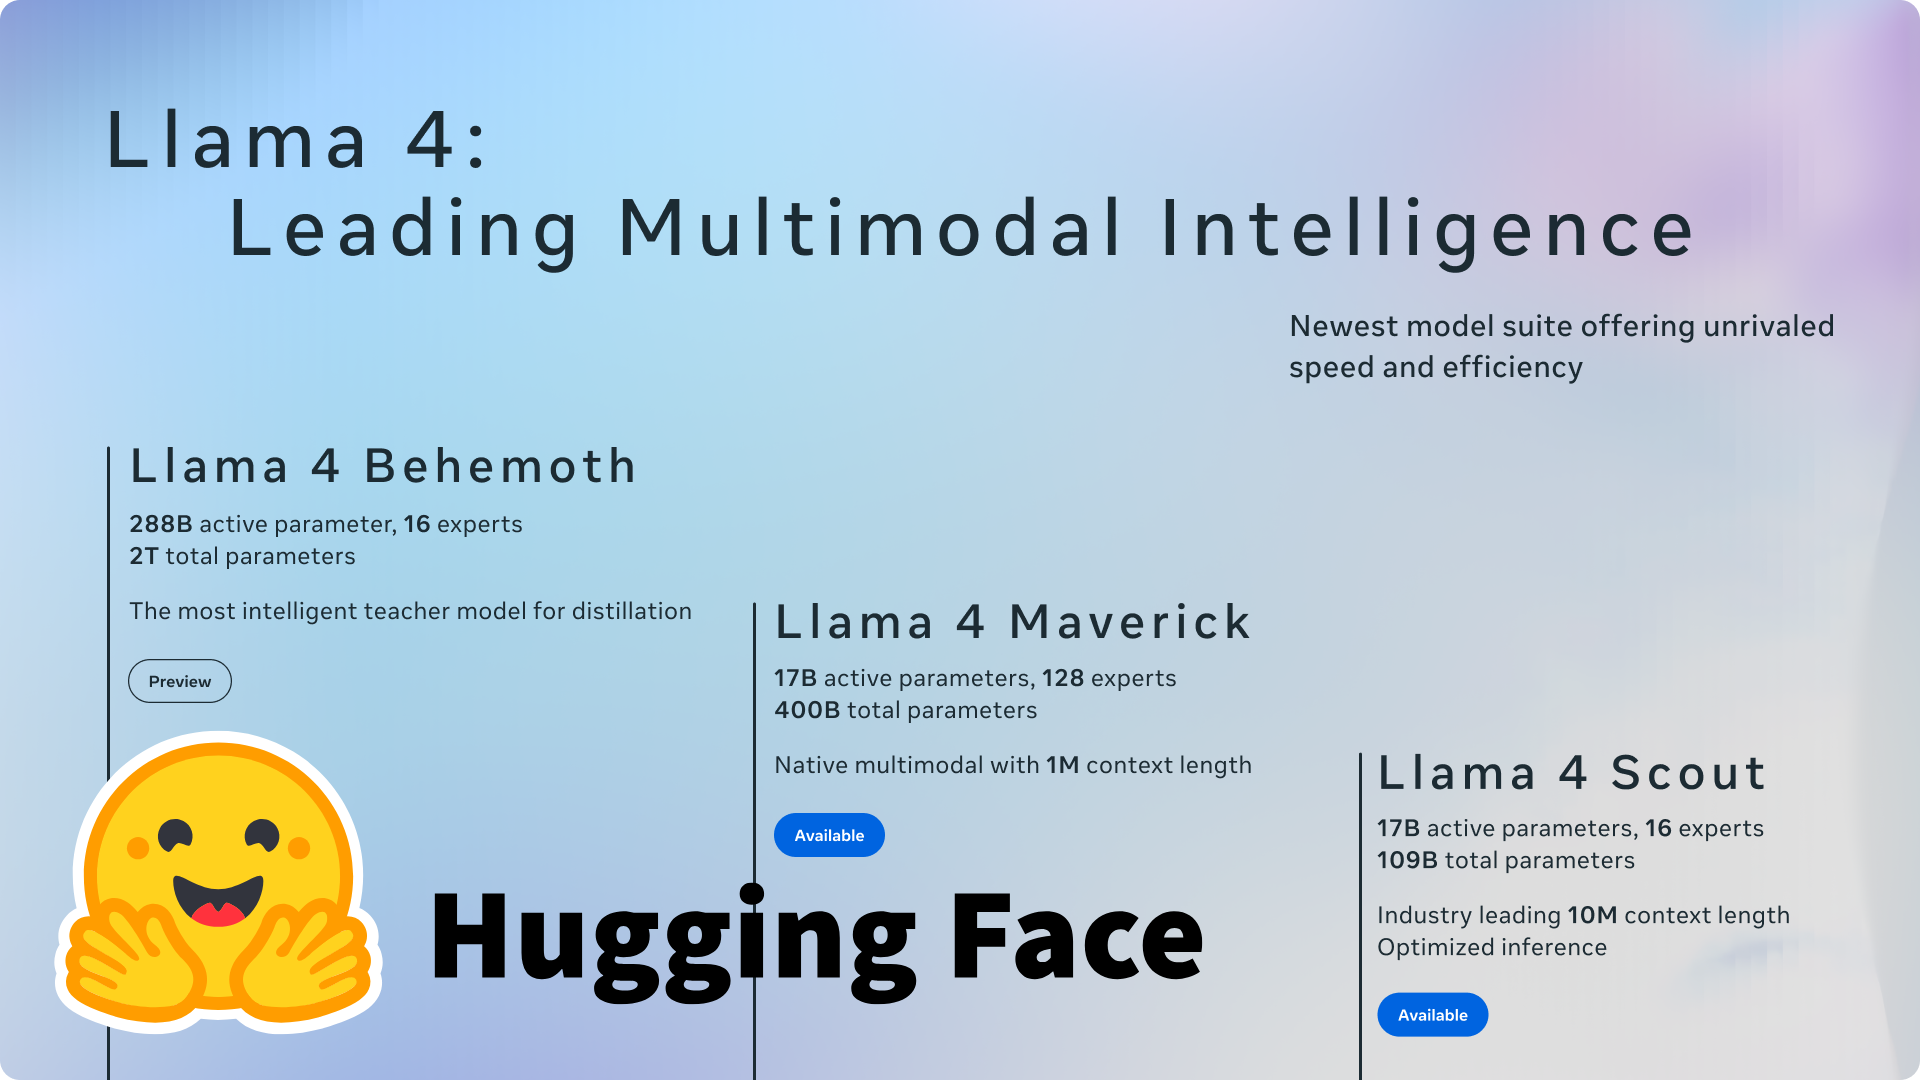
Meta با Llama 4 Maverick و Scout: گام جدید در هوش مصنوعی بر روی Hugging Face
Meta با انتشار Llama 4 Maverick و Scout، دو مدل جدید 400B و 109B را به مجموعه هوش مصنوعی هاب Hugging Face افزوده، ادغام نیتیو مدیآمل و مِیرویکد را فراهم کرد.
 مدلها
SegMoE: چارچوبی نوین برای ترکیب مدلهای هوش مصنوعی تصویرساز
SegMoE چارچوبی برای ساخت مدلهای انتشار ترکیبی است که با الهام از Mixtral 8x7b، چند مدل را در یک مدل واحد ادغام میکند. با پشتیبانی کامل از Hugging Face و diffusers، ساخت مدل شخصی شما تنها چند دقیقه زمان میبرد.
 مدلها
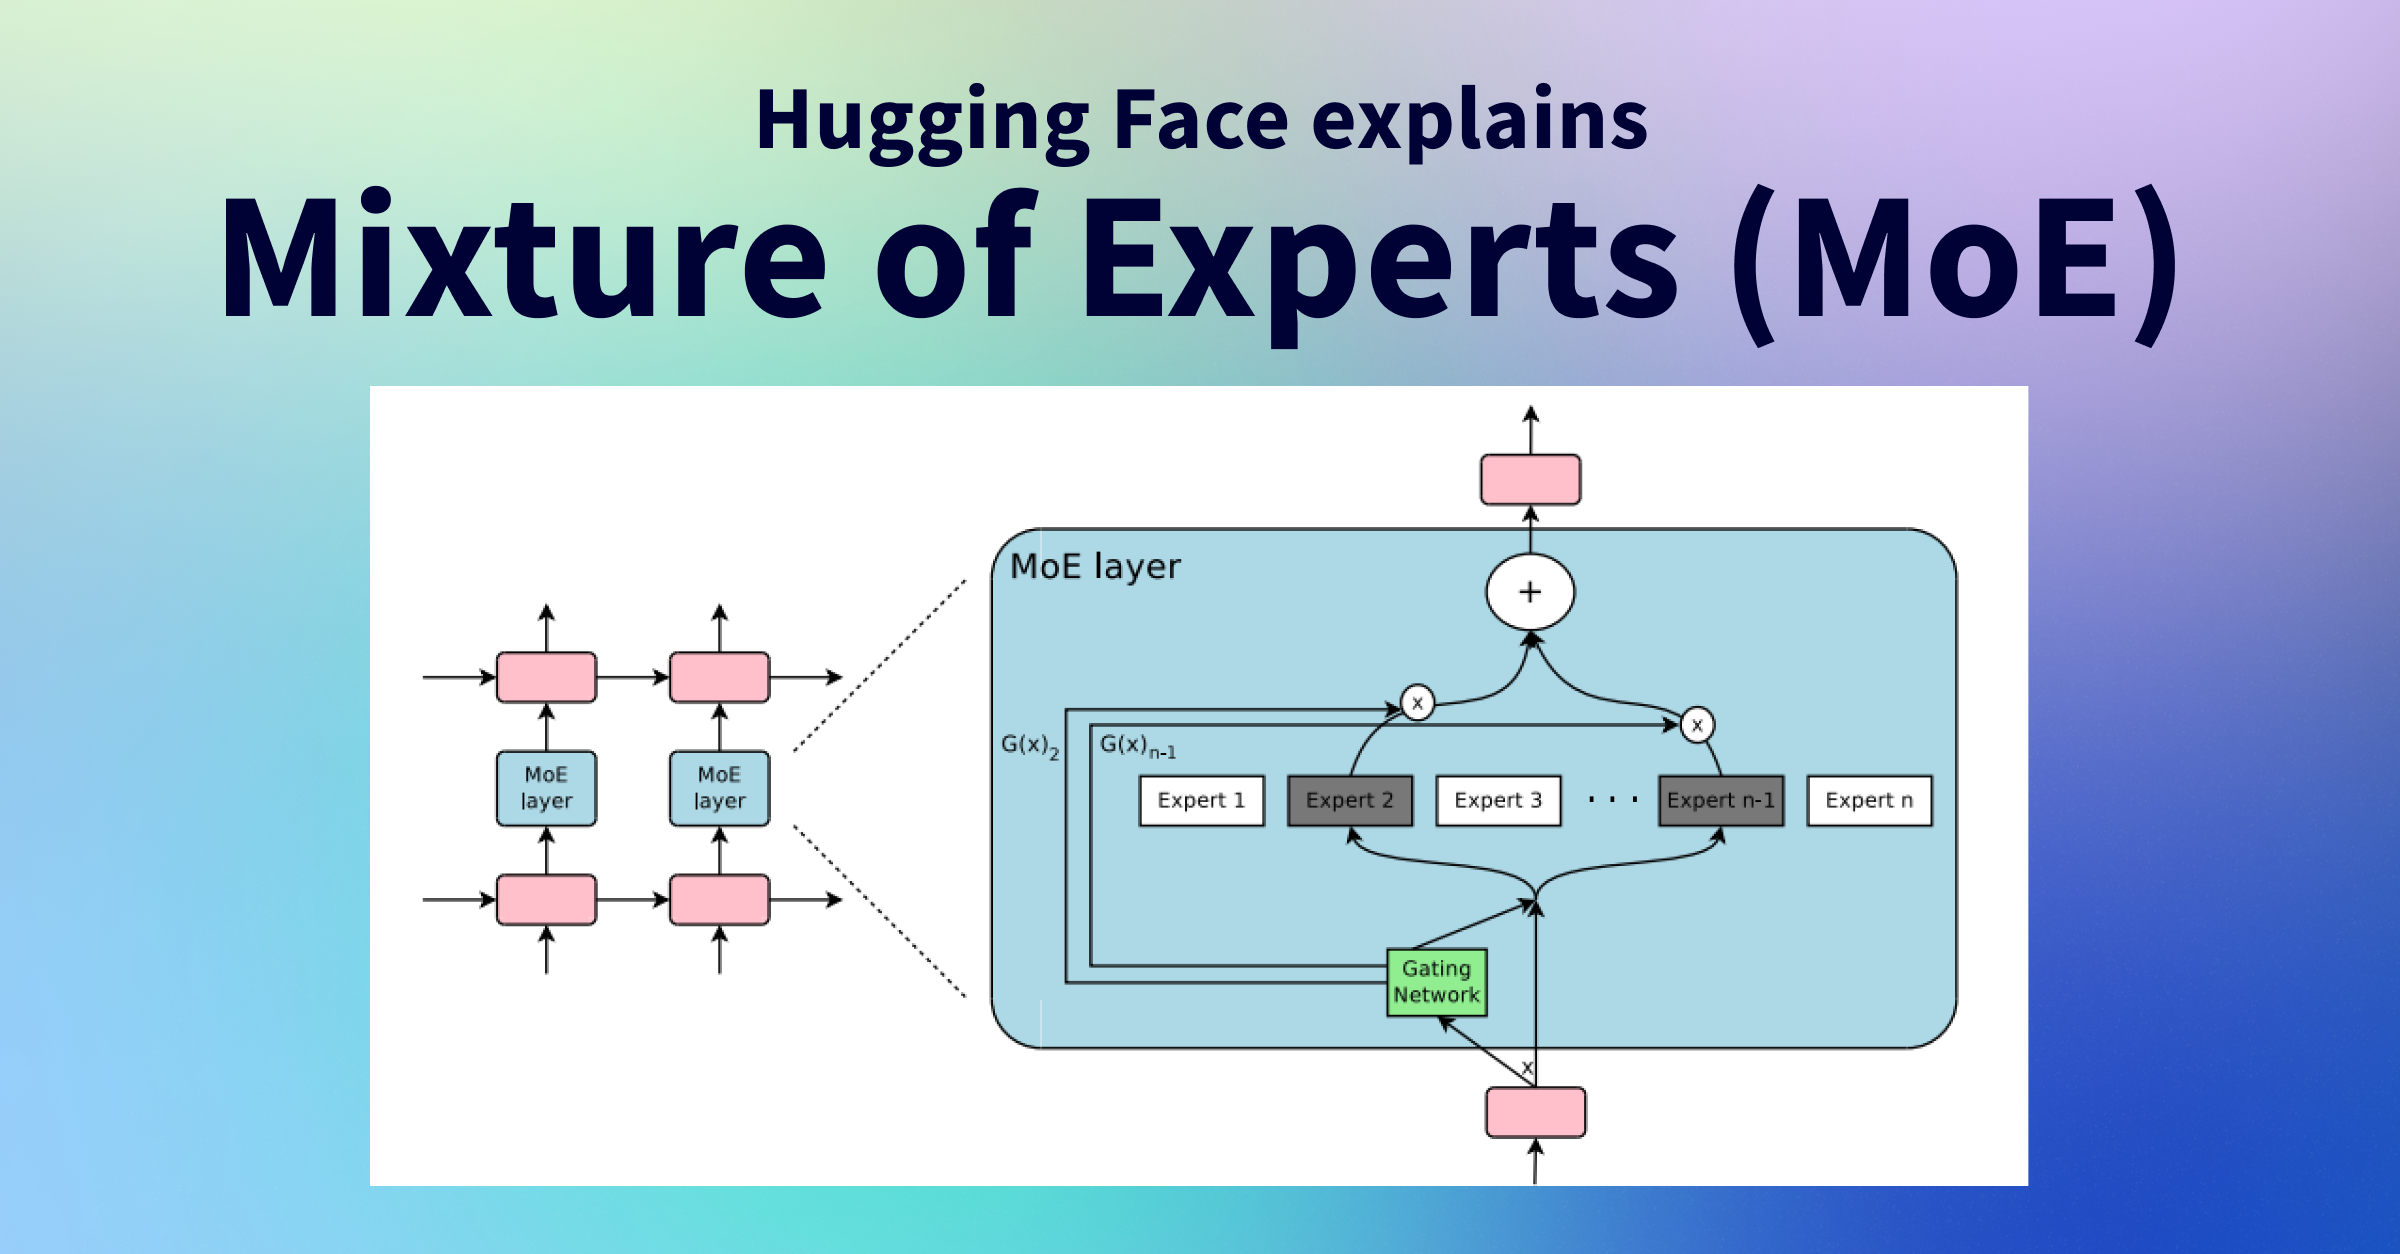
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 مدلها
هوش مصنوعی در Mixtral: مدل 8×7B مبتنی بر Mixture of Experts
مدل Mixtral با 8 expert در قالب Mixture of Experts، سریعتر از 12B و ثمرهدار 4× نسبت به 7B است؛ در دسترس بهصورت متنباز برای پژوهشگران هوش مصنوعی.