معرفی Llama 4 Maverick و Scout
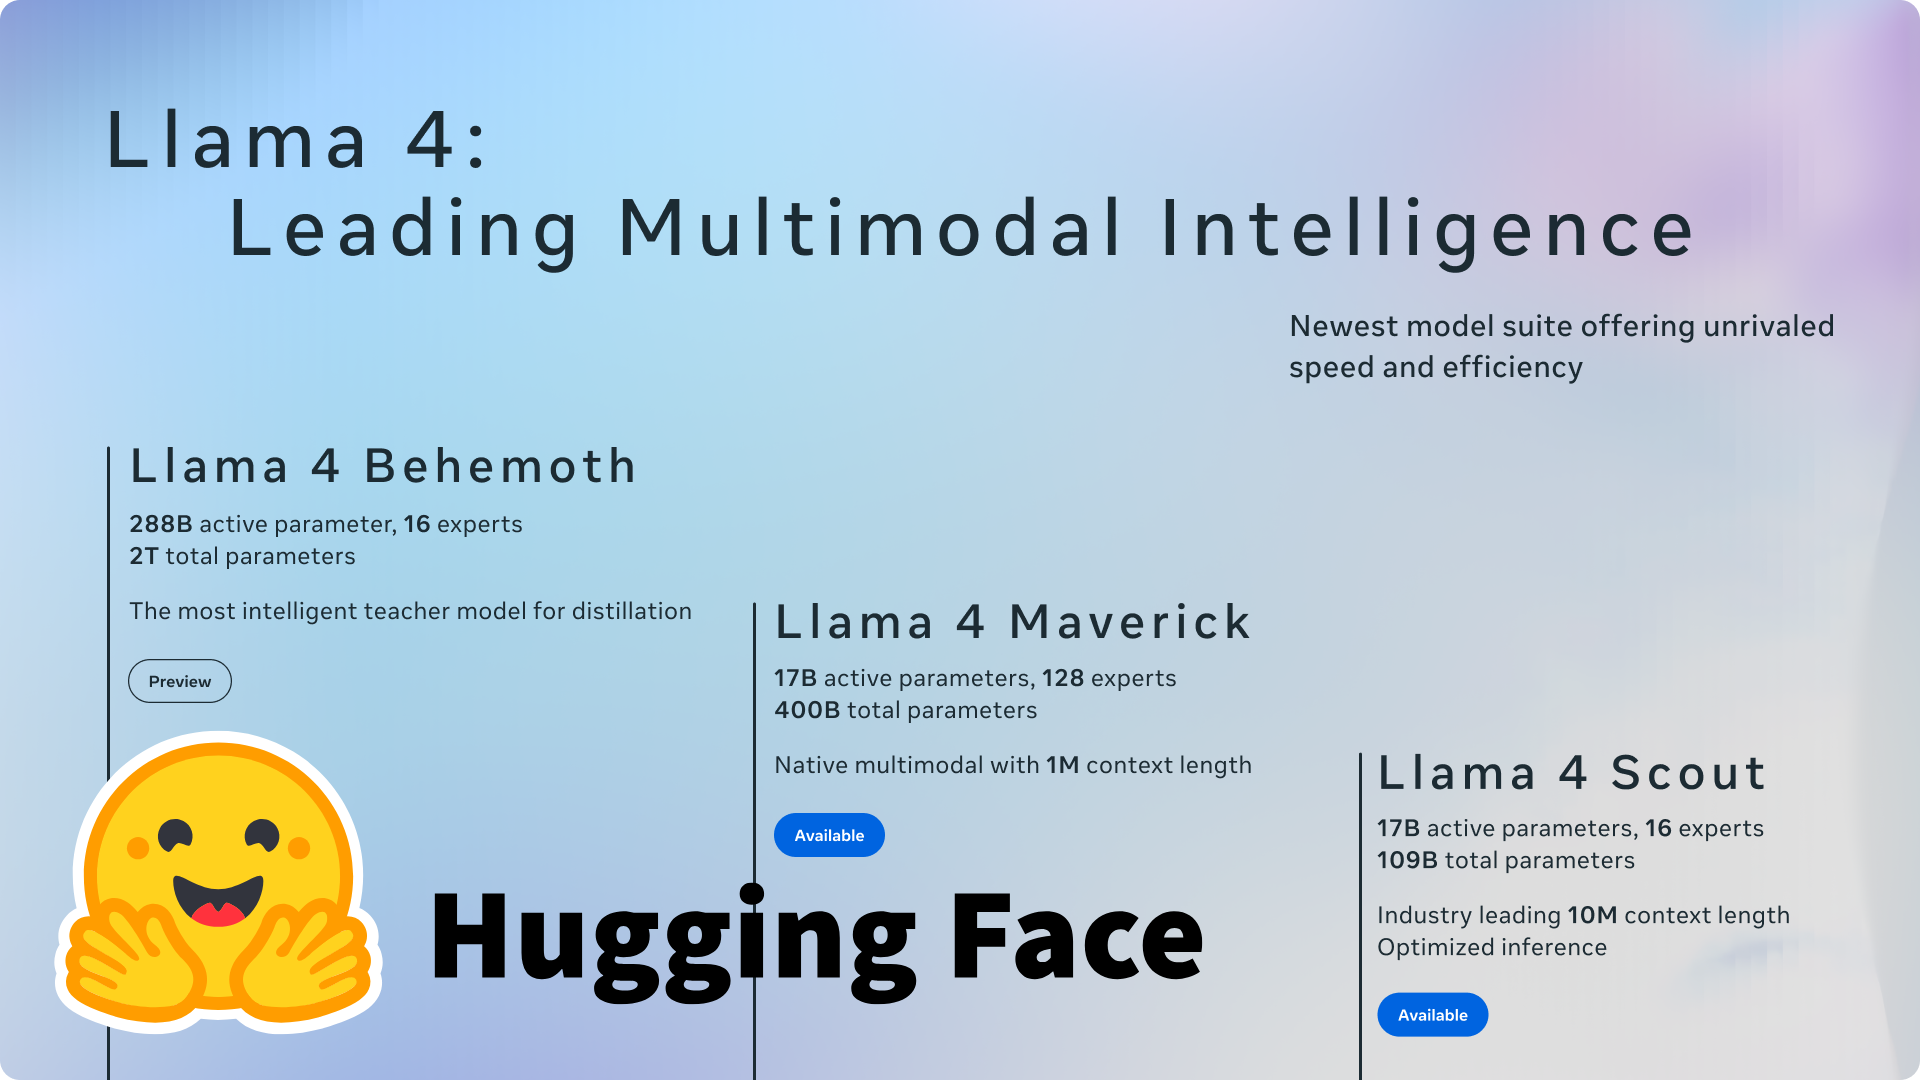
Meta در تاریخ ۵ آوریل ۲۰۲۵ با انتشار دو مدل بزرگ زبان جدید، Llama 4 Maverick (~400B) و Llama 4 Scout (~109B)، سامانه هوش مصنوعی هاب Hugging Face را گسترش داد. این مدلها با قابلیت شفافیت و دموکراتیکسازی هفت گوشهٔ علم مصنوعی، جزوی اساسی از مسیر پیشرفت سریع هوش مصنوعی را تشکیل میکنند.
ویژگیهای فنی و معماری
هر دو مدل بهصورت Mixture of Experts (MoE) طراحی شدهاند، اما تنها 17 مگابایت پارامتر فعال در زمان اجرا بهکار میروند. ساختار دهچند زره (decentralized attention)، الگوریتم پیشرفتهٔ سورِس-مِش (sparse mixture) و قابلیت چندرسانهای (متن، تصویر و صدا) این مدلها را برای کاربردهای متنوع سوق میدهد.
- کاهش مصرف حافظه و افزایش سرعت پردازش بهصورت مقیاسپذیر
- قابلیت چندمنظوره: متنی، تصویری، صوتی در یک معماری UGB و LLaMA
- پشتیبانی جامع در Transformers و TGI (Text Generation Inference) از ابتدای راهاندازی
- دسترسپذیری حاوی مستندات جامع، قالبهای نمونه و APIهای معتبر در هاب زبانهایتان
چگونه از مدلها استفاده کنید؟
برای همسانسازی مدلها با محیطهای محلی یا سرورهای ابری، کافی است بستهٔ transformers را نصب کرده و مدل مورد نظر را از هاب بکشید. برای توسعهٔ کاربردهای متنی یا چندرسانهای، مستندات و کدهای نمونهٔ HuggingChat و Inference Endpoints را بررسی کنید. برای مشاهده نتایج بهتر، تنظیم پارامترهای درایهٔ مدل همچون temperature و top_p میتواند کمک شایانی نماید.
پرسشهای پرتکرار
چه تغییراتی در Llama 4 Maverick و Scout معرفی شده است؟
Llama 4 Maverick (~400B) و Scout (~109B) مدلهای Mixture of Experts با 17 مگابایت پارامتر فعال هستند، قابلیت چندمنظوره (متن، تصویر و صدا) و ادغام کامل در هاب Hugging Face از جمله ویژگیهای اصلی این نسخهٔ جدید محسوب میشود.
چگونه میتوانم به سرعت به Llama 4 در هاب دسترسی پیدا کنم؟
به سادگی از خط فرمان یا کتابخانهٔ <code>transformers</code> مدل مورد نظر را بارگیری کنید: <pre> from transformers import AutoModelForCausalLM model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-4-Maverick") </pre>و سپس آن را در مدل TGI یا Inference Endpoints خود پیاده کنید.