
 پژوهش
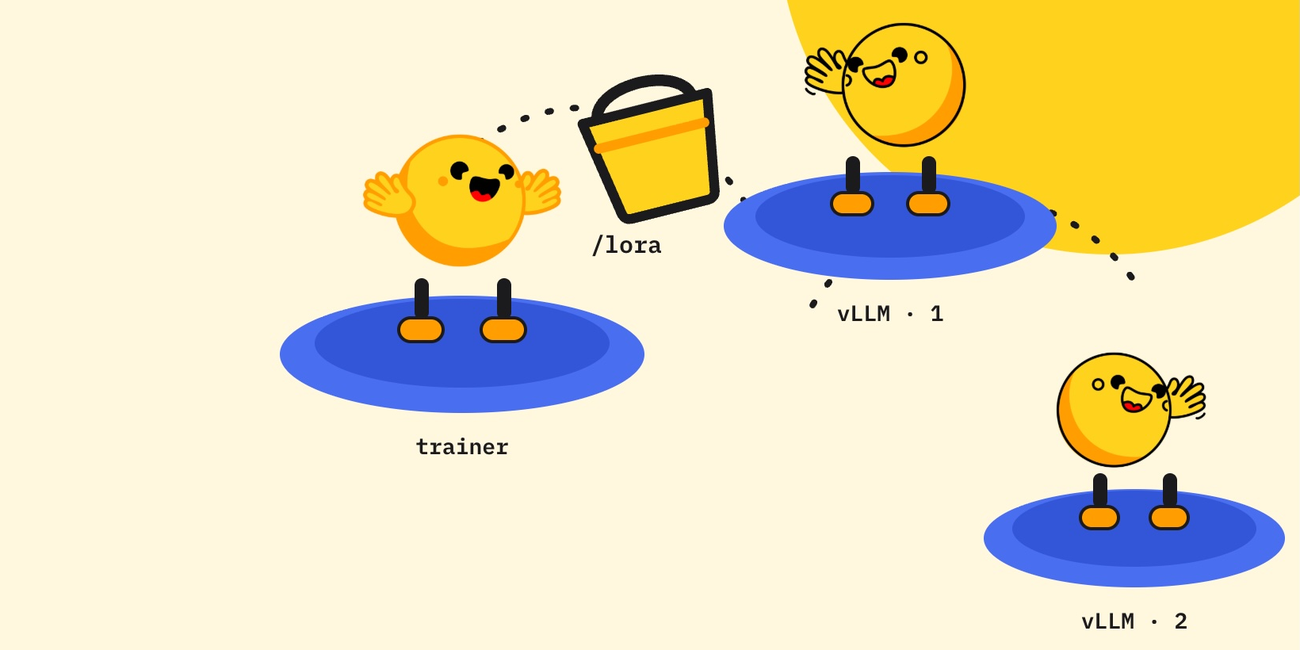
آموزش ناهمزمان GRPO با LoRA؛ گامی نو در هوش مصنوعی متنباز
TRL v1.14 با پشتیبانی LoRA در AsyncGRPOTrainer، آموزش و استنتاج را از هم جدا میکند. مقاله به بررسی معماری سهلایه و استفاده از Storage Buckets میپردازد.
 آموزش
افزایش دقت هوش مصنوعی در خروجی ساختاریافته با GRPO و TRL
در این راهنمای متنباز، مدل LFM2.5-350M با روش GRPO و کتابخانه TRL در ۱۰۰ گام آموزش داده میشود و دقت خروجی ساختاریافته از ۲۲.۶٪ به ۲۹.۷٪ میرسد.
 محصولات
TRL v1.0 منتشر شد: تحولی در آموزش پسین مدلهای هوش مصنوعی
TRL v1.0 با پشتیبانی از بیش از ۷۵ روش آموزش پسین، به ابزاری پایدار برای تولید تبدیل شده است و طراحی آن برای حرکت با نیازهای میدان تکامل مییابد.
 پژوهش
هوش مصنوعی در ریاضیات: معرفی DeepMath، عامل ریاضی سبک و سریع
DeepMath، عامل هوش مصنوعی سبک و دقیق برای حل مسائل ریاضی، با استفاده از GRPO و مدل Qwen3-4B، طول خروجی را ۶⁶٪ کاهش میدهد و دقت را بهبود میبخشد.
 پژوهش
هوش مصنوعی: نحوه همسو سازی مدلهای دید-زبان در TRL جدید و بهروز
در این مقاله به بررسی روشهای نوین همسو سازی مدلهای دید‑زبان در فریمورک TRL پرداخته، مقایسهای بین MPO، GRPO و GSPO ارائه کرده و کاربردهای عملی در علوم و صنعت را بررسی میکنیم.
 پژوهش
هوش مصنوعی در Liger GRPO: تقویت TRL با بهینهسازی حافظه و مقیاسپذیری
در این خبر، Liger GRPO با کاهش مصرف حافظه ۴۰٪ و افزودن امکانات FSDP و PEFT، آموزش RL را برای مدلهای بزرگ بهینه میکند و به تسهیل مقیاسپذیری در چند گپ تبدیل میشود.