
 اخبار
هوش مصنوعی و ارزیابی نوآوری علمی: گزارش جدید AI2 در بستر علمی کاوش
پژوهشی بهروز در AI2 که بررسی میکند LLMها در ارزیابی نوآوریهای علمی به چه اندازه قابل اعتماد هستند و بنچمارک جدیدی ارائه میدهد.
 محصولات
Kimi K3.1 Pro؛ پیروزی بیسابقه در هوش مصنوعی چین بر رقابت GPT-6
مدل هوش مصنوعی Kimi K3.1 Pro، قدرتی بیهمتا در چین، در بنچمارکهای مختلف از GPT-6 Astra و Claude Fable 5.1 پیشی گرفته و نگاه جدیدی به رقابت جهانی میاندازد.
 مدلها
جمنای ۴ آرگون؛ مدل پرچمدار تازه گوگل با هوش مصنوعی پیشرفته و قیمت ساختارشکن
گوگل پس از ماهها عقبماندگی، مدل هوش مصنوعی پرچمدار جمنای ۴ آرگون را با استدلال پیشرفته و قیمت ساختارشکن معرفی کرد. عملکرد این مدل در بنچمارکهای گوناگون، رقبایی چون GPT-6 و کلود را پشت سر گذاشته است.
 پژوهش
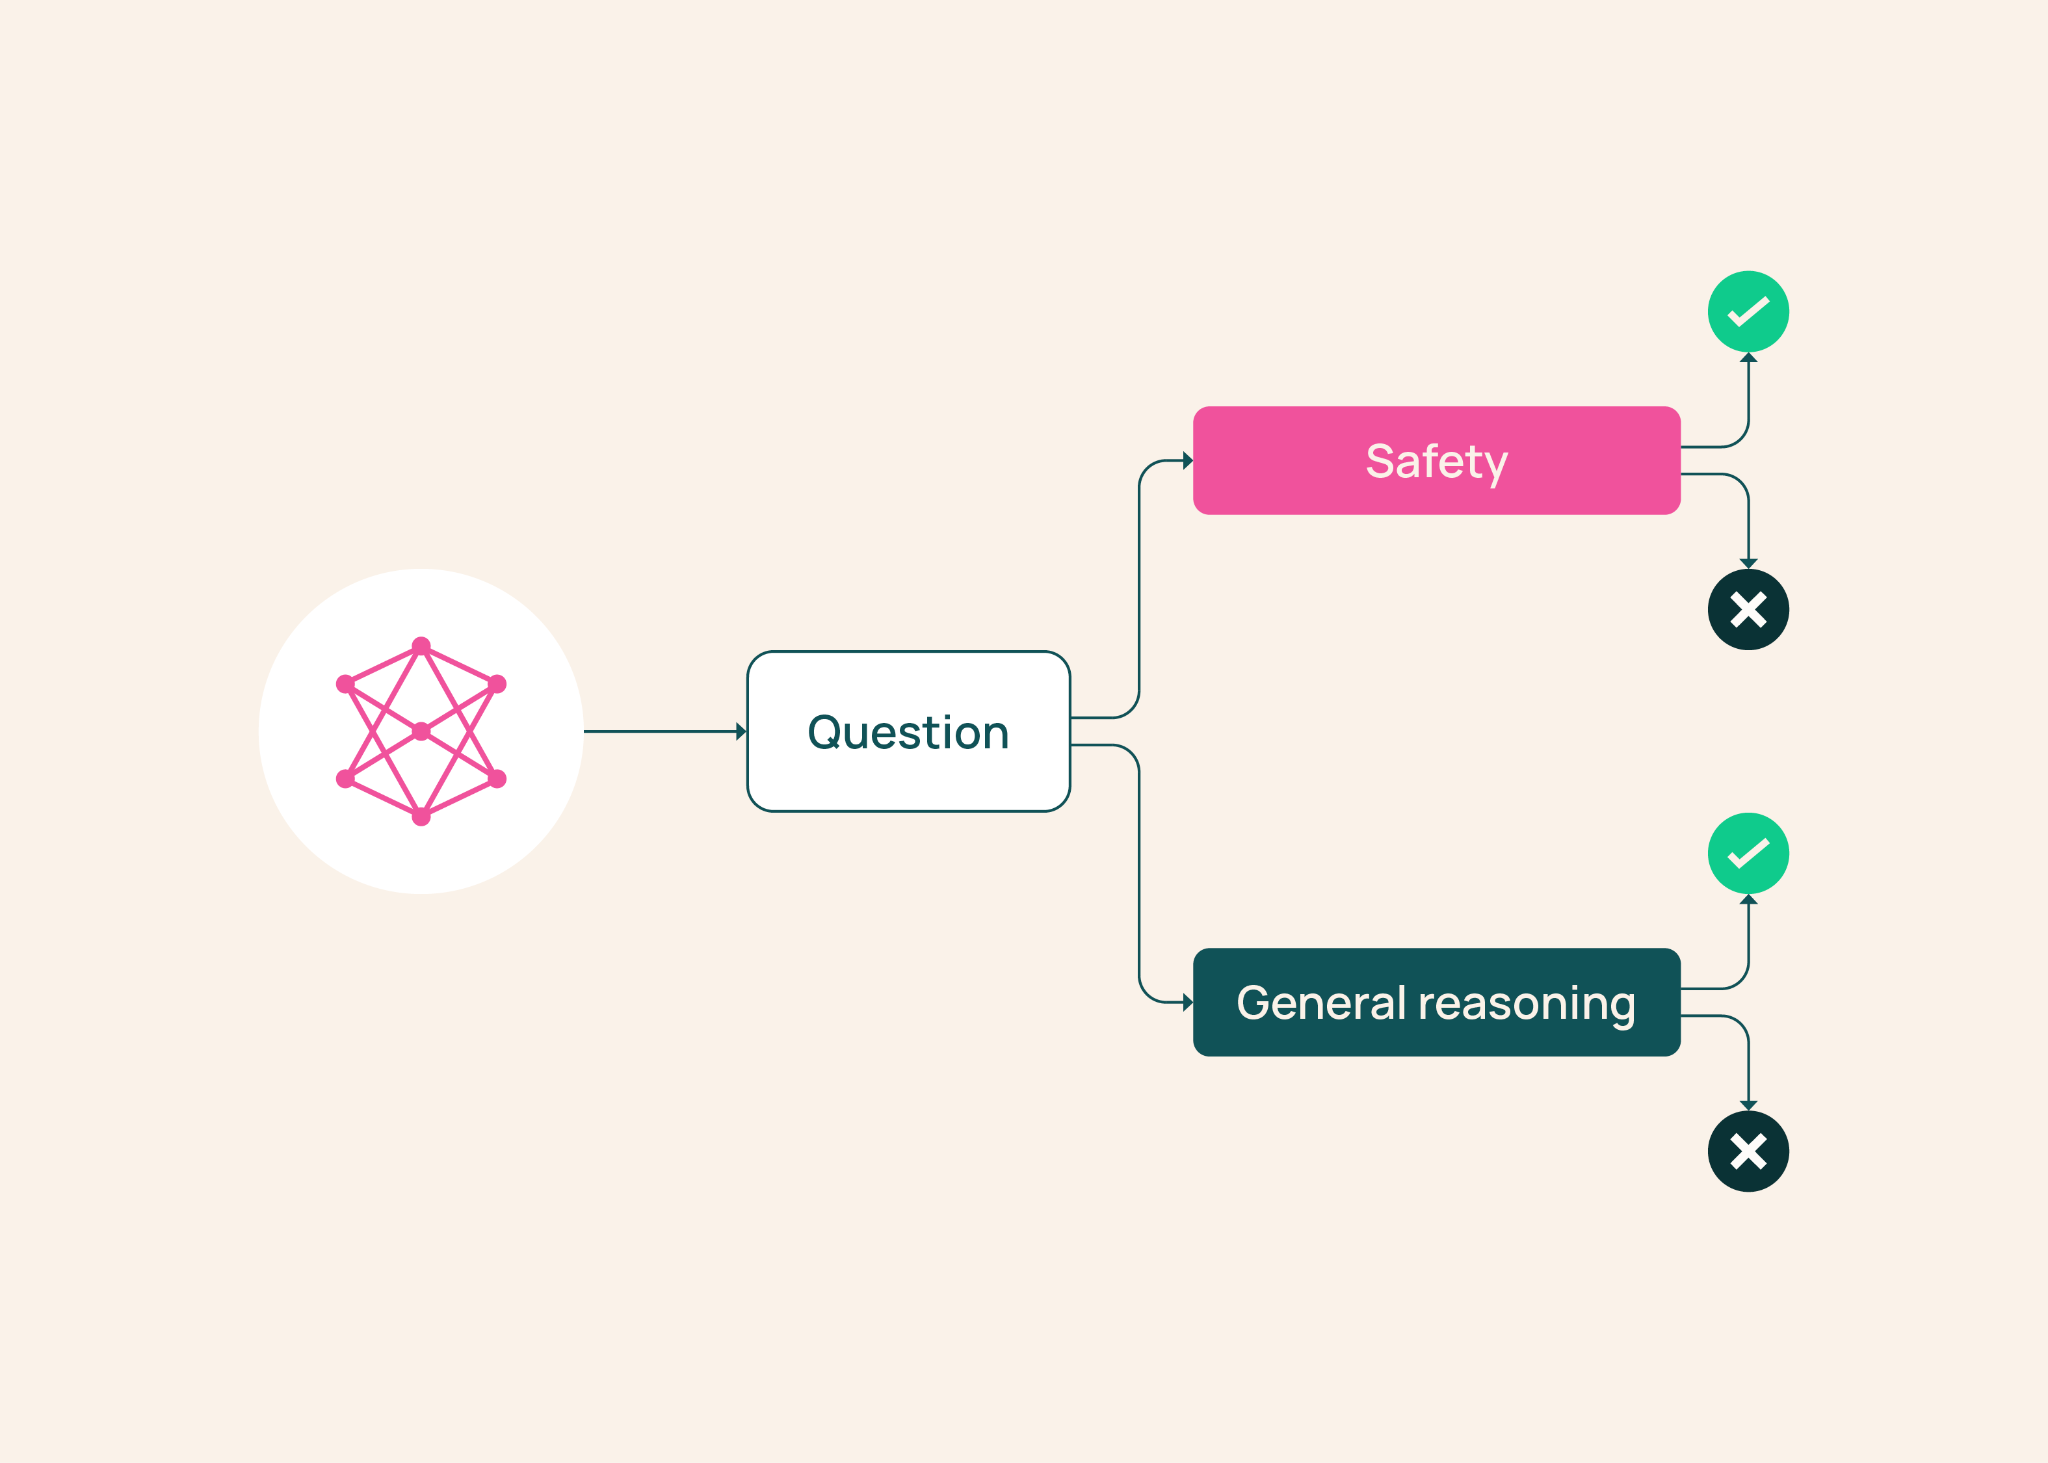
BenchMIRT: آنچه معیارهای هوش مصنوعی واقعاً اندازه میگیرند
BenchMIRT روشی نوین از Ai2 برای ممیزی معیارهای مدلهای زبانی در سطح تکتک پرامپتهاست؛ این رویکرد نشان میدهد معیارها واقعاً تواناییهای اصلی را میسنجند یا نه.
 پژوهش
آیا نمره هوش مصنوعی در تشخیص گفتار واقعاً معتبر است؟
بمباران دادههای هوش مصنوعی باعث بهینهسازی غیراصولی مدلها در بنچمارکهای تشخیص گفتار شده است. در این مطلب بررسی میکنیم که چرا نمرات بنچمارکها ممکن است گمراهکننده باشند.
 پژوهش
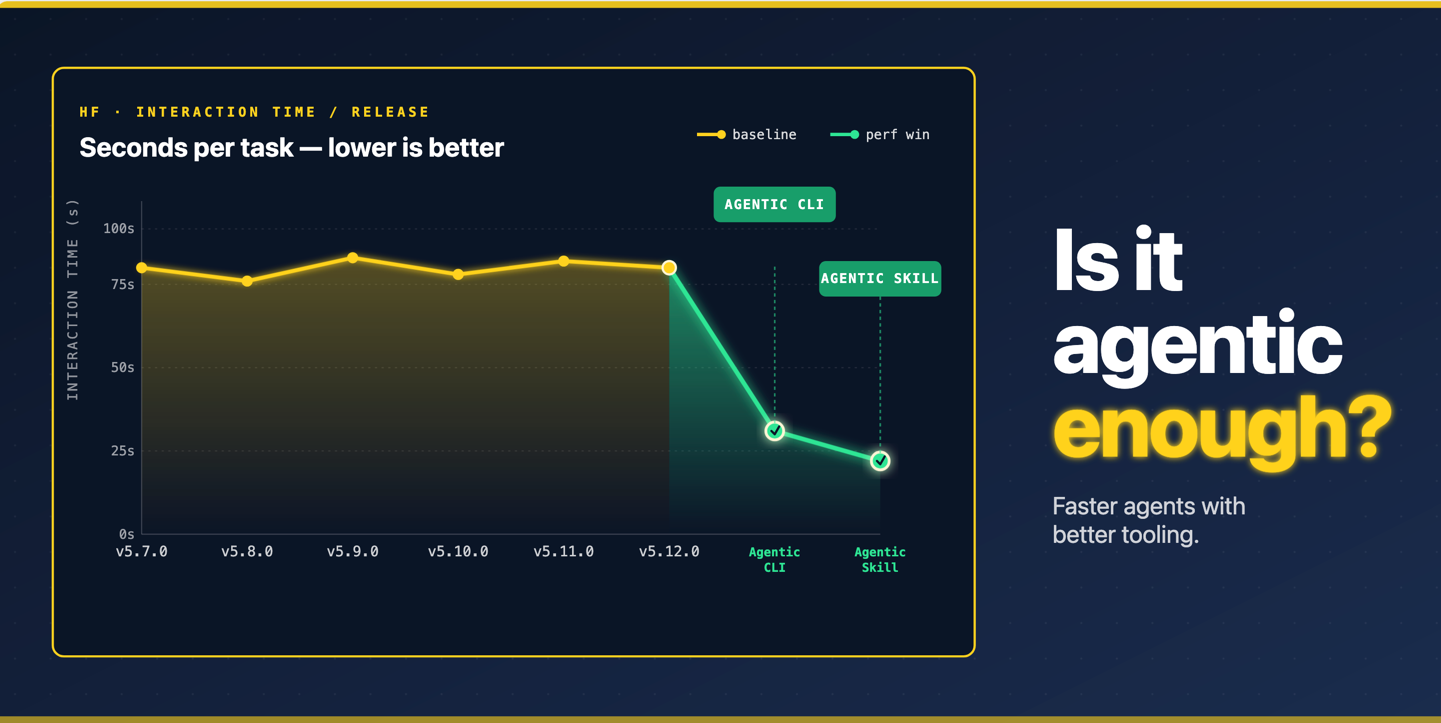
آیا مدل هوش مصنوعی شما عاملگراست؟ روش نوین ارزیابی Hugging Face
Hugging Face روش جدیدی برای ارزیابی مدلهای متنباز در کاربردهای عاملگرا معرفی کرده است؛ معیاری فراتر از پاسخ نهایی که کل فرآیند را میسنجد.
 محصولات
بازطراحی hf CLI برای عاملهای هوش مصنوعی؛ کاهش ۶ برابری مصرف منابع
بازطراحی hf CLI توسط Hugging Face برای کارایی بهتر عاملهای هوش مصنوعی؛ کاهش ۶ برابری مصرف توکن و گامها در کارهای پیچیده.
 پژوهش
هوش مصنوعی در ردهسازی امنیت قراردادهای هوشمند: معرفی EVMbench
OpenAI و Paradigm در معرفی EVMbench بنچمارکی نوین برای سنجش توانایی عوامل هوش مصنوعی در شناسایی و اصلاح آسیبپذیریهای بالای قراردادهای هوشمند ارائه میدهند.
 پژوهش
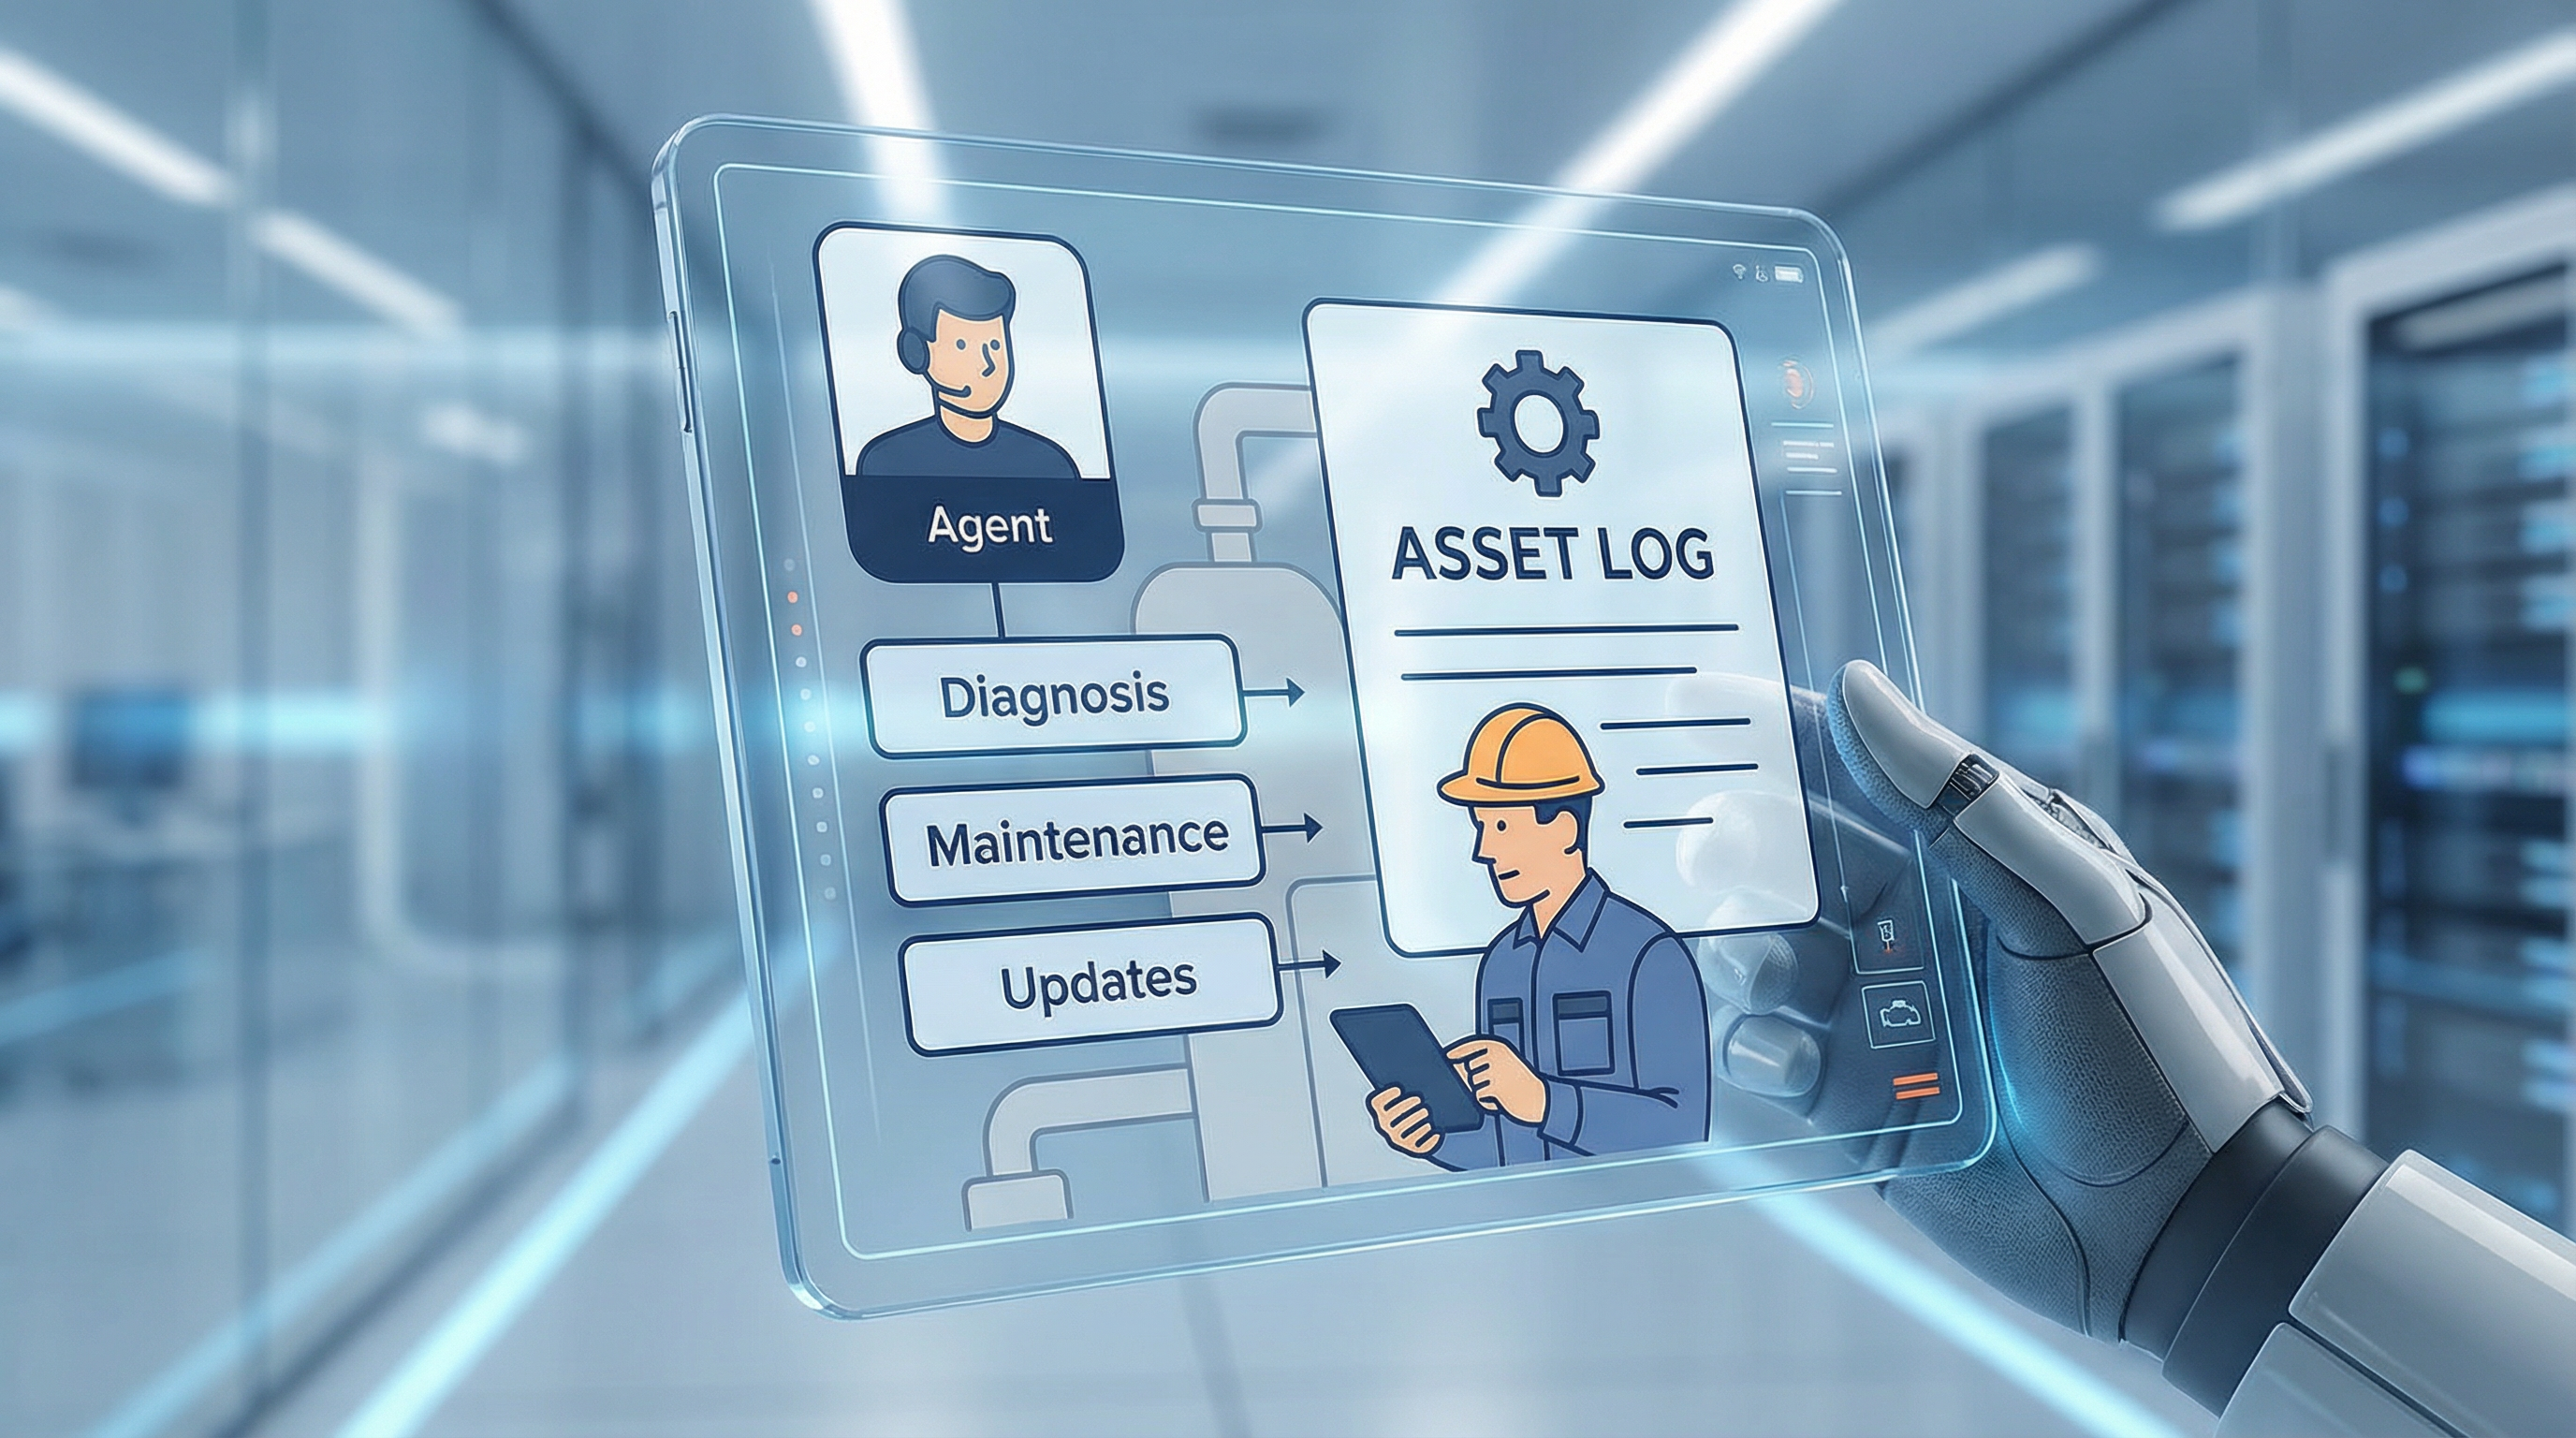
معرفی AssetOpsBench؛ پلی میان بنچمارکهای هوش مصنوعی و واقعیت صنعتی
در وبلاگ هما: معرفی AssetOpsBench؛ چارچوبی از IBM Research برای ارزیابی عاملهای هوش مصنوعی در عملیات صنعتی که شکاف آزمایشگاه و واقعیت را پر میکند.
 پژوهش
فرانتیرساینس: هوش مصنوعی در آزمون پژوهشهای پیشرفته علوم پایه
OpenAI معیار فرانتیرساینس را برای سنجش استدلال هوش مصنوعی در فیزیک، شیمی و زیستشناسی معرفی کرد تا مسیر واقعبینانه در آزمونهای علمی بسنجید.