
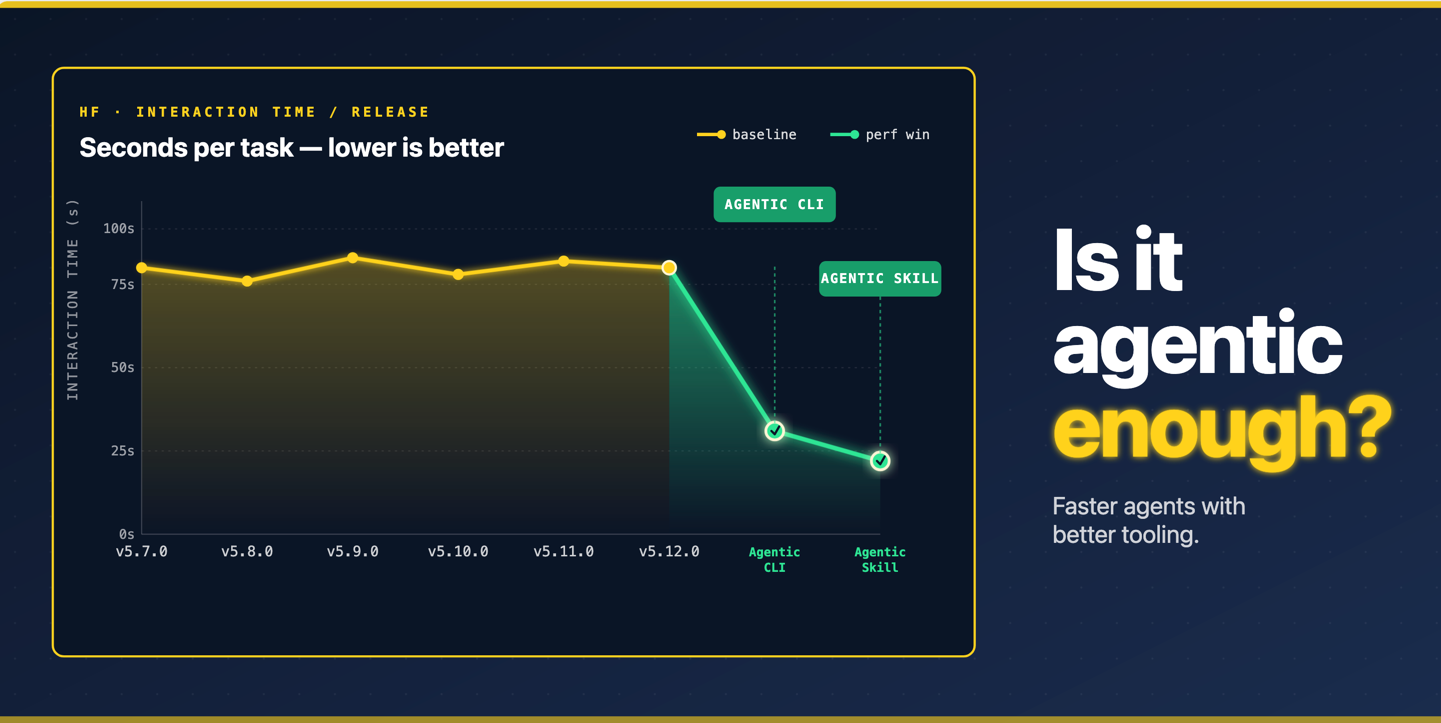
عصر تعامل با نرمافزارها در حال تغییر است. بهجای آنکه توسعهدهندگان خط به خط کد بنویسند، روزبهروز بیشتر به «عاملهای کدنویس» (Coding Agents) سپرده میشود که یک وظیفه را توصیف میکنیم و آنها کتابخانه را انتخاب میکنند، تماسها را مینویسند، اجرا میکنند و خطاهایشان را خودشان رفع میکنند. این تغییر، پرسش بنیادینی پیش روی سازندگان کتابخانهها و مدلها میگذارد: آیا نرمافزار ما به اندازه کافی «عاملگرا» (Agentic) هست؟
چرا ارزیابی فقط بر اساس پاسخ نهایی کافی نیست؟
بیشتر معیارهای فعلی تنها به پاسخ نهایی نگاه میکنند؛ اینکه آیا مدل درست جواب داده یا نه. اما در دنیای واقعی عاملها، این پاسخ نهایی فقط بخشی از ماجراست. مسیر رسیدن به جواب، تعداد مراحلی که عامل طی کرده، خطاهایی که با آن مواجه شده و هزینهای که صرف شده، همگی حیاتی هستند. یک مدل ممکن است جواب درست بدهد اما دهها بار به APIهای نادرست متصل شود و زمان و پول زیادی هدر دهد. Hugging Face در مقالهای تازه، بر همین نکته انگشت میگذارد: باید کل فرآیند «کار» را ارزیابی کرد، نه فقط محصول نهایی را.
روش Hugging Face برای ارزیابی مدلهای متنباز
تیم Hugging Face برای این ارزیابی، چارچوبی طراحی کرده که در آن مدلهای متنباز را روی «ابزار اختصاصی خودتان» میسنجند. این یعنی بهجای آزمونهای عمومی و تکراری، شما میتوانید کتابخانه یا ابزار خود را در چرخه ارزیابی قرار دهید. دو استراتژی اصلی در این روش وجود دارد:
- مدلهای بزرگ متنباز: مدل را ثابت نگه میدارند و نسخههای مختلف آن (Revision) را تغییر میدهند تا اثر تغییرات مدل بر عملکرد عاملگرا دیده شود.
- مدلهای کوچک: نسخه مدل را ثابت نگه میدارند و خود مدل را عوض میکنند تا مقایسهای منصفانه میان مدلهای کوچک مختلف به دست آید.
نکته کلیدی این است که معیار موفقیت فقط «درست انجام دادن کار» نیست؛ بلکه چگونگی برخورد با خطاها، استفاده بهینه از مستندات و ابزارها و حتی نادیده گرفتن کتابخانه در مواقع لازم نیز سنجیده میشود.
نقش «مارکر» و بهبود ابزارها
در این ارزیابی، مفهوم «مارکر» (Marker) معرفی شده است؛ نشانههایی که در طول فرآیند تعامل عامل با ابزار ثبت میشوند. این نشانهها به ما میگویند عامل در هر مرحله چه کرده، چه جستوجوهایی انجام داده و چگونه با خطاها روبهرو شده است. همچنین آزمایشهایی با «رابط خط فرمان» (CLI) و «کامیت مهارت» (Skill commit) انجام شده تا مشخص شود اگر ابزارها طوری طراحی شوند که عاملها راحتتر آنها را هدایت کنند، عملکرد بهبود مییابد یا نه.
نتیجه این است که طراحی رابط برنامهنویسی (API) و مستندات، دیگر فقط برای انسانها نیست. یک API نامرتب یا مستندات قدیمی، حالا عامل هوش مصنوعی را نیز به مسیر طولانیتر و پرهزینهتری میفرستد. بنابراین توسعهدهندگان باید به فکر طراحی «عاملمحور» نرمافزار خود باشند.
چگونه خودتان این ارزیابی را انجام دهید؟
بخش هیجانانگیز ماجرا این است که این روش در دسترس عموم قرار گرفته است. شما میتوانید ابزارها و پیکربندیهای خود را به چرخه ارزیابی اضافه کنید. مراحل کلی به این شکل است:
- ابزار یا کتابخانه خود را تعریف کنید و توضیحات لازم را به عامل بدهید.
- وظایف عاملگرای مشخصی طراحی کنید که نمایانگر کاربرد واقعی باشند.
- مدلهای متنباز دلخواه را با استراتژی ثابتنگهداشتن مدل یا نسخه، اجرا کنید.
- مارکرها را در طول فرآیند ثبت کنید و نه فقط پاسخ نهایی را.
- نتایج را مقایسه کنید تا بفهمید کدام مدل واقعاً عاملگراتر است.
این رویکرد، نگاهی تازه به توسعه نرمافزار و ارزیابی مدلهای زبانی بزرگ میاندازد و به تیمها کمک میکند تصمیمات آگاهانهتری برای انتخاب مدل و طراحی محصول بگیرند.
جمعبندی
دنیای هوش مصنوعی به سرعت به سمت عاملهای مستقل پیش میرود. معیارهای سنتی دیگر پاسخگوی نیاز ما نیستند و ارزیابیهایی مثل آنچه Hugging Face ارائه کرده، گامی مهم در جهت درک بهتر تواناییهای واقعی مدلهاست. اگر شما هم در حال توسعه ابزارهایی هستید که قرار است توسط عاملهای هوش مصنوعی هدایت شوند، بهتر است هرچه زودتر این روش را امتحان کنید.
پرسشهای پرتکرار
منظور از «عاملگرا» در ارزیابی مدلهای هوش مصنوعی چیست؟
عاملگرا به توانایی مدل در انجام مستقل یک وظیفه با استفاده از ابزارها و کتابخانهها اشاره دارد؛ یعنی مدل بتواند کد بنویسد، اجرا کند، خطاها را رفع کند و بدون دخالت انسان به نتیجه برسد.
چرا ارزیابی مدلهای عاملگرا نباید فقط بر پاسخ نهایی تمرکز کند؟
زیرا دو مدل ممکن است پاسخ نهایی یکسانی بدهند اما یکی از آنها مسیر طولانی، پرهزینه و پرخطا طی کرده باشد. ارزیابی فرآیند، معیار دقیقتری از کارایی واقعی عامل در محیط عملیاتی به دست میدهد.


