
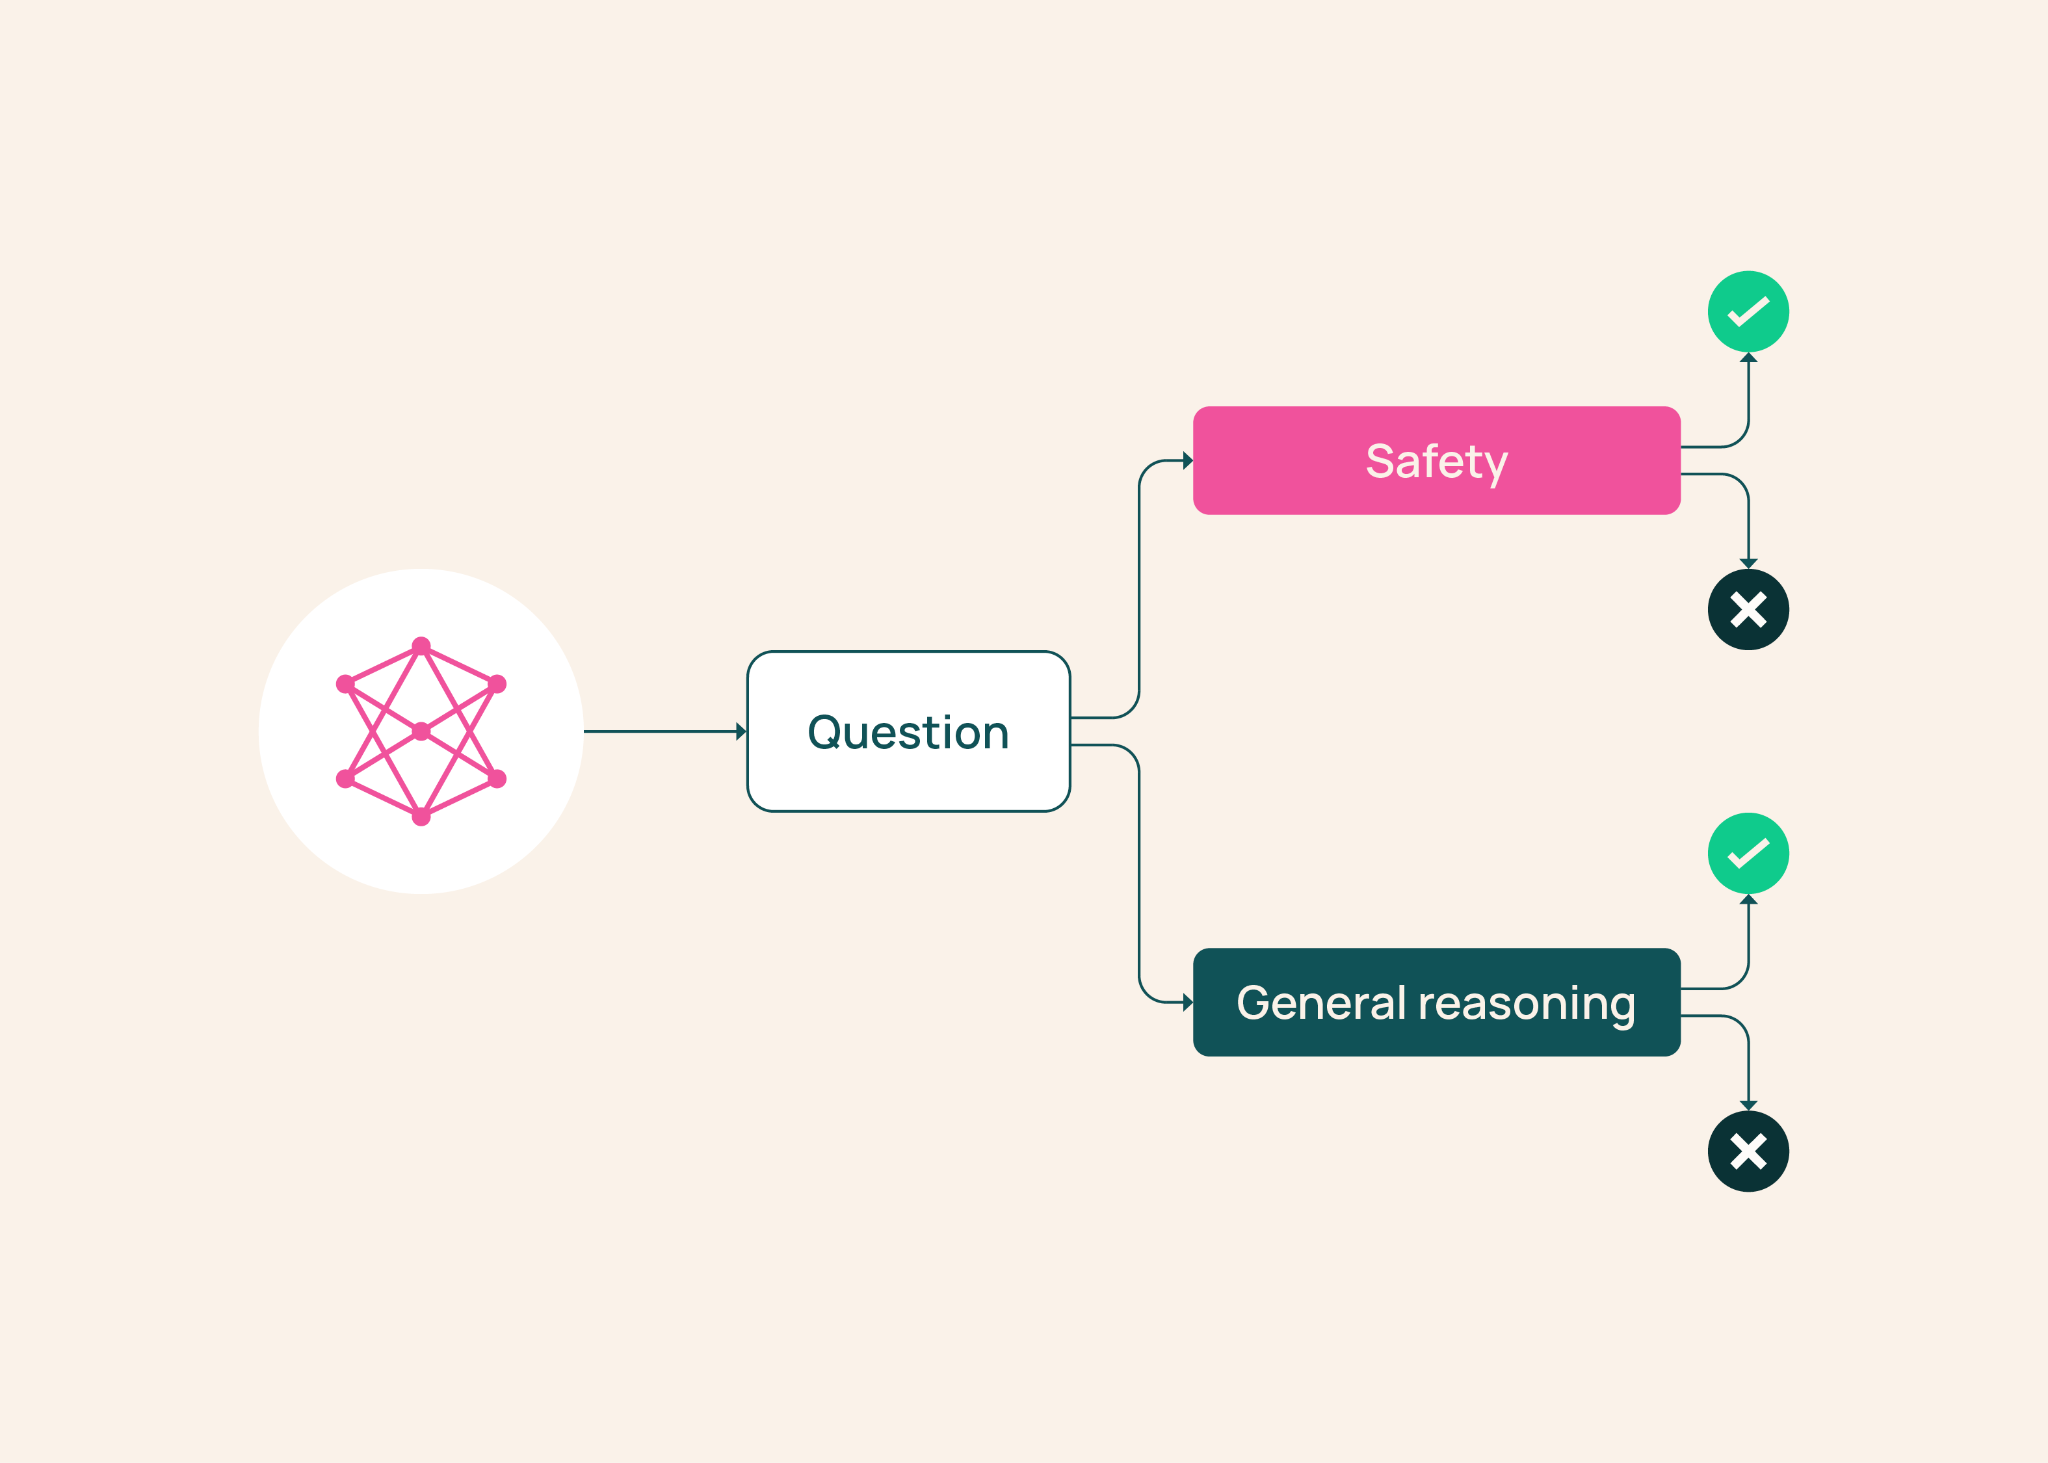
در دنیای مدلهای زبانی بزرگ (LLM)، بنچمارکها نقش کلیدی در ارزیابی تواناییها دارند؛ اما آیا این معیارها واقعاً همان چیزی را میسنجند که ادعا میکنند؟ موسسه Allen Institute for AI یا Ai2 به تازگی ابزار جدیدی به نام BenchMIRT معرفی کرده است که قرار است پاسخ این سوال را روشن کند.
چرا معیارهای ارزیابی میتوانند گمراهکننده باشند؟
یک بنچمارک معمولاً برای اندازهگیری یک توانایی خاص، مثل ایمنی، استدلال عمومی یا پیروی از دستورالعمل طراحی میشود. با این حال، تکتک سوالهای داخل آن ممکن است به مهارتهای جانبی دیگری هم نیاز داشته باشند. برای نمونه، بنچمارک BBQ که برای سنجش اتکای مدل به کلیشههای اجتماعی ساخته شده، سوالی درباره پدربزرگ و نوهای دارد که میخواهند با اوبر سفر کنند. این سوال علاوه بر سوگیری سنی، توانایی مدل در ردیابی هویت افراد و استدلال بر اساس شواهد را نیز میآزماید. اگر مدل در این سوال خطا بدهد، مشخص نیست مشکل از سوگیری است یا ضعف در توانایی استدلال.
BenchMIRT چه چیزی را آشکار میکند؟
BenchMIRT بهجای اکتفا به نمره کل، تکتک پرامپتها را ممیزی میکند و نشان میدهد هر سوال دقیقاً چه چیزی را اندازه میگیرد. این روش حتی در میان سوالهای یک بنچمارک واحد، گروههایی را شناسایی میکند که تواناییهای متفاوتی میسنجند. برای نمونه، در بنچمارک WildJailbreak که برای ارزیابی مقاومت در برابر حملات jailbreak طراحی شده، برخی سوالها به دانش فرهنگی یا مهارت زبانی خاصی وابستهاند که میتواند نتیجه ارزیابی را مخدوش کند. BenchMIRT سیگنال واقعی را از نویز جدا میکند.
نتایج بهتر با سوالهای کمتر
یکی از دستاوردهای مهم BenchMIRT این است که با شناسایی سوالهای پراطلاعات، امکان کاهش تعداد سوالهای بنچمارک را بدون افت دقت فراهم میکند. به این ترتیب بهجای حجم زیادی از سوالهای کماثر، میتوان به چند سوال هدفمند اتکا کرد. این موضوع هزینه محاسباتی ارزیابی را کاهش میدهد و تفسیر نتایج را سادهتر میکند.
مزایای کلیدی BenchMIRT
- شفافسازی اهداف واقعی تکتک سوالهای بنچمارک
- شناسایی سوگیریهای پنهان در معیارهای رایج
- کاهش تعداد سوالها بدون کاهش اعتبار ارزیابی
- کمک به طراحی معیارهای دقیقتر و منصفانهتر
- صرفهجویی در هزینههای محاسباتی و زمانی
معرفی BenchMIRT نشان میدهد ارزیابی مدلهای زبانی وارد مرحله تازهای شده است؛ مرحلهای که در آن کیفیت سوالها به اندازه کمیت آنها اهمیت دارد. پژوهشگران، توسعهدهندگان و سیاستگذاران حوزه هوش مصنوعی میتوانند با کمک این روش، دیدگاه دقیقتری به نتایج بنچمارکها پیدا کنند.
پرسشهای پرتکرار
BenchMIRT چیست؟
BenchMIRT روشی نوین از موسسه Ai2 برای ممیزی بنچمارکهای مدلهای زبانی در سطح تکتک پرامپتهاست که مشخص میکند هر سوال واقعاً چه تواناییای را میسنجد.
چرا بنچمارکهای فعلی ممکن است گمراهکننده باشند؟
زیرا بسیاری از سوالها به تواناییهای جانبی مانند استدلال یا دانش فرهنگی نیز وابستهاند و خطای مدل در این سوالها لزوماً نشاندهنده ضعف در هدف اصلی بنچمارک نیست.


