
 محصولات
OpenAI ویژگیهای سازمانی جدیدی برای API هوش مصنوعی معرفی کرد
OpenAI از ویژگیهای سازمانی جدید برای مشتریان API رونمایی کرد؛ از افزایش امنیت و کنترل تا بهروزرسانی Assistants API و ابزارهای مدیریت هزینه و بهینهسازی مصرف.
 پژوهش
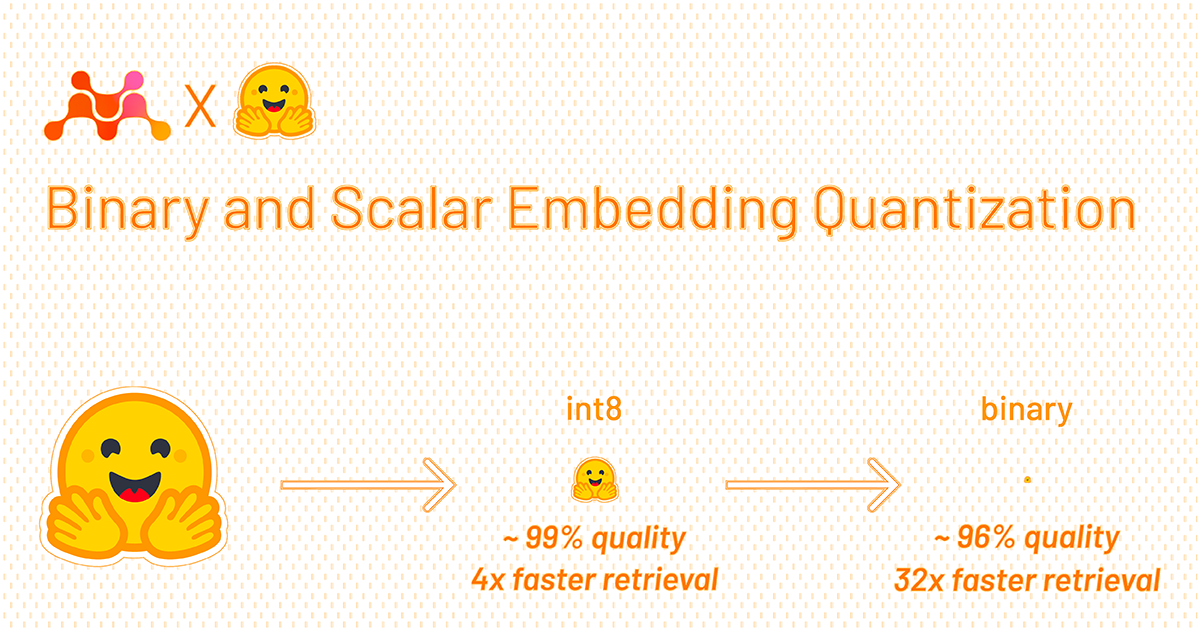
کمتر شدن هزینه و افزایش سرعت بازیابی دادهها با کوانتیزهسازی هوش مصنوعی
Hugging Face روشهای کوانتیزهسازی باینری و اسکالر را برای کاهش بهمراتب مصرف حافظه و افزایش سرعت بازیابی مدلهای ادغام در ۴۱ میلیون سند ویکیپدیا معرفی کرد. این فناوری دموکراتیزاسیون هوش مصنوعی را تسهیل میکند.
 پژوهش
GaLore: آموزش مدلهای زبانی بزرگ روی سختافزار مصرفی با هوش مصنوعی
تکنیک نوین GaLore با کاهش شدید مصرف حافظه در حالتهای بهینهساز، امکان آموزش مدلهای زبانی چند miljard پارامتری را روی کارتهای گرافیک معمولی و ارزانیتر برای پژوهشگران فراهم میکند.
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 مدلها
PEFT روشهای جدیدی برای ادغام مدلهای هوش مصنوعی معرفی کرد
کتابخانه PEFT هگز فیس با افزودن روشهای جدید ادغام LoRA مانند TIES و DARE، مسیر بهینهسازی مدلهای زبانی بزرگ را هموارتر کرد. با این تکنیکها، مدلهای قدرتمندتری با مصرف حافظه کمتر بسازید.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 مدلها
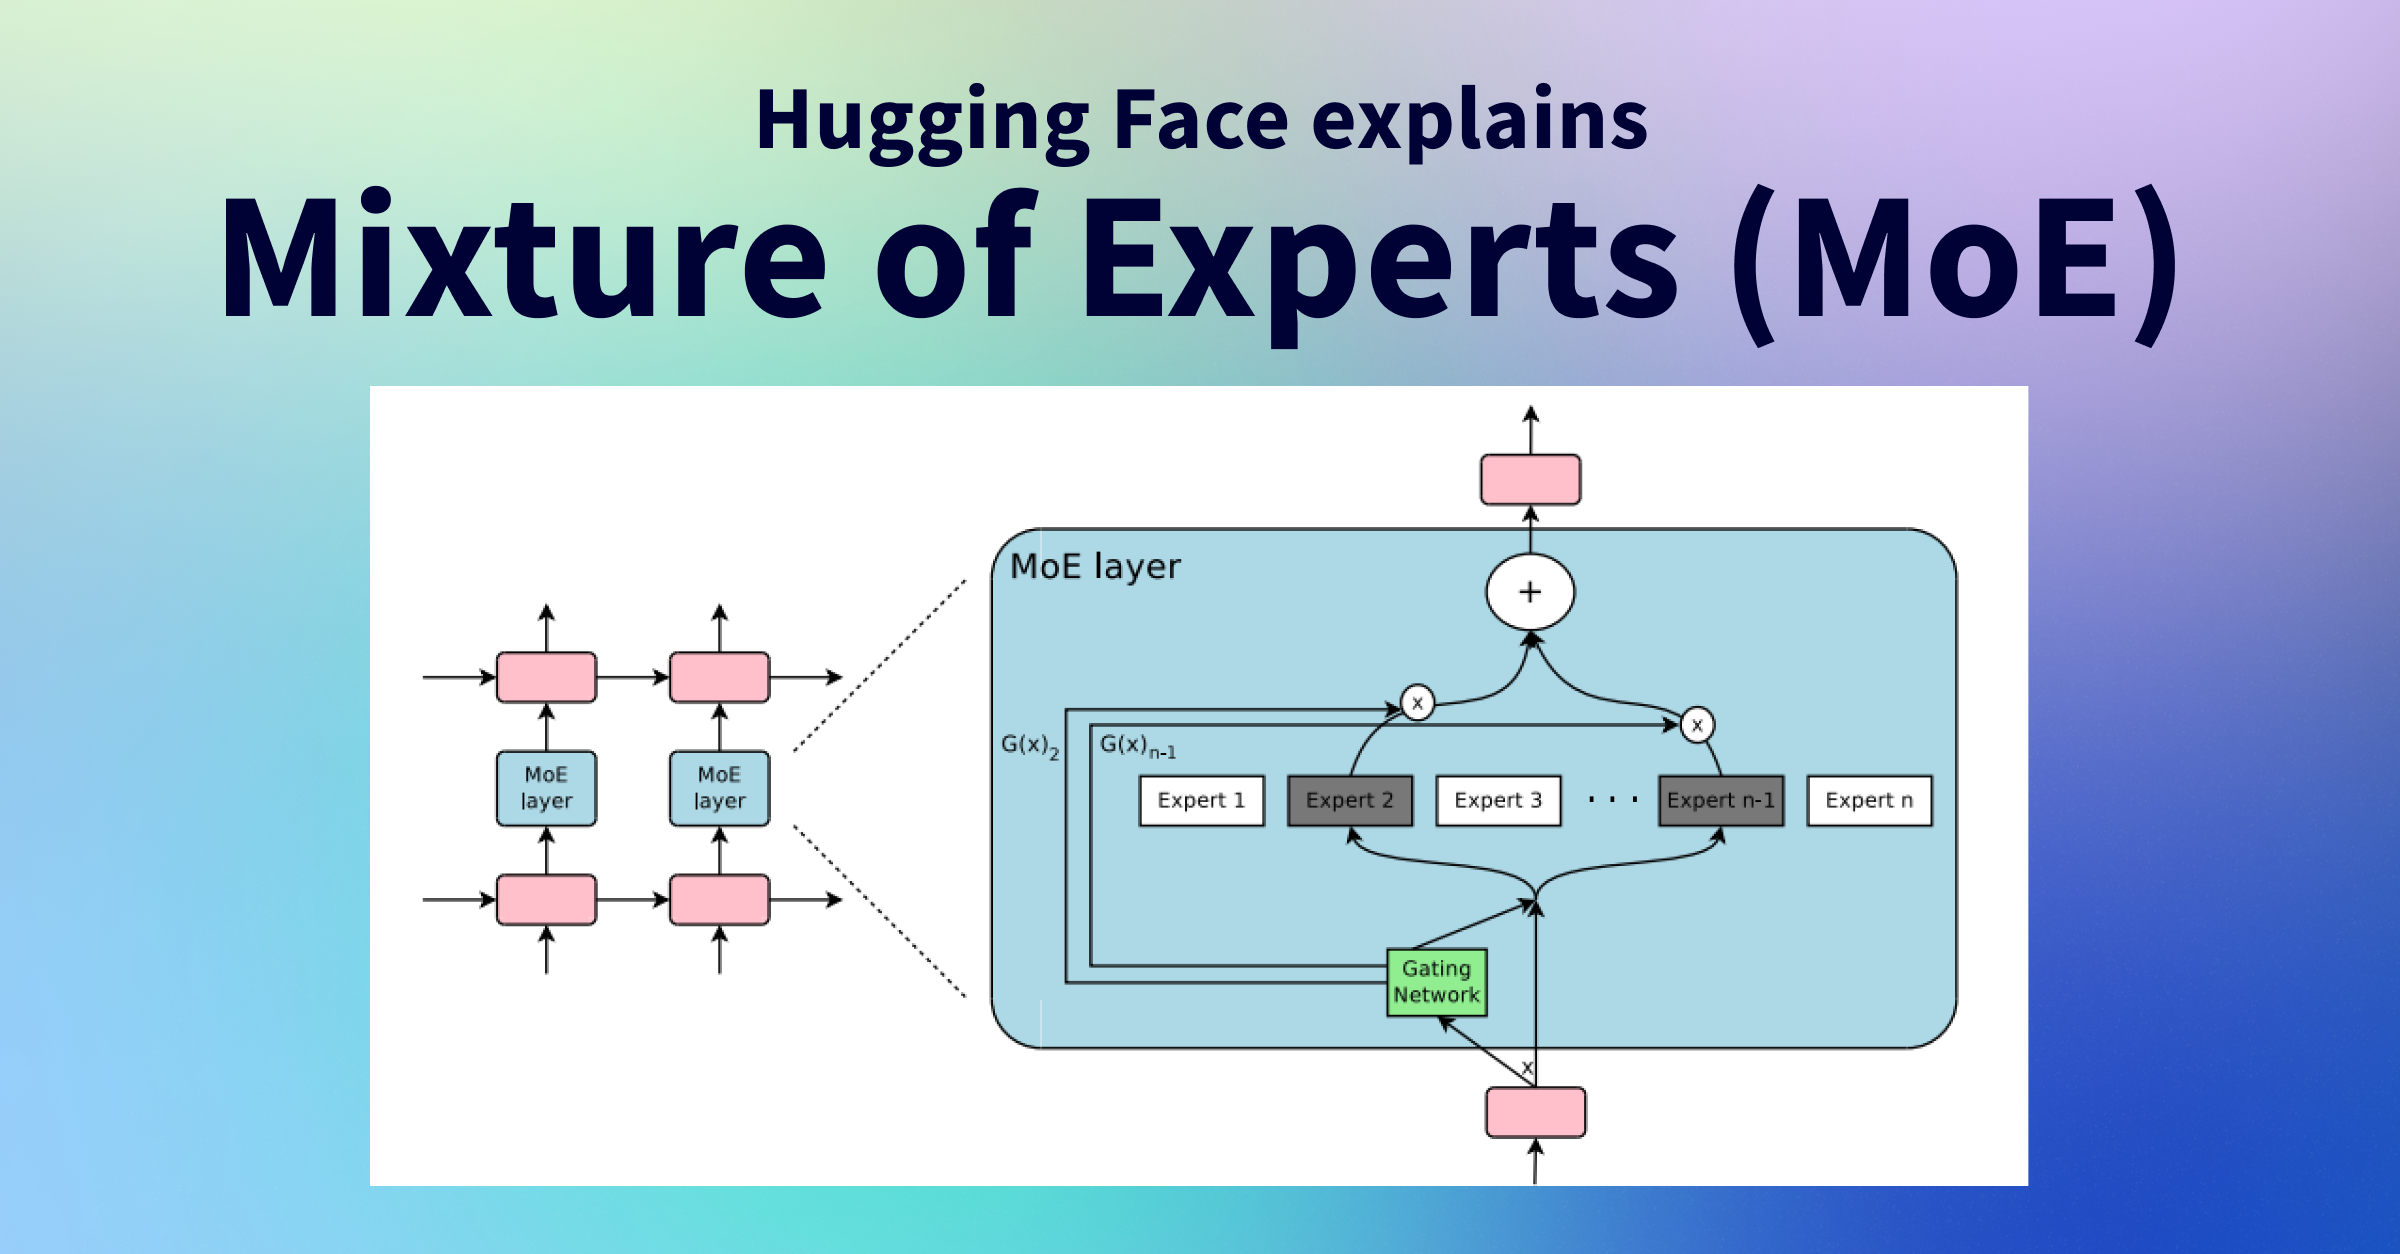
هوش مصنوعی و Mixture of Experts: چگونگی تغییر پردازش زبان
Mixture of Experts (MoE) به عنوانفرایندهای ترکیبی پیشرفته، با کاهش مصرف حافظه و افزایش سرعت، آیندهٔ مدلهای زبانی را شکل میدهد. مقایسه با مدلهای چگال، چالشها، نواحی استفاده و راهکارهای بهینهسازی را بررسی میکنیم.
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 مدلها
هوش مصنوعی: آداپتورهای T2I‑Adapters برای کنترل تصاویر SDXL
آداپتورهای T2I‑Adapters برای SDXL؛ مدل کنترل متن‑به‑تصویر باز و کارآمد، جایگزین پر مصرف ControlNet در تولید تصاویر پیشرفته.