
 پژوهش
ارزیابی مدلهای زبانی بزرگ آموزشدیده روی کد؛ رویکرد نوین OpenAI
در این مقاله به بررسی روشهای ارزیابی مدلهای زبانی بزرگ متخصص در کدنویسی میپردازیم و معیار HumanEval و اهمیت آن را برای سنجش هوش مصنوعی کدنویس تحلیل میکنیم.
 اخبار
دستاوردهای برنامه OpenAI Scholars 2021 برای پژوهشگران هوش مصنوعی
دوره ۲۰۲۱ برنامه OpenAI Scholars با تولید پروژههای متنباز پژوهشی به پایان رسید؛ در این مطلب نتایج و اهمیت آن برای توسعه هوش مصنوعی را بررسی میکنیم.
 محصولات
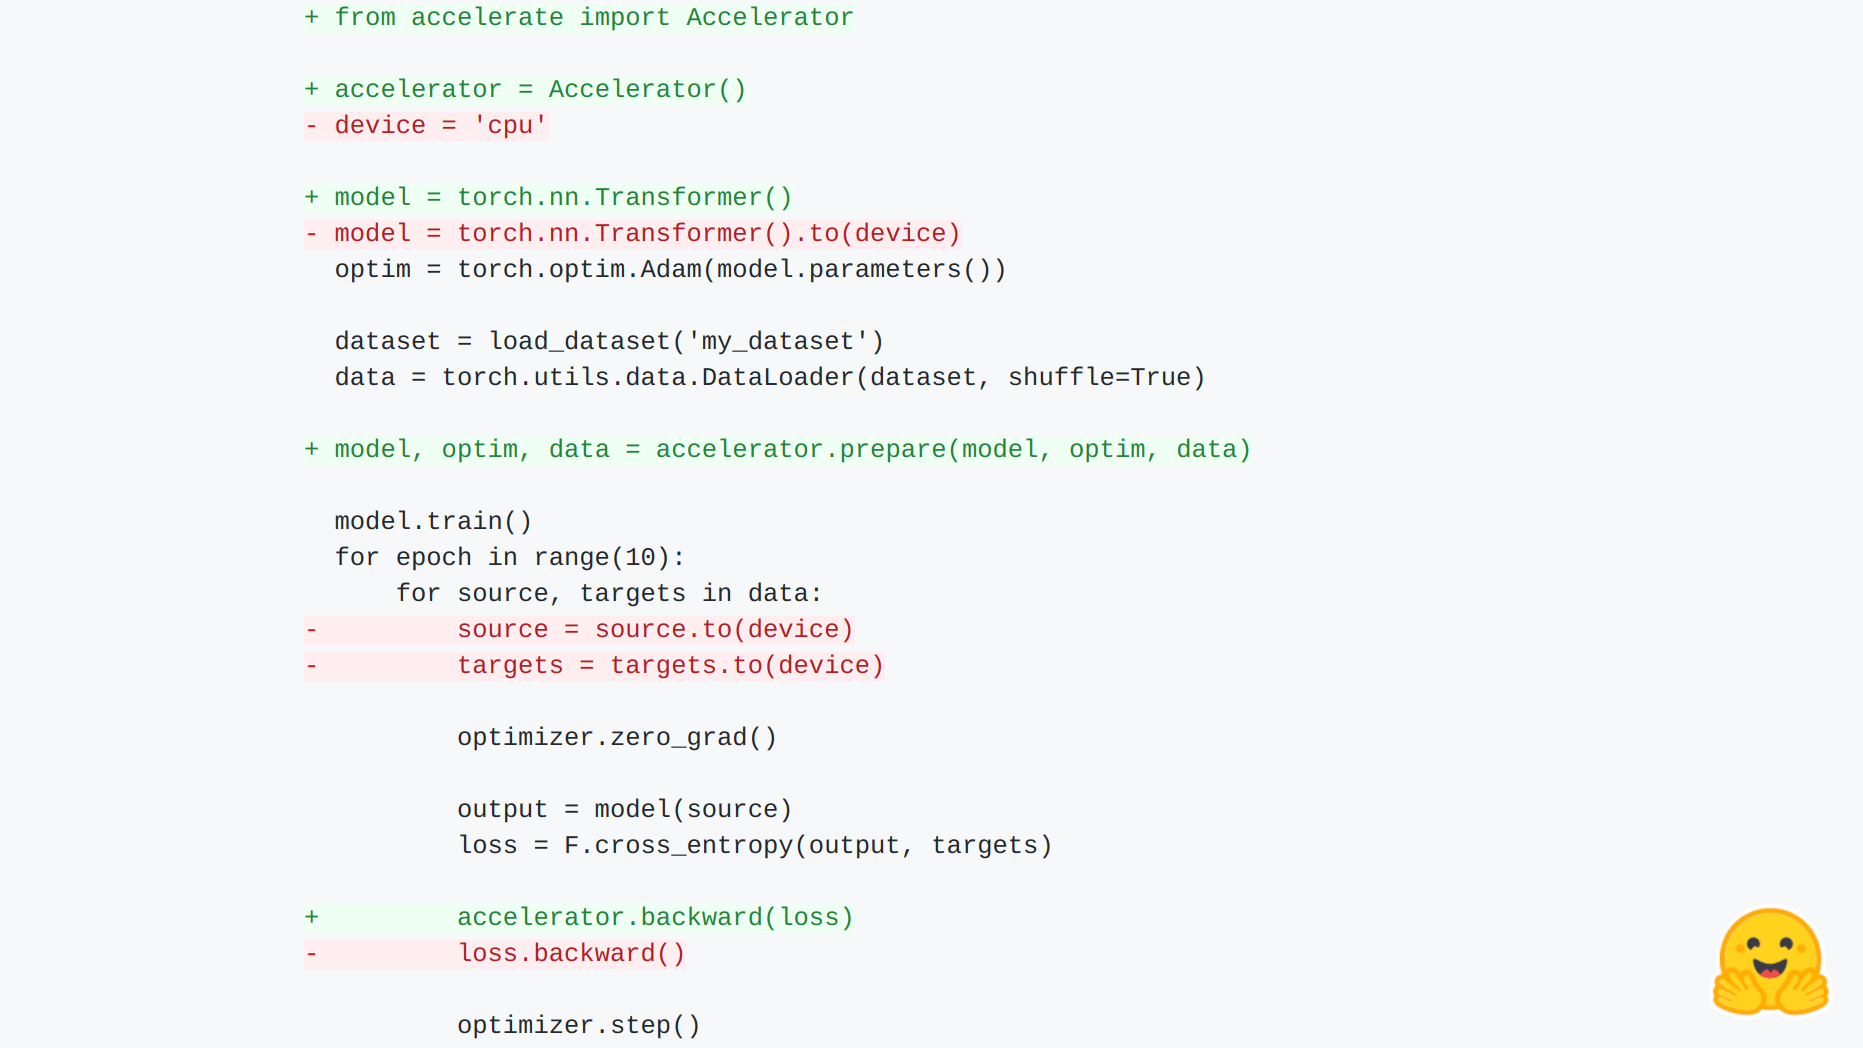
هوش مصنوعی با Accelerate: آموزش مدلهای PyTorch بدون پیچیدگی
کتابخانه Accelerate از Hugging Face به توسعهدهندگان امکان میدهد اسکریپتهای خام PyTorch را روی هر دستگاهی با پشتیبانی از آموزش توزیعشده و دقت ترکیبی اجرا کنند.
 آموزش
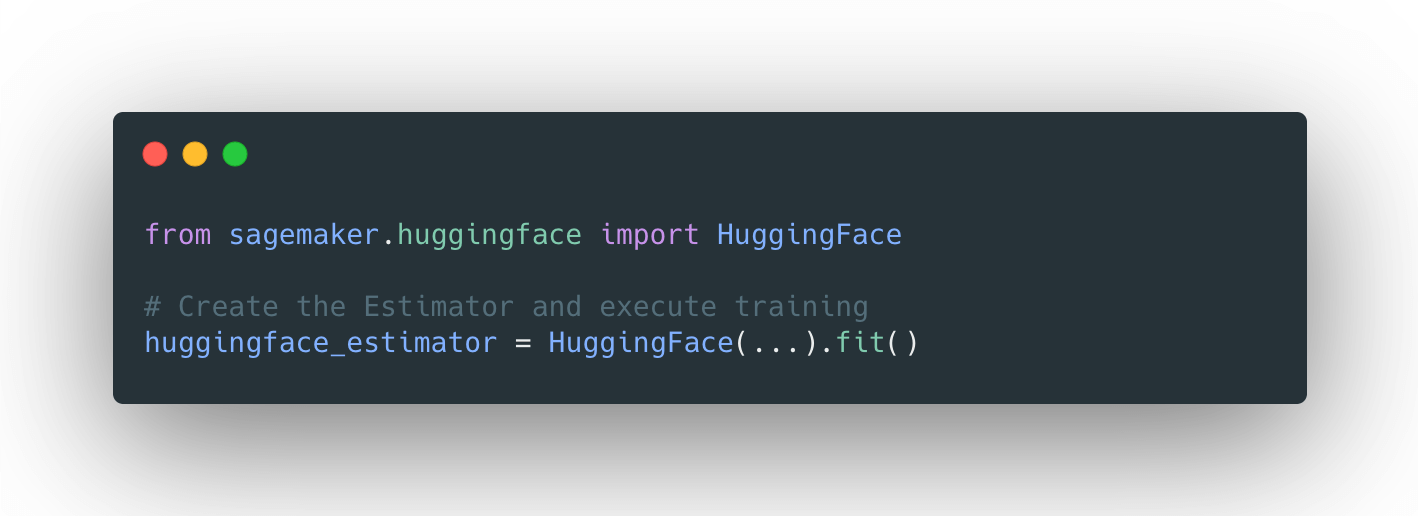
آموزش توزیعشده مدلهای هوش مصنوعی BART و T5 برای خلاصهسازی با SageMaker
در این مقاله با آموزش توزیعشده مدلهای BART و T5 برای خلاصهسازی متن با استفاده از SageMaker آشنا میشوید. مراحل راهاندازی کاملاً گفته شده است.
 اخبار
همکاری استراتژیک آمازون و هافینگ فیس برای سادهسازی هوش مصنوعی
همکاری جدید آمازون و هافینگ فیس، آموزش و استقرار مدلهای پیشرفته هوش مصنوعی را با ساگمیکر سادهتر میکند. مزایای این مشارکت و امکانات آن را بخوانید.
 آموزش
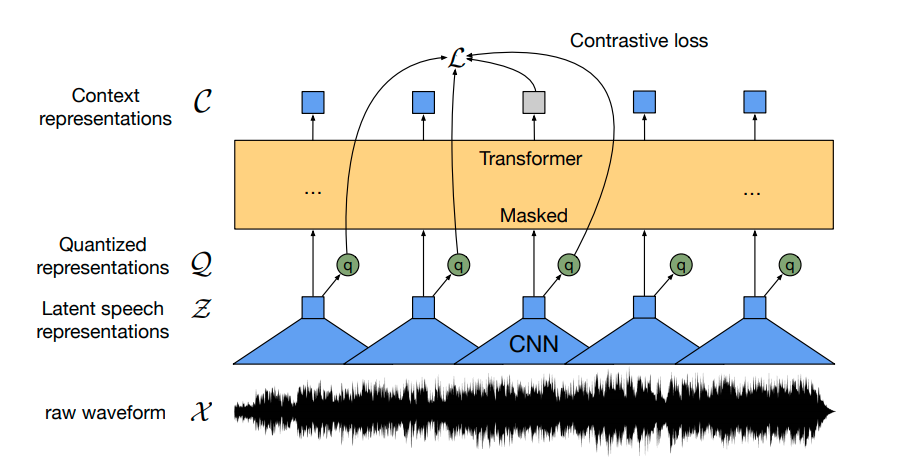
آموزش دقیق Wav2Vec2 برای تشخیص گفتار انگلیسی با هوش مصنوعی
در این مقاله از بلاگ هوش مصنوعی هما، نحوه تنظیم دقیق مدل Wav2Vec2 برای تشخیص خودکار گفتار انگلیسی با کتابخانه Transformers آموزش داده میشود.
 آموزش
هوش مصنوعی و شبکههای عصبی: راهنمای ساده برای سازندگان پیچیده
با وجود پیشرفت ابزارهای یادگیری عمیق، ساخت شبکههای عصبی نیازمند توجه به نکات ساده اما حیاتی است. این مقاله از تجربه هافینگ فیس میگوید.
 اخبار
آموزش سریعتر و ارزانتر مدلهای هوش مصنوعی با PyTorch و TPU
با جدیدترین یکپارچهسازی PyTorch/XLA و Hugging Face، مدلهای هوش مصنوعی را بدون تغییر در رابط Trainer روی Cloud TPU سریعتر و ارزانتر آموزش دهید.
 اخبار
مقیاسپذیری Kubernetes به ۷۵۰۰ گره؛ زیرساخت هوش مصنوعی OpenAI
اوپنایآی با مقیاسبندی کوبرنیتز به ۷۵۰۰ گره، زیرساختی قدرتمند برای آموزش مدلهای بزرگ هوش مصنوعی مانند GPT-3 و DALL·E فراهم کرده است.
 آموزش
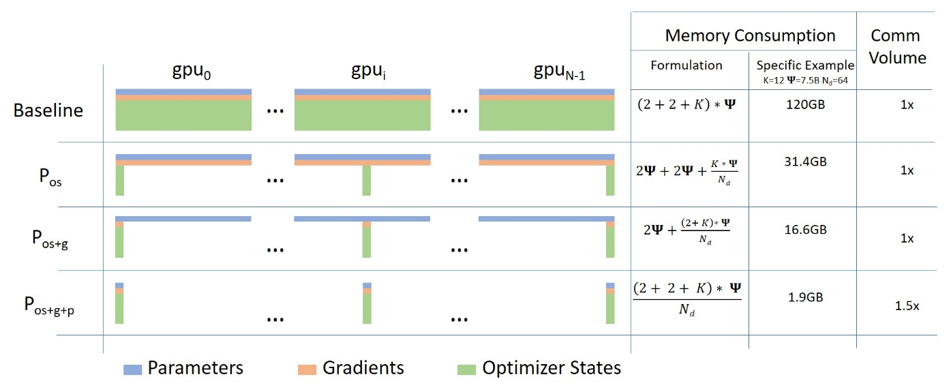
هوش مصنوعی و بهینهسازی حافظه: معرفی ZeRO با DeepSpeed و FairScale
با رشد مدلهای بزرگ، حافظه GPU پاسخگو نیست. ZeRO در DeepSpeed و FairScale راهکاری برای آموزش سریعتر و بهینهسازی مصرف حافظه است.