
 اخبار
هوش مصنوعی: انتشار Stable Diffusion 3 در Hugging Face با امکانات جدید
نویسنده مرجع بررسی کرد که نسخه جدید Stable Diffusion 3 با تکنیکهای جدید دمج، حافظه بهینه و مدلسازی چندنویسهای در وبسایت Hugging Face معرفی شد.
 اخبار
پشتیبانی سریعتر Assisted Generation بر روی Intel Gaudi در هوش مصنوعی
شرکت Intel و هابانا پردازنده Gaudi را برای سرعتپردازی Assisted Generation طراحی کرده و هزینه و مصرف انرژی را بهطور چشمگیری کاهش میدهد.
 مدلها
هوش مصنوعی: کشف حافظه کوانتیزه برای تولید متن طولانی در مدلهای بزرگ
کاهش مصرف حافظه در تولید متن طولانی با کوانتیزه کردن KV Cache، راهحلی قابل تنظیم برای مدلهای بزرگ – معیارهای عملکرد و کیفیت بدون کاهش قابل توجهی در خروجی.
 پژوهش
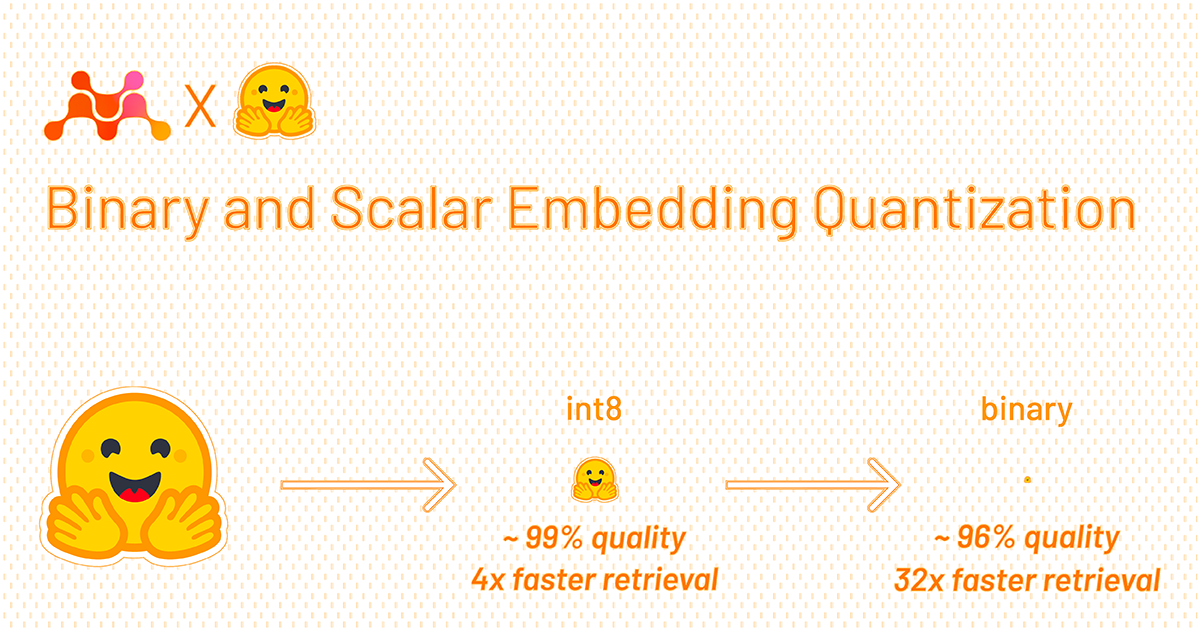
کمتر شدن هزینه و افزایش سرعت بازیابی دادهها با کوانتیزهسازی هوش مصنوعی
Hugging Face روشهای کوانتیزهسازی باینری و اسکالر را برای کاهش بهمراتب مصرف حافظه و افزایش سرعت بازیابی مدلهای ادغام در ۴۱ میلیون سند ویکیپدیا معرفی کرد. این فناوری دموکراتیزاسیون هوش مصنوعی را تسهیل میکند.
 پژوهش
GaLore: آموزش مدلهای زبانی بزرگ روی سختافزار مصرفی با هوش مصنوعی
تکنیک نوین GaLore با کاهش شدید مصرف حافظه در حالتهای بهینهساز، امکان آموزش مدلهای زبانی چند miljard پارامتری را روی کارتهای گرافیک معمولی و ارزانیتر برای پژوهشگران فراهم میکند.
 مدلها
کوانتو؛ بکاند کوانتیزهسازی پایتورچ برای استقرار مدلهای هوش مصنوعی
کوانتو یک بکاند کوانتیزهسازی برای پایتورچ است که توسط Hugging Face برای کاهش مصرف حافظه و افزایش سرعت پردازش مدلهای هوش مصنوعی معرفی شده است.
 مدلها
مدلهای جاسازی ماتریوشکا؛ تحولی در هوش مصنوعی با انعطافپذیری ابعاد
مدلهای جاسازی ماتریوشکا به شما امکان میدهند بردارهای با ابعاد مختلف را از یک مدل واحد استخراج کنید؛ بدون افت چشمگیر کیفیت، حافظه و هزینه محاسباتی کمتر.
 مدلها
PEFT روشهای جدیدی برای ادغام مدلهای هوش مصنوعی معرفی کرد
کتابخانه PEFT هگز فیس با افزودن روشهای جدید ادغام LoRA مانند TIES و DARE، مسیر بهینهسازی مدلهای زبانی بزرگ را هموارتر کرد. با این تکنیکها، مدلهای قدرتمندتری با مصرف حافظه کمتر بسازید.
 اخبار
آزمون حافظه جدید ChatGPT؛ کنترل هوش مصنوعی در دستان شما
OpenAI در حال آزمایش قابلیت حافظهی ChatGPT است؛ این ویژگی به هوش مصنوعی اجازه میدهد اطلاعات مکالمات گذشته را به خاطر بسپارد و کاربران کنترل کاملی بر حافظه دارند.
 پژوهش
هوش مصنوعی در پیشرفت با StarCoder: کوانتیزهسازی 8/4 بیت و Speculative
کوانتیزهسازی 8/4 بیت و تکنیک Speculative Decoding در مدل کد نویسی StarCoder باعث افزایش سرعت و کاهش مصرف حافظه میشود، مستقیماً بهرهورتر شدن LLMs در محیطهای نسل جدید.