
 پژوهش
هوش مصنوعی برای تأثیر اجتماعی؛ از تشخیص بیماری تا پیشبینی بلایا
بیش از یک دهه است که هوش مصنوعی به بلوغ رسیده و حالا در تشخیص بیماری، پیشبینی بلایا، آموزش و ایجاد فرصتهای اقتصادی نقش واقعی و قابل اندازهگیری ایفا میکند.
 پژوهش
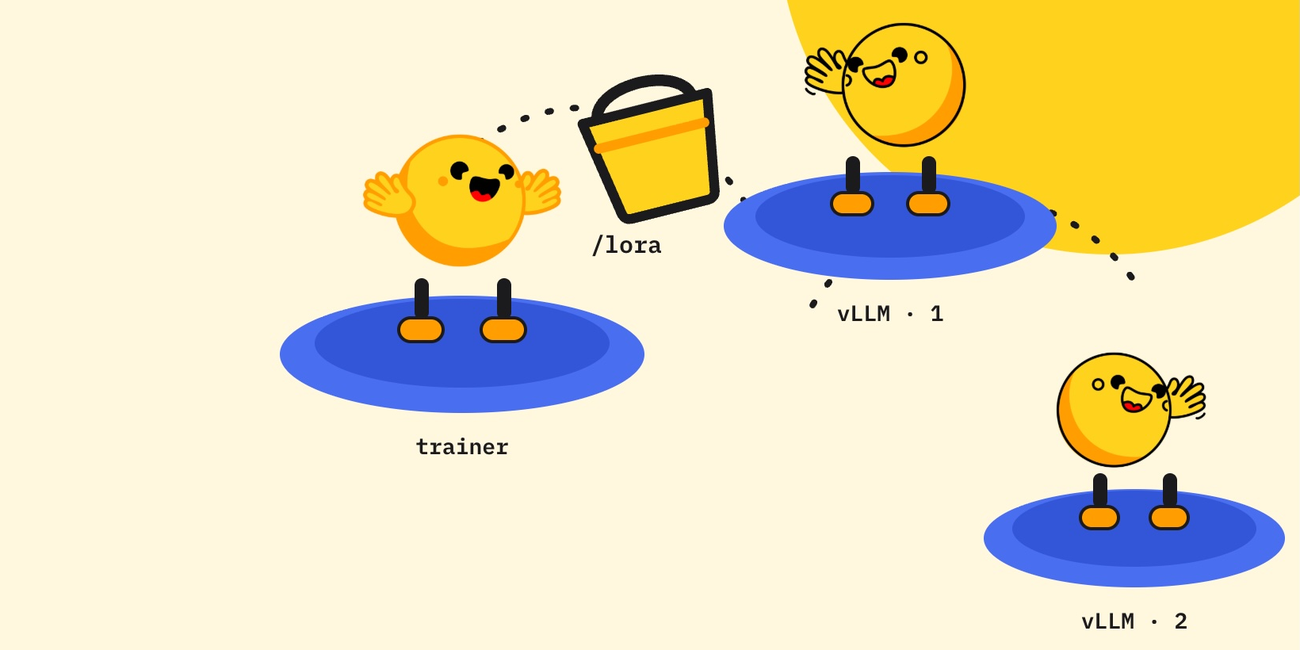
آموزش ناهمزمان GRPO با LoRA؛ گامی نو در هوش مصنوعی متنباز
TRL v1.14 با پشتیبانی LoRA در AsyncGRPOTrainer، آموزش و استنتاج را از هم جدا میکند. مقاله به بررسی معماری سهلایه و استفاده از Storage Buckets میپردازد.
 آموزش
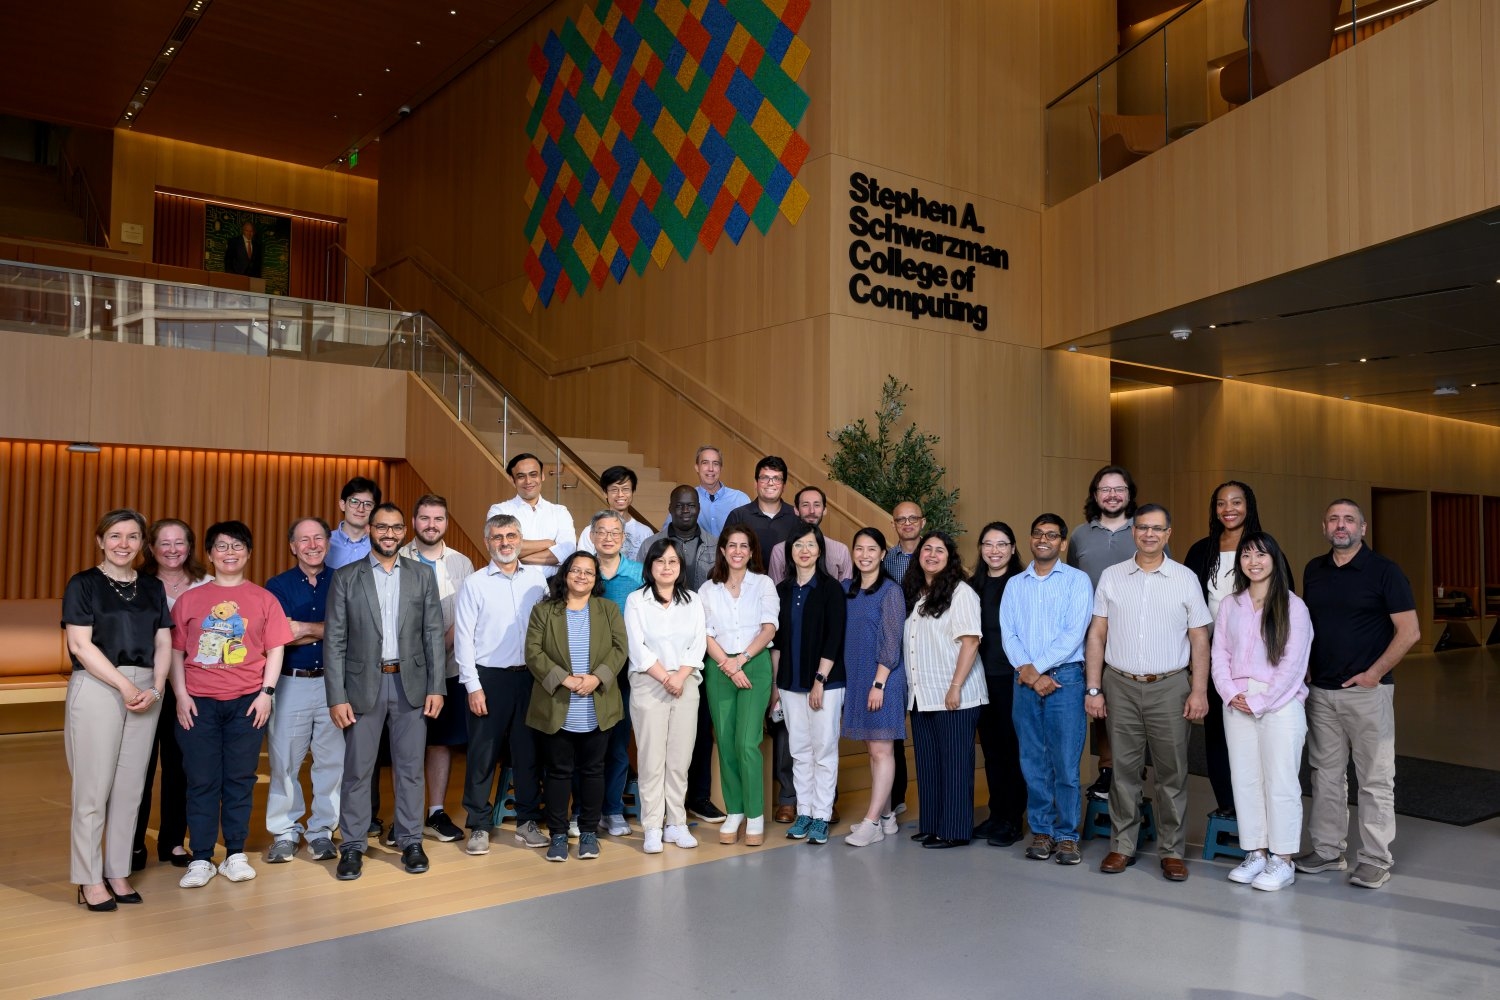
آموزش هوش مصنوعی به اساتید؛ طرح تازه MIT برای اساتید بینرشتهای
در نخستین کارگاه تابستانی MIT، اساتید دانشگاههای مختلف با روشهای نوین آموزش هوش مصنوعی در رشتههای گوناگون آشنا شدند؛ گامی برای تربیت دانشجویان منتقد.
 اخبار
حمایت OpenAI از روزنامهنگاری؛ از کلاس درس تا اتاق خبر با هوش مصنوعی
OpenAI برنامههای تازهای برای حمایت از روزنامهنگاری راهاندازی کرده است؛ از آموزش دانشجویان با هوش مصنوعی تا مشارکت با اتاقهای خبر برای تولید دقیقتر و سریعتر اخبار.
 پژوهش
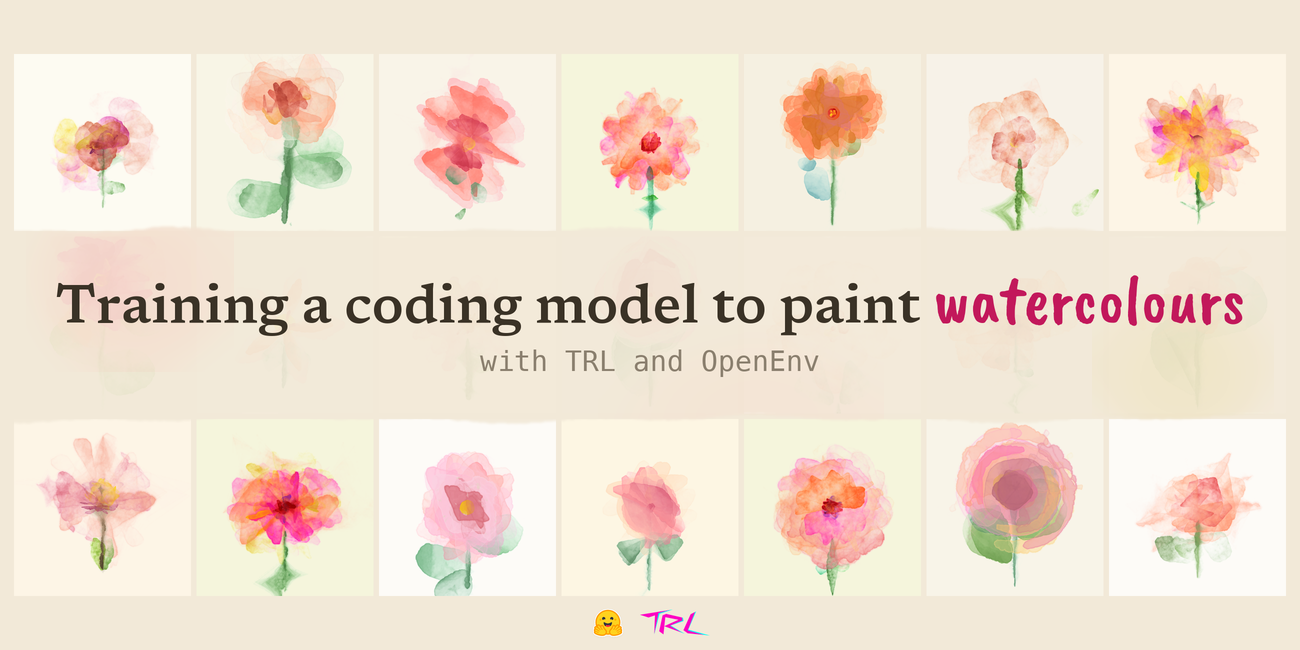
آموزش مدل هوش مصنوعی برای نقاشی آبرنگ با کد جاوااسکریپت
در این مقاله، روشی برای آموزش مدلهای زبانی به منظور خلق نقاشیهای آبرنگ با استفاده از یادگیری تقویتی و محیط باز معرفی میشود. با ما همراه باشید.
 آموزش
افزایش دقت هوش مصنوعی در خروجی ساختاریافته با GRPO و TRL
در این راهنمای متنباز، مدل LFM2.5-350M با روش GRPO و کتابخانه TRL در ۱۰۰ گام آموزش داده میشود و دقت خروجی ساختاریافته از ۲۲.۶٪ به ۲۹.۷٪ میرسد.
 اخبار
شروع شتابدهی هوش مصنوعی برای استارتاپهای تندرستی و آموزش تایلند
OpenAI و وزارت علوم تایلند از شتابدهی ۸ هفتهای برای تبدیل نمونههای اولیه هوش مصنوعی به محصولات قابل اعتماد در حوزه سلامت و آموزش خبر دادند.
 پژوهش
هوش مصنوعی و تفکر انتقادی: تحول در آموزش با ChatGPT
مطالعهای جدید بر روی ۱۰۰۰+ دانشجو، تاثیر ChatGPT و آموزش تفکر انتقادی را بر عملکرد تحصیلی، اصالت کار و تفکر وسیعتر بررسی میکند. نتایج شگفتانگیز است!
 آموزش
OpenAI گسترش چتجیپیتی برای معلمان: هوش مصنوعی در خدمت آموزش آمریکا
اوپنایآی ابزار هوش مصنوعی امن چتجیپیتی برای معلمان را در ۵۵ ناحیه آموزشی آمریکا گسترش میدهد. بیش از ۱۰۰ هزار معلم و کادر آموزشی از آموزش و پشتیبانی بهرهمند میشوند.
 پژوهش
آموزش و تنظیم دقیق مدلهای جاسازی چند برداری با تبدیلکنندههای جمله
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.