
 پژوهش
سرعت بالای پیشبینی با مدل BLOOMZ بر روی شتابگر Habana Gaudi2 – انقلاب AI
با بهرهگیری از شتابگر Habana Gaudi2 و Optimum Habana، مدل BLOOMZ با بالاترین سرعت ممکن در زمینه پیشبینی زبانهای چندگانه عمل میکند؛ راهنمای عملی و بازرسی برپایه توضیحات!
 کسبوکار
Witty Works با کمک هوش مصنوعی از Hugging Face رشد چشمگیری داشت
Witty Works با هوش مصنوعی و Acceleration Program از Hugging Face یک ابزار نوشتن کمککننده ایجاد کرد که سرعت انعطافپذیری و پوشش چند زبان را بهطور قابلتوجه بالا میآورد. در مقاله به مزایای این تاسیس پرداختم.
 کسبوکار
هوش مصنوعی در Hugging Face: چرا به Inference Endpoints مهاجرت کردیم
در این مقاله به دلایل مهاجرت Hugging Face به سرویس Inference Endpoints میپردازیم؛ مزایای کاهش تاخیر، ثبات بالا و هزینه پایین، و راهکارهای جایگزین را بررسی میکنیم.
 سختافزار
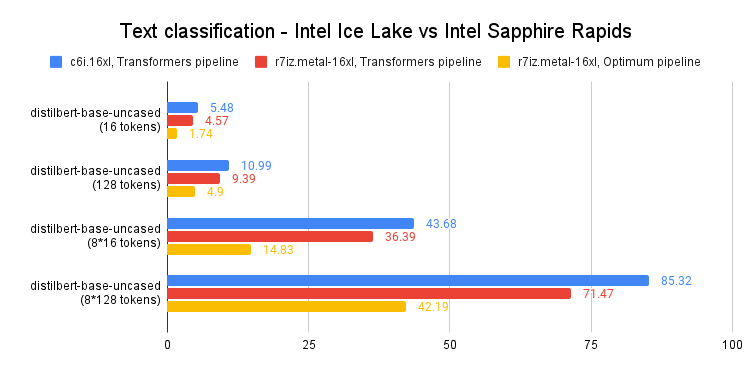
سرعت inference PyTorch با پردازندهٔ Intel Sapphire Rapids برتر
در این مقاله، سرعت inference مدلهای NLP بر پایه PyTorch را در سرورهای Intel Sapphire Rapids و Ice Lake میسنجیم و نکات عملی برای بهرهبرداری را بررسی میکنیم.
 پژوهش
سرعت آموزش مدلهای هوش مصنوعی ۳۵% سریعتر با Optimum+ONNX Runtime
حکیمیترین مدلهای هوش مصنوعی با تمهیدات Optimum و ONNX Runtime، در مدت زمان کمتر از قبل به دقت و سرعت بیشتری آموزش مییابند. ایدههای جدید در این حوزه در آینده نزدیک چالشهای بزرگی را حل میکنند.
 سختافزار
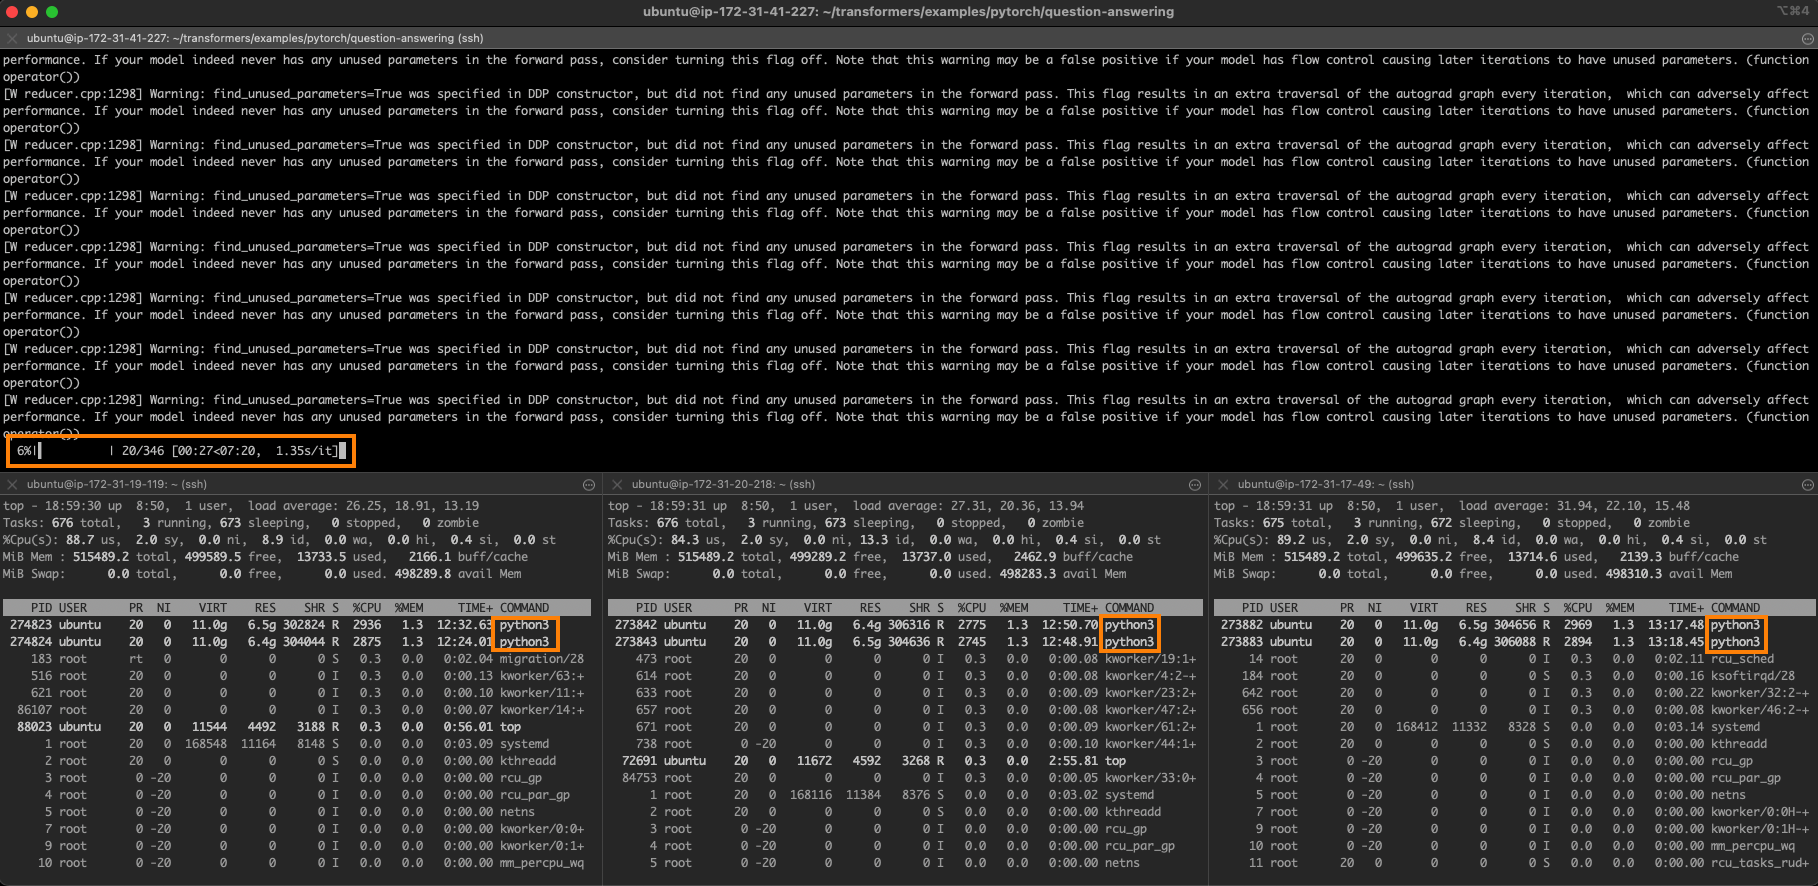
هوش مصنوعی در سرورهای Intel Sapphire Rapids: 2 برابری سرعت یادگیری ماشین
سرورهای جدید Intel Sapphire Rapids با دستورات ویژهی متریس پیشرفته، یادگیری عمیق در PyTorch را دو برابری سرعت میکنند. در این مقاله، به تفصیل بهینهسازیهای IPEX و CCL پرداخته میشود.
 پژوهش
هوش مصنوعی Point‑E: ساخت ابجکتهای سهبعدی از متن بهسرعت
OpenAI با معرفی Point‑E مدل جدیدی را ارائه میکند که بر اساس متن، ابجکتهای سهبعدی پوینتکلاوید ایجاد میکند. این فناوری میتواند صنعت طراحی را متحول سازد.
 محصولات
همه چیز دربارهی شتابدهی مدلهای هوش مصنوعی با OpenVINO و 🤗 Optimum
بهدنبال بهبود سرعت مدلهای هوش مصنوعی؟ با یکپارچگی 🤗 Optimum Intel و OpenVINO، میتوانید مدلهای Transformers را در پردازندۀ Intel بهصورت سریع و کمیادگیری راهاندازی کنید.
 آموزش
تسلط بر آموزش توزیعشده در هوش مصنوعی با PyTorch DDP و Accelerate
در این مقاله مراحل آموزش توزیعشده با PyTorch DDP و ابزارهای Accelerate و Trainer بررسی میشود، بهمنظور تسهیل فراگیری توسعه مدلهای هوش مصنوعی بزرگ.
 پژوهش
هوش مصنوعی در حالتهای سرعت: بهینهسازی دقت بالا در BLOOM با Hugging Face
در این گزارش، تیمهای Open Source بهینهسازی سرور پیشبینی مدل BLOOM را انجام دادند؛ عملکرد 5 برابر سریعتر و 50 برابر قدرتمندتر بهدست آمد.