
 کسبوکار
نقش هوش مصنوعی در کاهش هزینه و افزایش تحرکات فناوری
سارا فیرار، مدیر مالی OpenAI، مکانیسم پیشرانی فناوری هوش مصنوعی را از چرخههای جدید عرضه و کاهش قیمت برای ارائهی مقیاسپذیرتر و موثرتر توضیح داد.
 مدلها
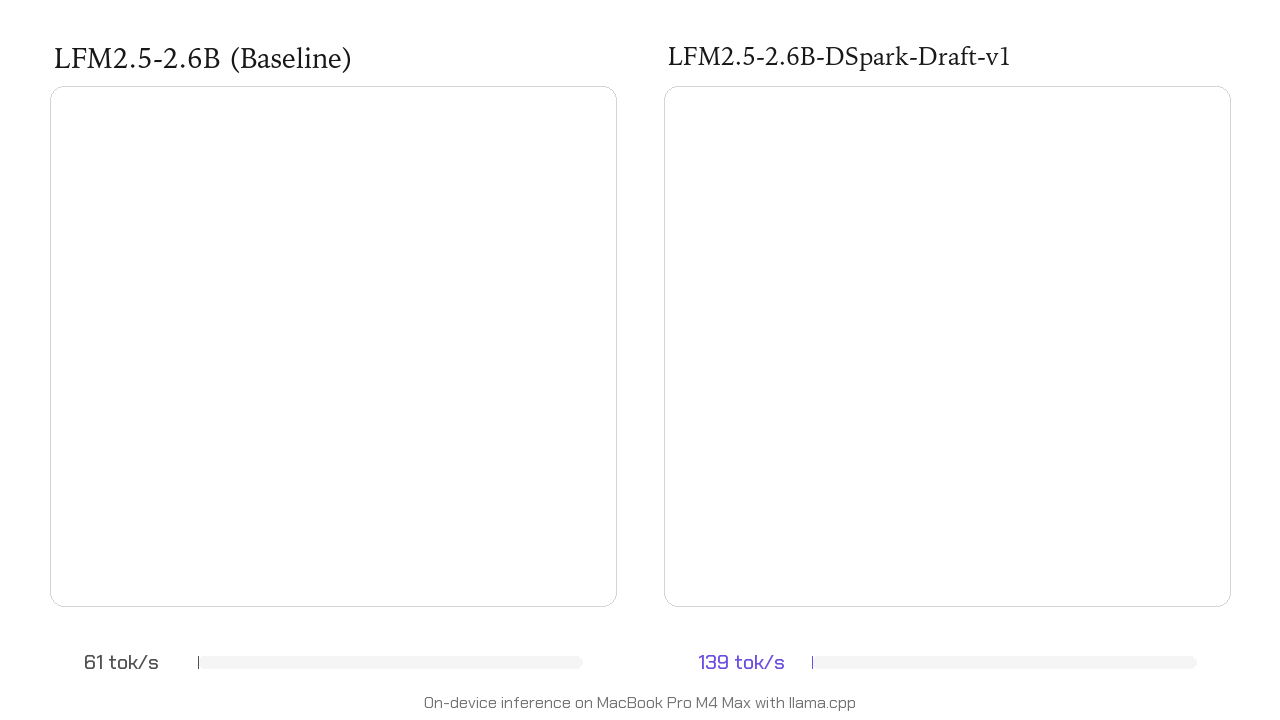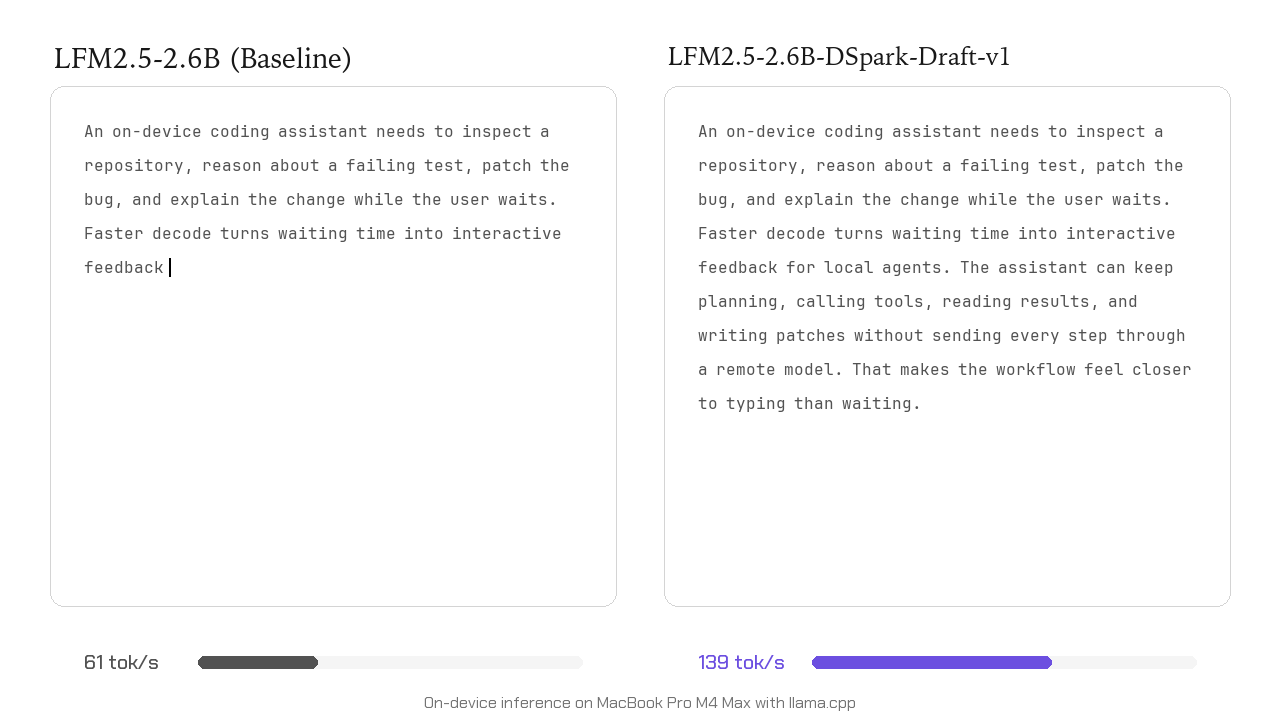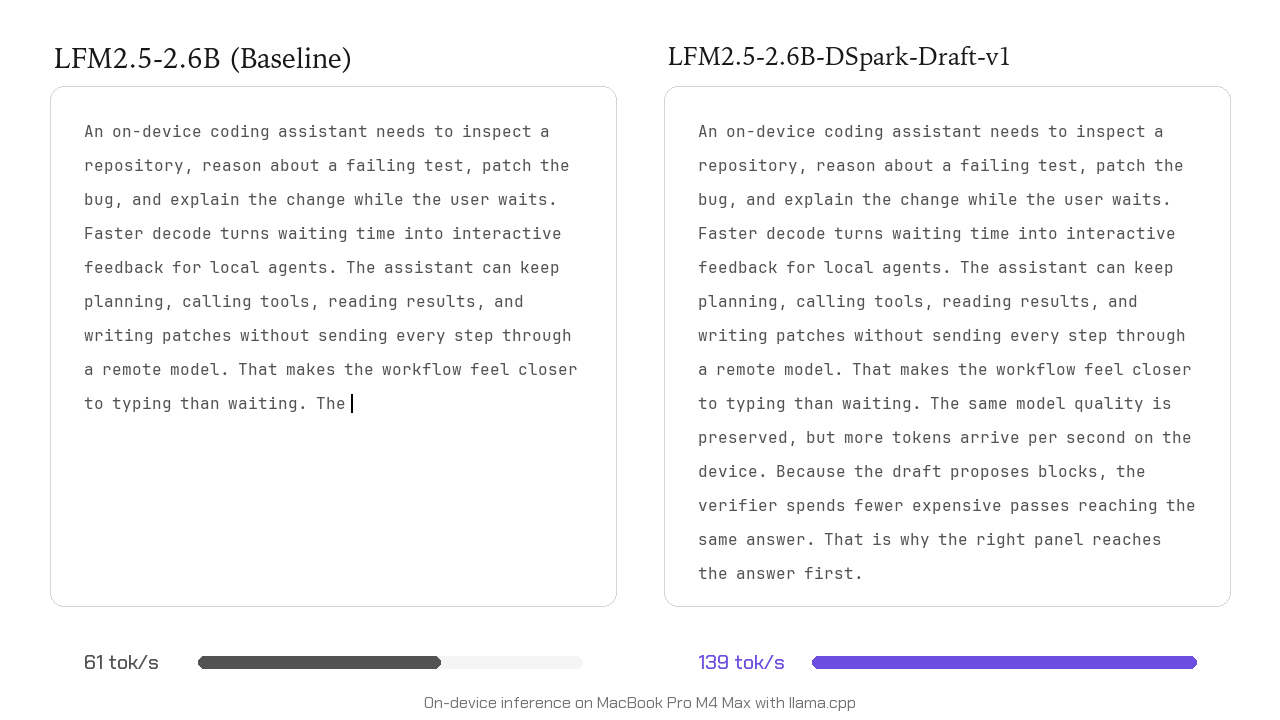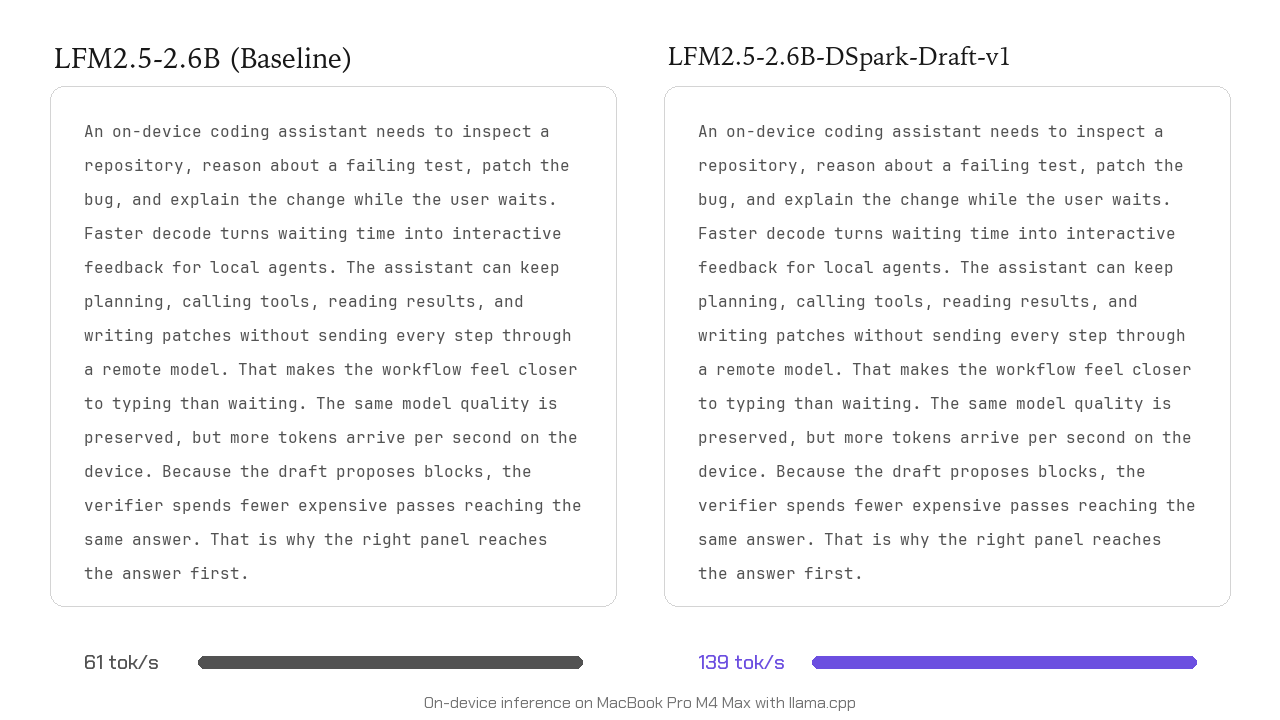
هوش مصنوعی: ۳ برابر سریعتر با مدل LFM2.5-DSpark Liquid AI
Liquid AI مدل LFM2.5-DSpark را منتشر کرد که تا ۳.۲ برابر اجرای سریعتر هوش مصنوعی را بدون کاهش کیفیت ارائه میدهد.
 محصولات
هوش مصنوعی GPT-5.6 Luna: تولید نرمافزار رایگان با Replit
رپلت با موتور هوش مصنوعی GPT-5.6 Luna قابلیت جدیدی به نام Free Mode را اضافه کرد تا هر کسی بتواند بدون نگرانی از هزینه توکن، نرمافزار بسازد.
 اخبار
آغاز آزمایش تبلیغات در ChatGPT؛ هوش مصنوعی رایگان ماندنی؟
OpenAI آزمایش تبلیغات در ChatGPT را آغاز کرد تا دسترسی رایگان به هوش مصنوعی را حفظ کند. جزئیات فنی، حریم خصوصی و آینده مدل رایگان را بشنوید.
 سختافزار
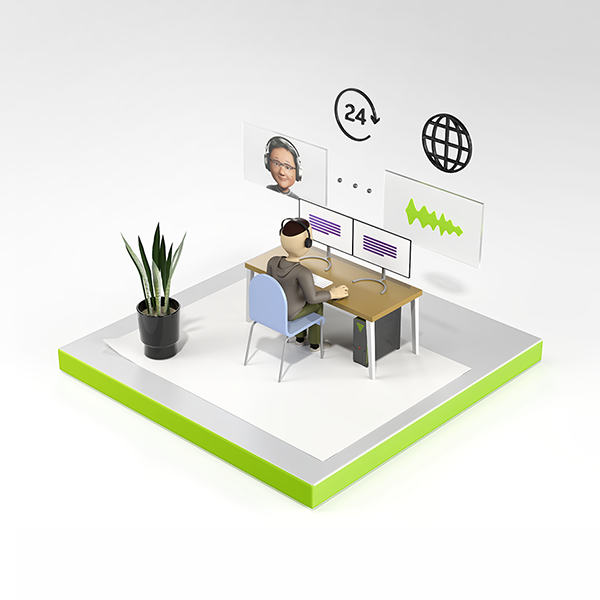
ساخت عاملهای صوتی چندزبانه با تأخیر کم: وزنهای باز و کنترل کامل استقرار با NVIDIA Magpie TTS
یک پست وبلاگ از NVIDIA در مورد بغل کردن صورت
 پژوهش
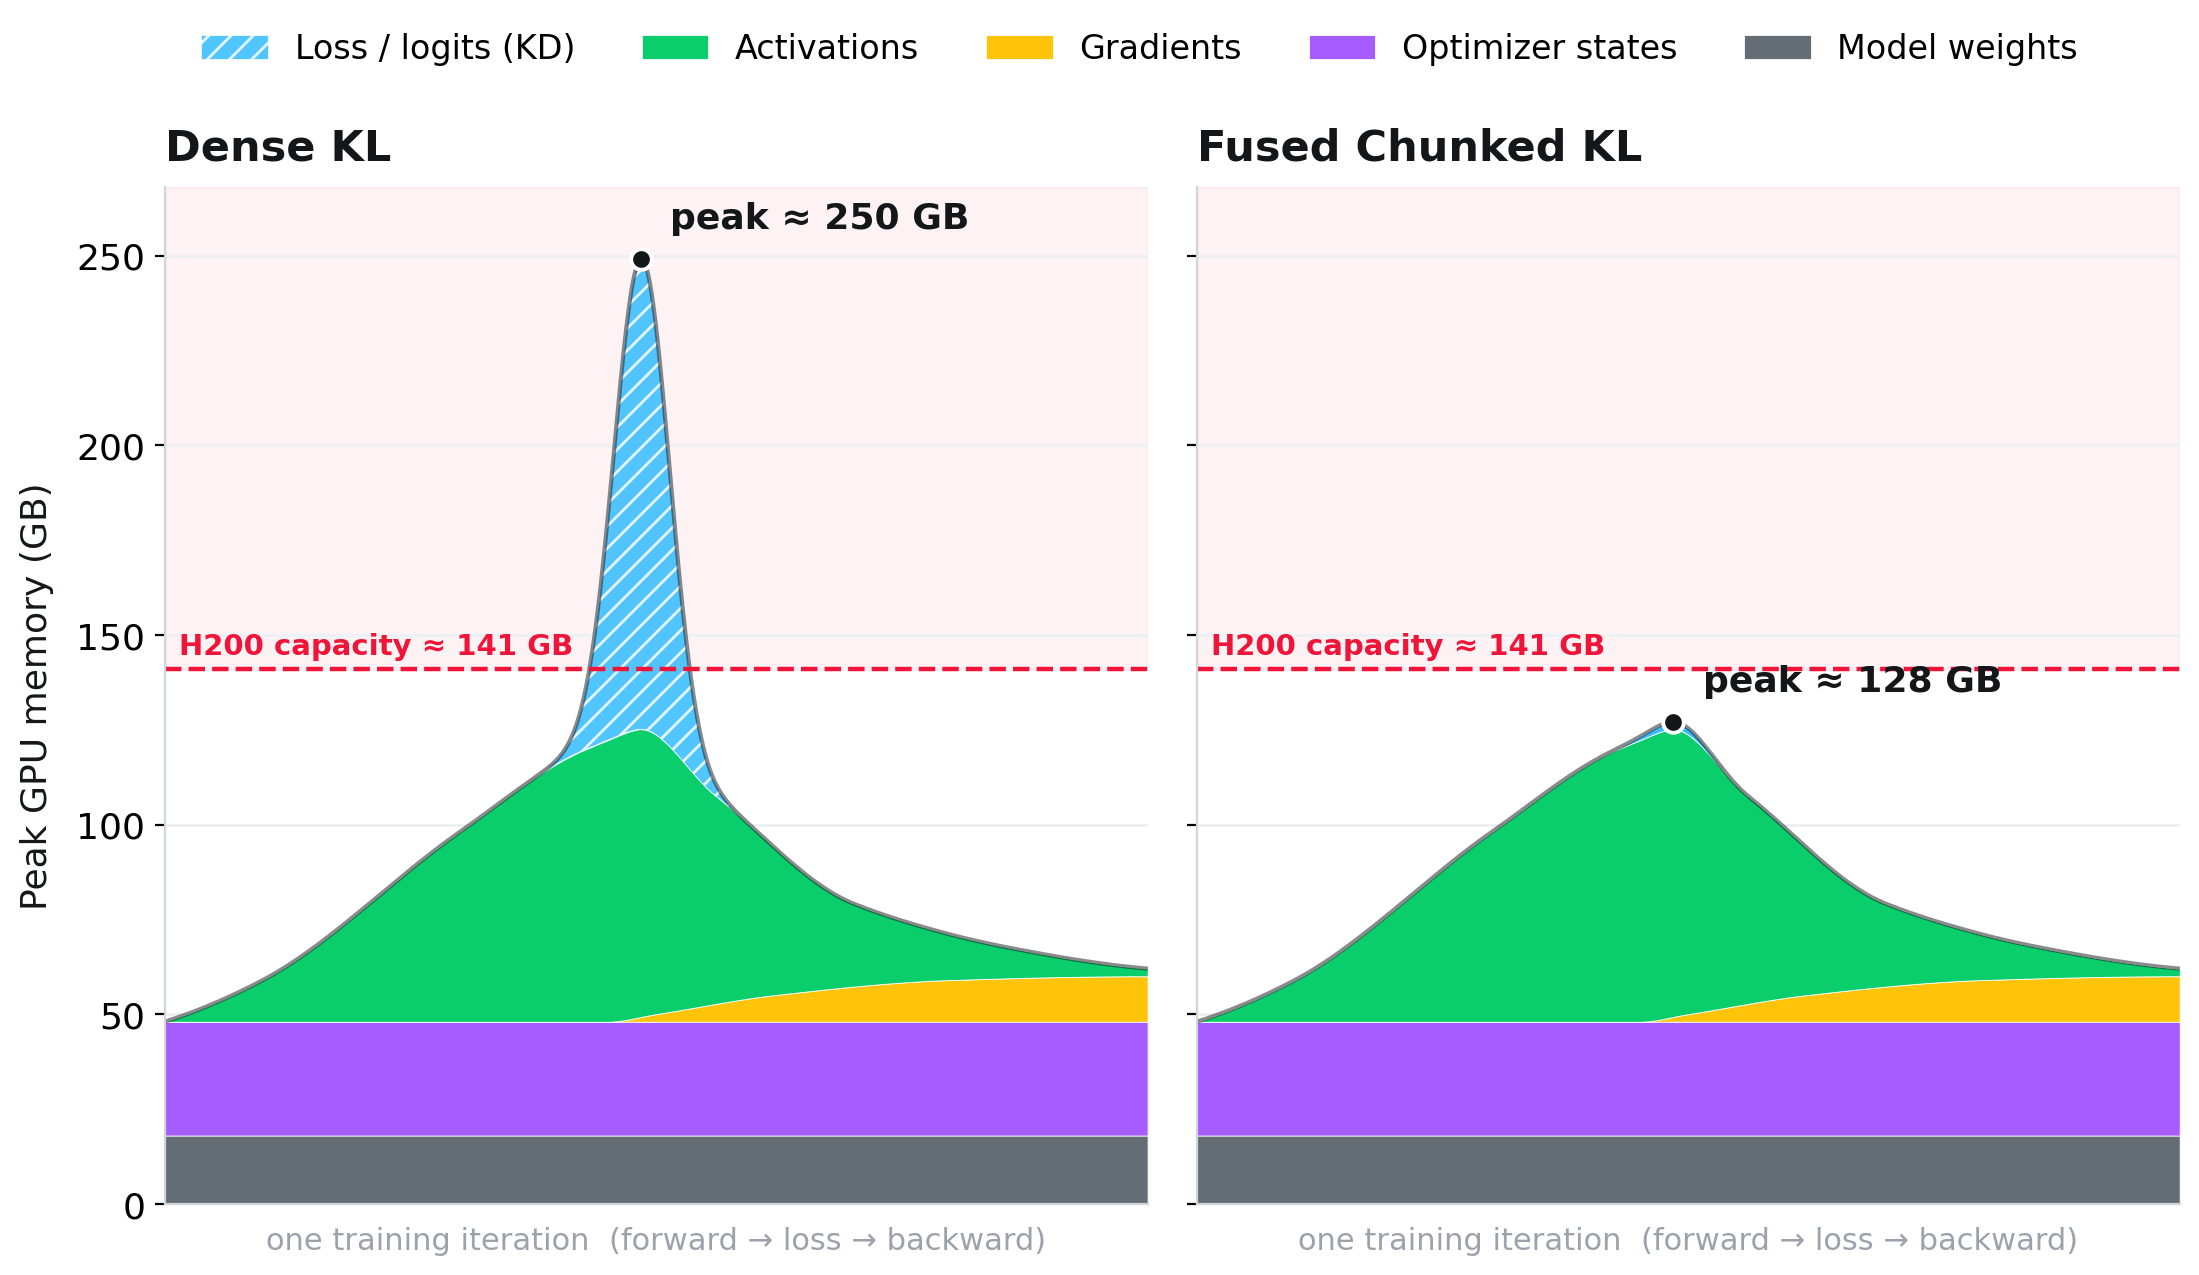
کالبدشکافی هوش مصنوعی: چگونه هوش مصنوعی را سریعتر کنیم؟
در این مقاله به بررسی تکنیکهای کاهش حجم مدلهای هوش مصنوعی، از جمله knowledge distillation میپردازیم و تاثیر آن بر آینده AI را تحلیل میکنیم.
 مدلها
هوش مصنوعی GPT-5.6 Sol: پیشرفتهای جدید در دقت و دسترسی رایگان
OpenAI نسخه بهینهشده GPT-5.6 Sol را در ChatGPT عرضه کرد؛ دسترسی رایگان گستردهتر و چتهای روزمره نامحدود با GPT-5.6 Luna.
 محصولات
هوش مصنوعی در فروشگاههای فیزیکی: ۳۰ هزار تعامل با نماینده دیجیتال یامادا دنکی
اپلیکیشن Avatarin با استفاده از GPT-Realtime، پشتیبانی چندزبانه ۲۴ ساعته را برای فروشگاههای یامادا دنکی فراهم کرده است.
 مدلها
GPT-5.6 مدل پیشرو اوپنایآی با هوش مصنوعی مقیاسپذیر و عملکرد برتر
اوپنایآی مدل GPT-5.6 را با عنوان هوش مرزی مقیاسپذیر معرفی کرد؛ عملکرد بالاتر به ازای هر توکن، قیمت مقرونبهصرفهتر و قابلیتهای بیشتر برای چالشهای دشوار.
 اخبار
سرعت بومی vLLM با کتابخانه Transformers در اکوسیستم هوش مصنوعی
Hugging Face اعلام کرد بکاند transformers در vLLM به سرعت بومی یا حتی بالاتر از پیادهسازیهای اختصاصی رسیده و توسعهدهندگان مدلهای زبانی میتوانند بدون هزینه اضافه، استنتاج فوقسریع داشته باشند.