معرفی LFM2.5-DSpark: انقلاب در سرعت استنتاج
شرکت Liquid AI مدلهای پیشرفتهای را تحت نام LFM2.5-DSpark در پلتفرم Hugging Face معرفی کرد که سرعت اجرای مدلهای زبانی بزرگ را به شکل چشمگیری بهبود میبخشد. این مدلها شامل نسخههای ۱.۲ میلیاردی، ۲.۶ میلیاردی و ترکیبی ۸ میلیارد پارامتری هستند و برای مصارف عملیاتی طراحی شدهاند.
چگونه DSpark کار میکند؟
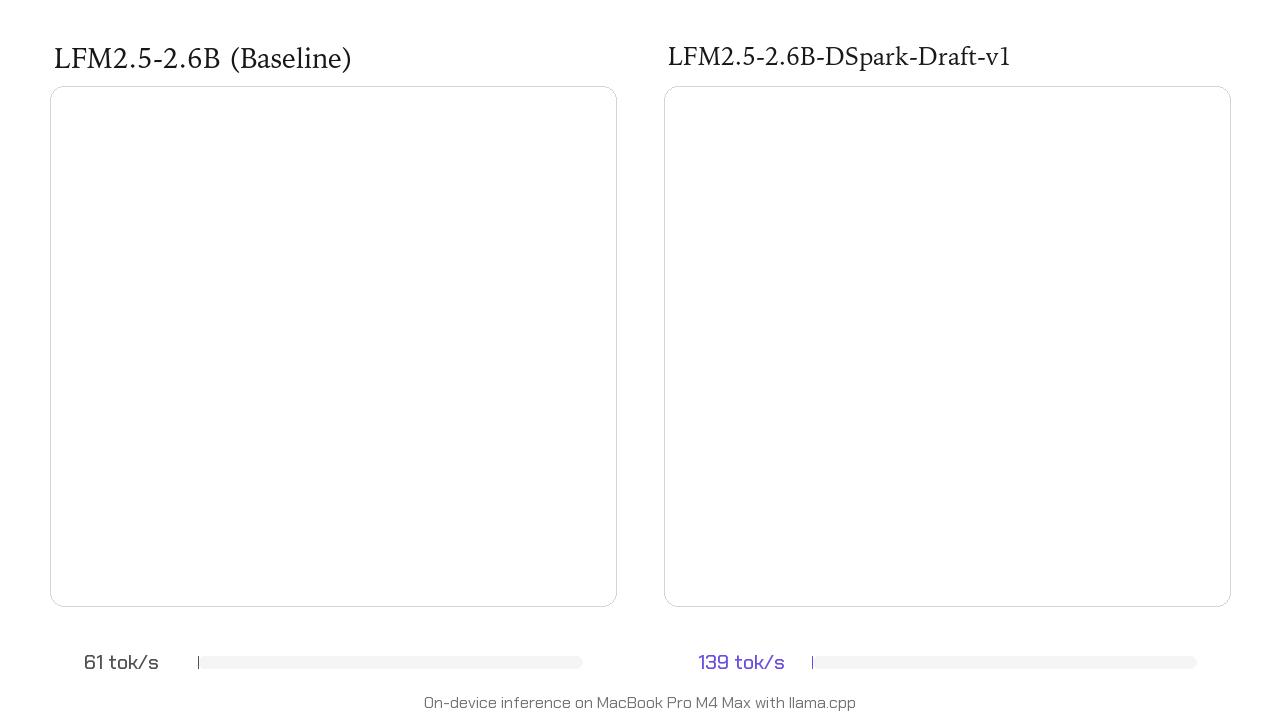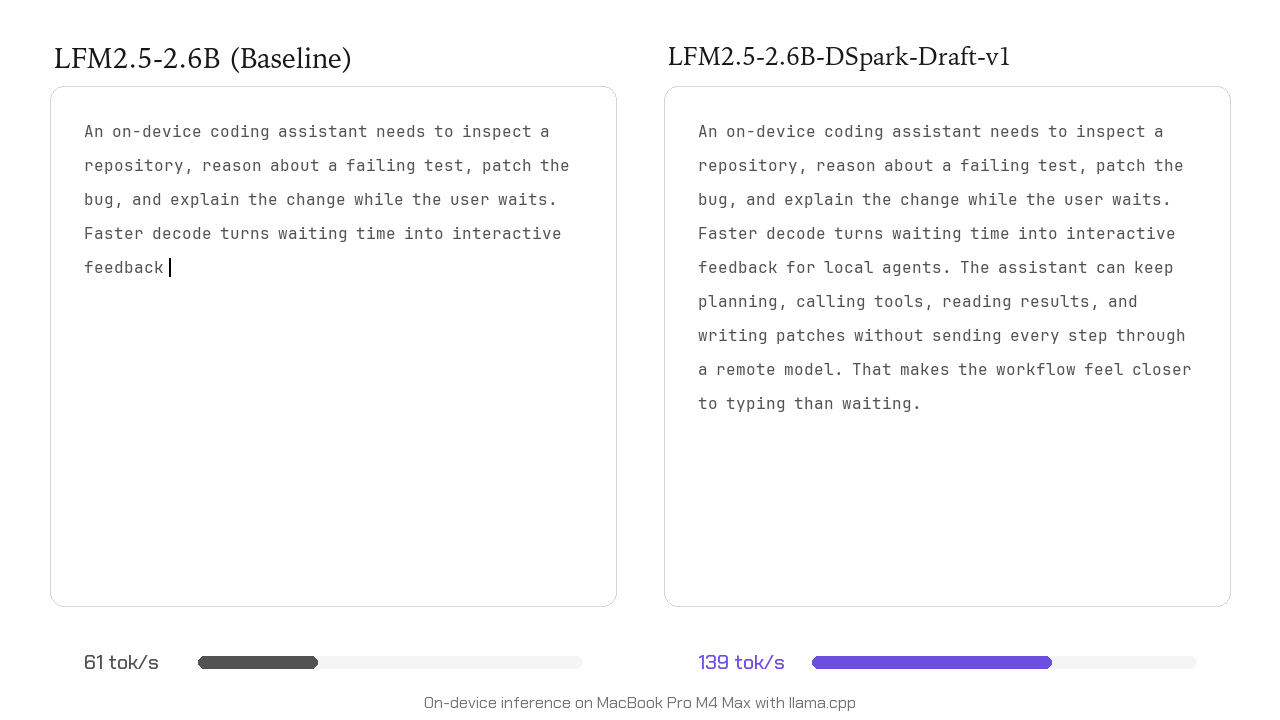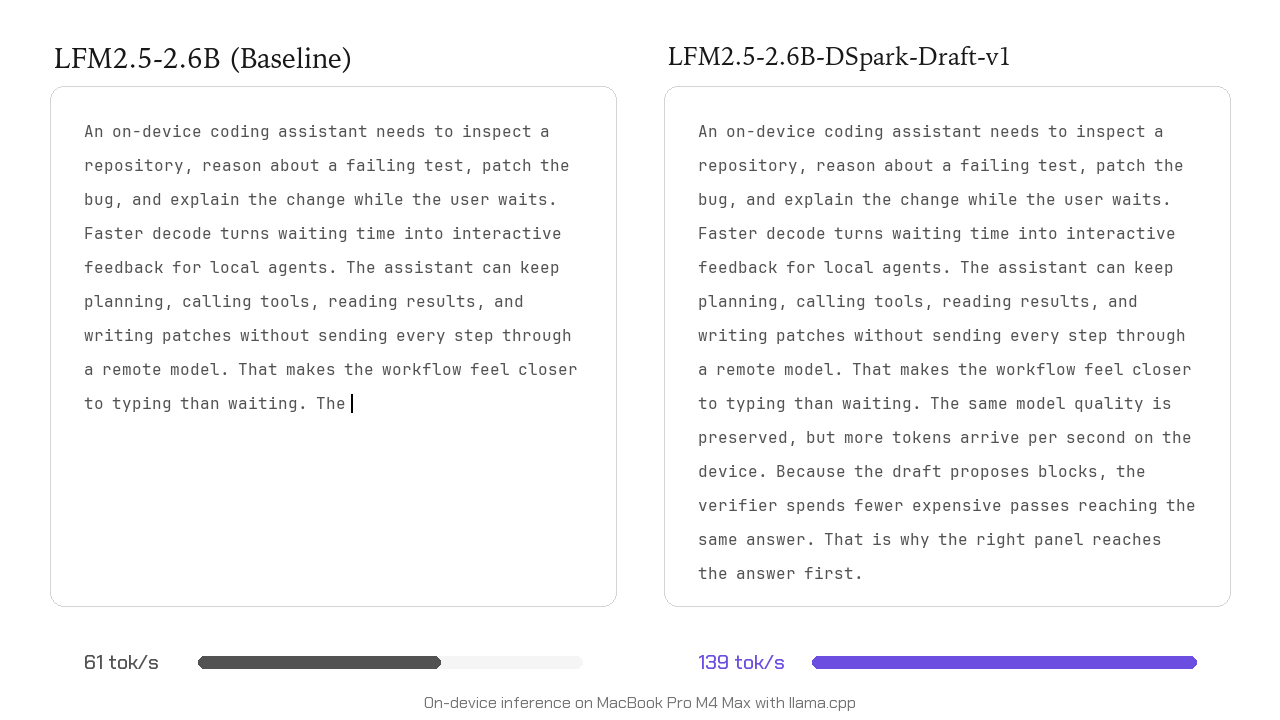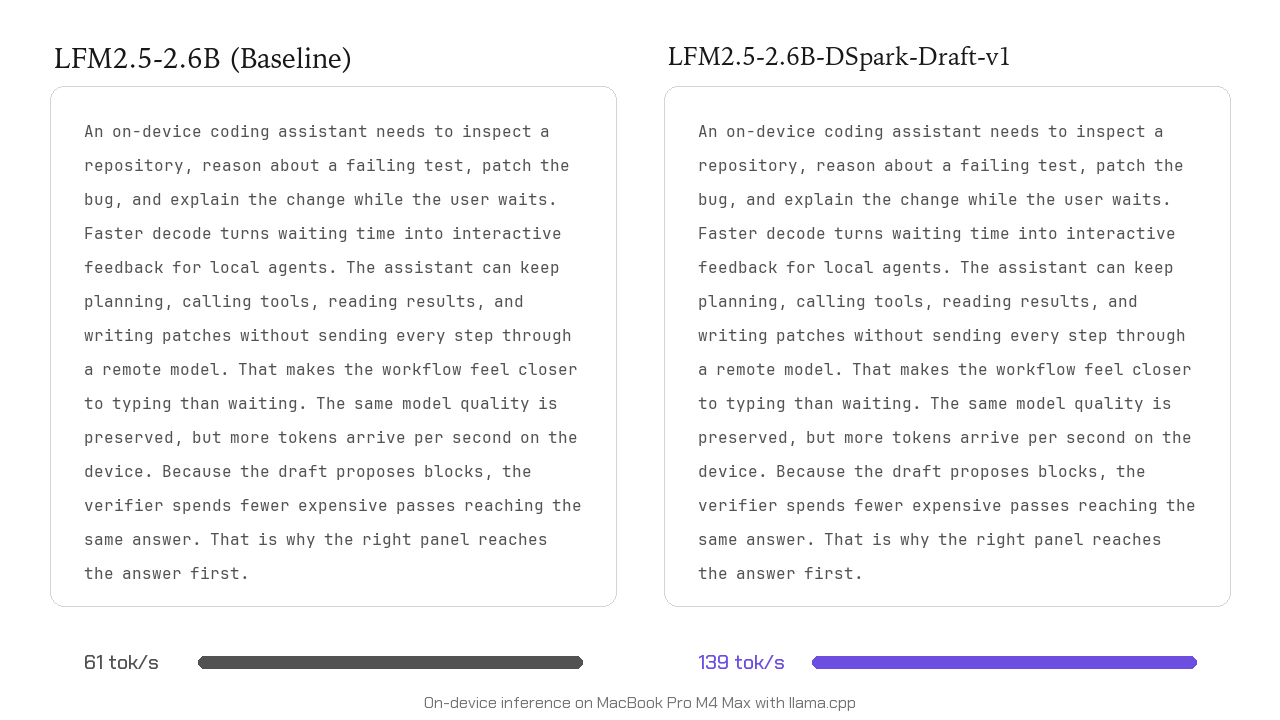
یکی از چالشهای اصلی در استنتاج مدلهای هوش مصنوعی، محدودیتهای حافظه است. در فرآیند سنتی، بخش عمدهای از زمان صرف بارگذاری دادهها از DRAM به SRAM میشود. الگوریتم DSpark با استفاده از روشهای حدسزنی هوشمندانه، این پاشنه آشیل را حل کرده و سرعت را به طرز چشمگیری افزایش میدهد.
در این روش، یک مدل سبکوزن کلمات احتمالی را پیشبینی کرده و سپس مدل اصلی با یک مرحله پردازش آنها را تایید میکند. این کار باعث بهینهسازی قابل توجه در مصرف منابع میشود.
مزایا و کاربردها
- سرعت استنتاج تا ۳.۲ برابر افزایش مییابد
- کاهش مصرف منابع سختافزاری
- حفظ کامل کیفیت خروجیها
- پشتیبانی از پردازش روی CPU و GPU
پرسشهای پرتکرار
مدل LFM2.5-DSpark چه تفاوتی با نسخه معمولی دارد؟
این مدل با استفاده از تکنیکهای پیشرفته بهینهسازی، سرعت اجرا را بدون کاهش کیفیت تا ۳.۲ برابر افزایش میدهد.
آیا استفاده از DSpark هزینه اضافی دارد؟
خیر، افزایش مصرف حافظه بسیار ناچیز است و در عوض سرعت اجرای قابل توجهی بهبود مییابد.