
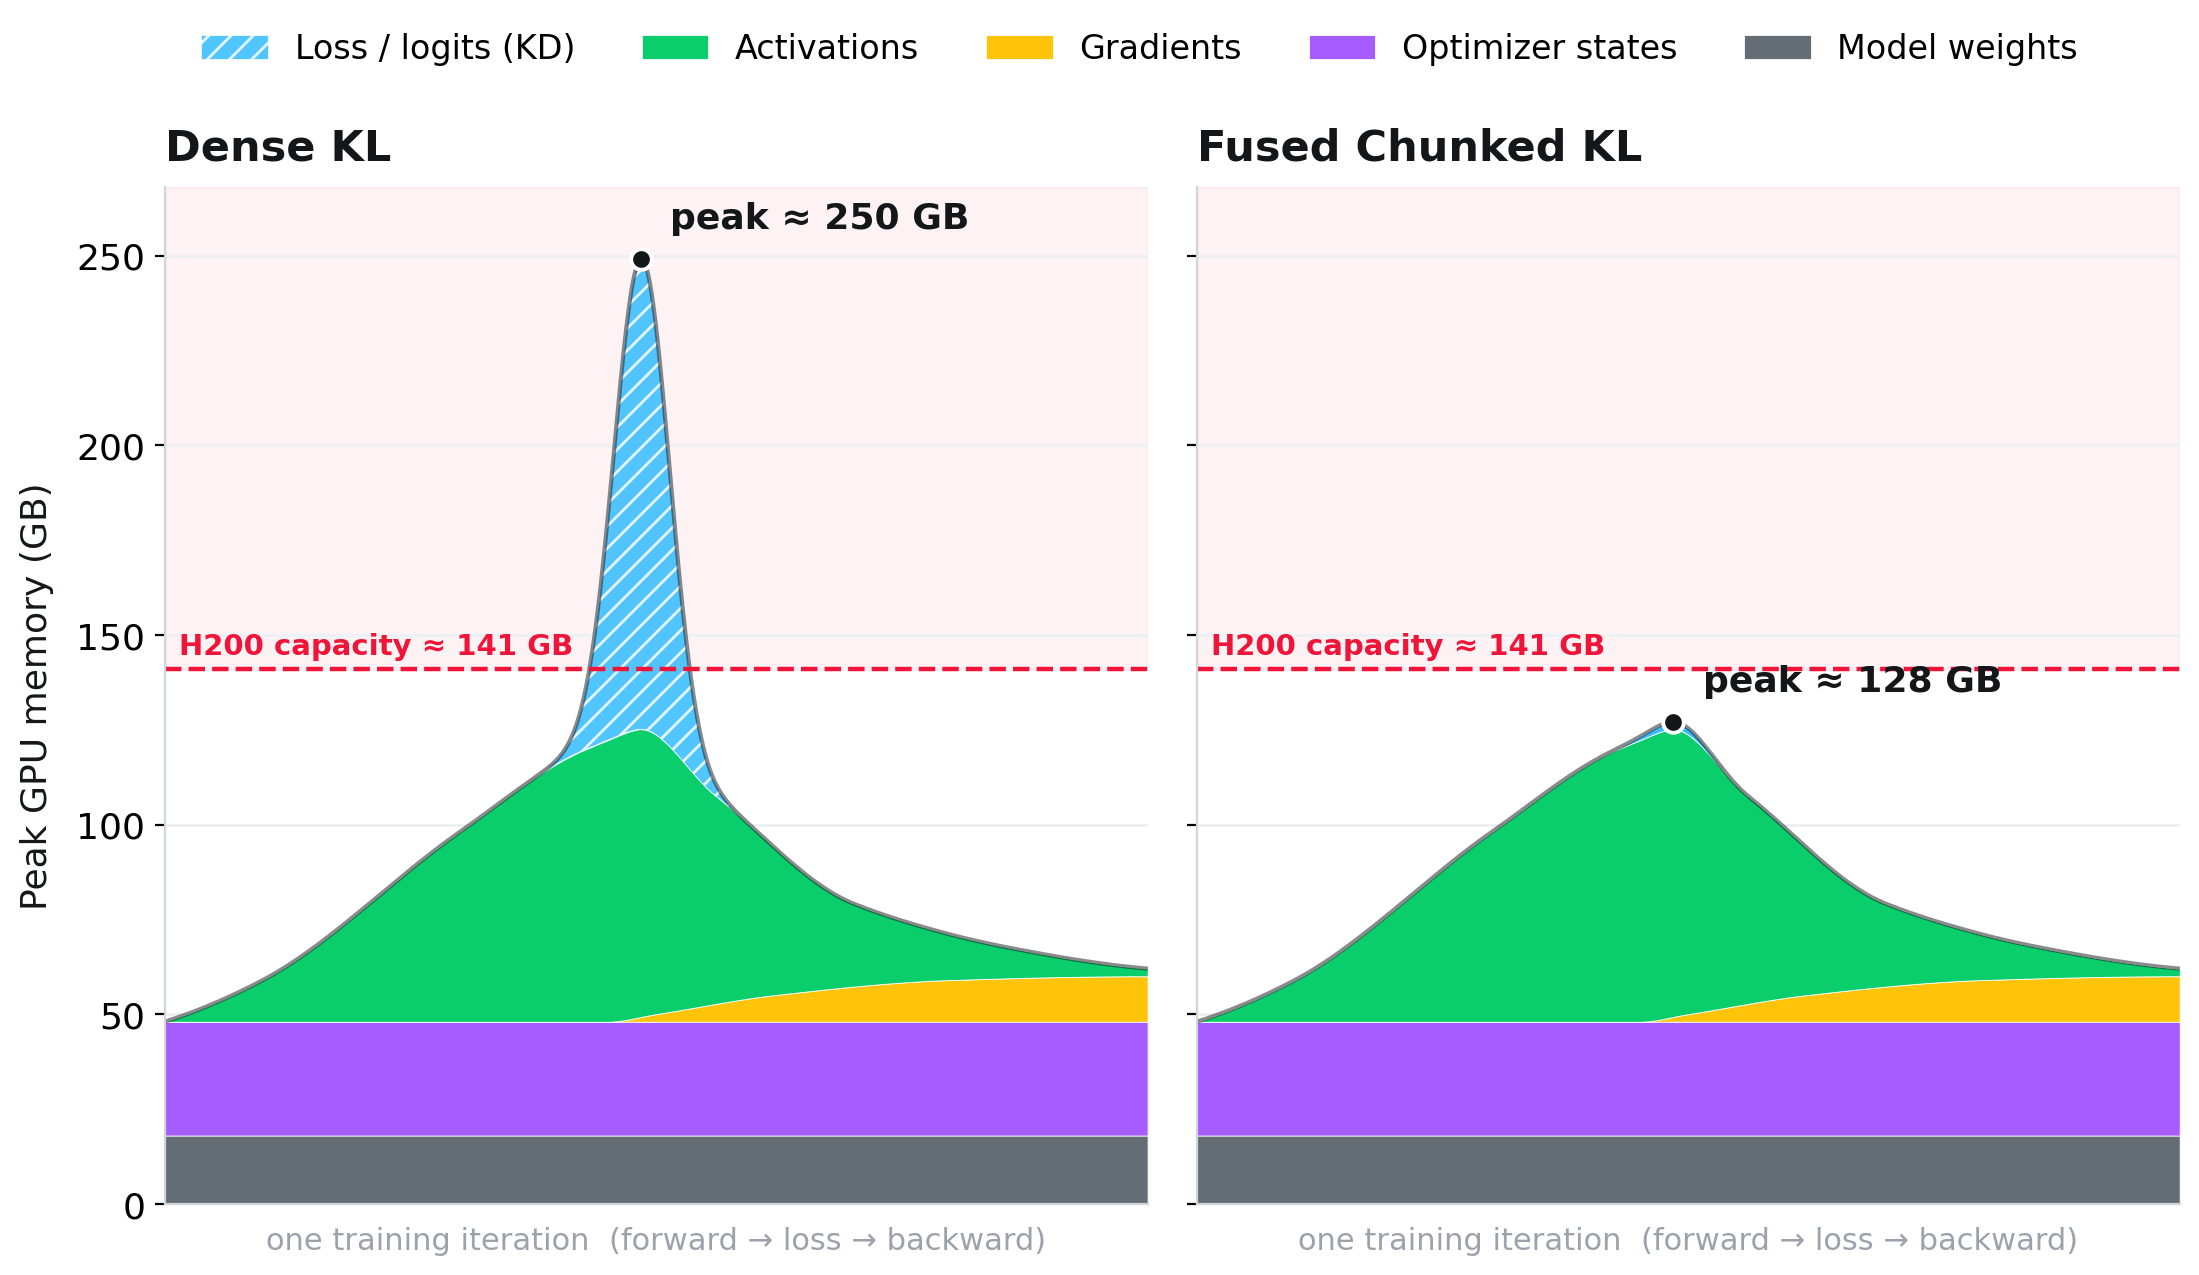
چرا جداسازی دانش هوش مصنوعی هزینهبر است؟
تکنیک Knowledge Distillation یا جداسازی دانش، روشی است که در آن یک مدل کوچکتر (دانشجو) آموزش میبیند تا عملکرد مدل بزرگتری (معلم) را تقلید کند. با ظهور مدلهای زبانی بزرگ متنباز مانند gpt-oss، Qwen، GLM و Kimi، این روش دوباره به یک موضوع پژوهشی اصلی تبدیل شده است.
دو تغییر سیستمی که همه چیز را تغییر داد
محدودیتهای منابع محاسباتی یکی از چالشهای اصلی است. مدل Kimi-K3 با ۲.۸ تریلیون پارامتر، تنها برای بارگذاری به حدود ۳ ترابایت حافظه گرافیکی نیاز دارد. شرکتهایی مانند Nvidia و Multiverse Computing با انتشار مدلهای فشردهشده باکیفیت، نشان دادهاند که فشردهسازی امکانپذیر است.
- بهینهسازی مراحل آموزش دانشآموز
- استفاده از کانتکستهای طولانیتر
- کاهش هزینههای محاسباتی
نتیجه: هوش مصنوعی مقیاسپذیرتر
با پیادهسازی این روشها، مدلهای کوچکتر میتوانند عملکرد مدلهای بزرگ را با هزینه بسیار کمتر ارائه دهند. این یعنی دسترسی گستردهتر به هوش مصنوعی برای کسبوکارها و پژوهشگران.
پرسشهای پرتکرار
جداسازی دانش (Knowledge Distillation) چیست؟
روش آموزشی است که در آن یک مدل کوچکتر سعی میکند عملکرد و دانش مدل بزرگتری را تقلید و یاد بگیرد.
آیا هوش مصنوعی مقیاسپذیر برای همه کسبوکارها مناسب است؟
بله، با کاهش هزینههای محاسباتی و فشردهسازی مدلها، استفاده از هوش مصنوعی برای کسبوکارهای کوچک و متوسط نیز امکانپذیر شده است.


