
 پژوهش
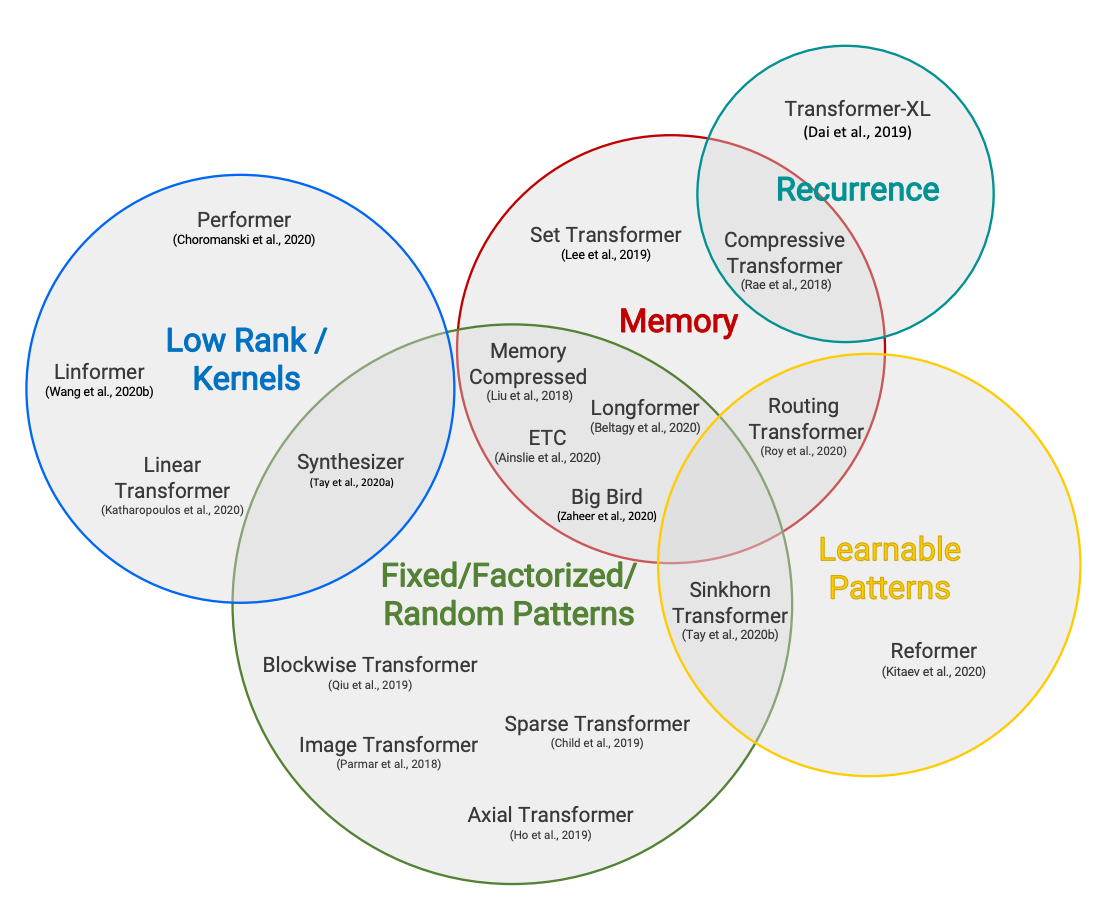
هوش مصنوعی در خواندن متنهای طولانی: معرفی ترنسفورمهای بلنددامنه
در این مقاله از سری خواندنیهای هوش مصنوعی، به معرفی ترنسفورمهای بلنددامنه و راهکارهای کاهش پیچیدگی محاسباتی برای پردازش متنهای طولانی میپردازیم.
 مدلها
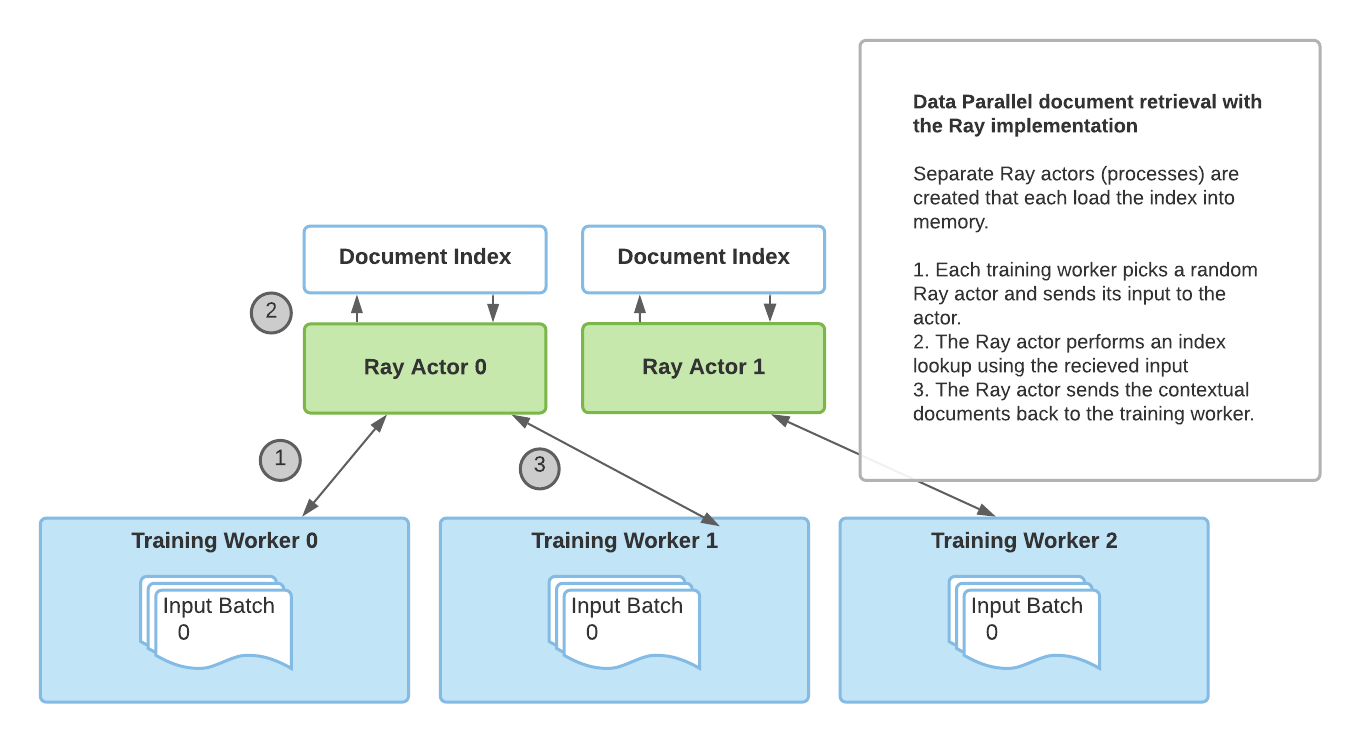
هوش مصنوعی با RAG و Ray: افزایش سرعت بازیابی متن تا ۲ برابر
با ترکیب RAG و Ray، سرعت بازیابی اسناد در مدلهای زبانی هوش مصنوعی تا ۲ برابر افزایش یافته و مقیاسپذیری تنظیم دقیق توزیعشده نیز بهطور چشمگیری بهبود مییابد.
 پژوهش
هوش مصنوعی و مدلهای زبانی بزرگ: قابلیتها، محدودیتها و تأثیرات اجتماعی
گزارش جدید OpenAI درباره قابلیتها و کاستیهای مدلهای زبانی بزرگ و تأثیر آنها بر جامعه؛ مروری بر نکات کلیدی و درسهای مهم برای توسعهدهندگان و کاربران هوش مصنوعی.
 پژوهش
گرمآغاز کردن مدلهای Encoder-Decoder با هوش مصنوعی؛ راهکاری برای بهبود عملکرد
در این مقاله از وبلاگ هوما، روش گرمآغاز کردن مدلهای زبانی Encoder-Decoder با استفاده از checkpointهای BERT و GPT2 بررسی میشود. این تکنیک در ترجمه ماشینی، خلاصهسازی و سایر وظایف seq2seq عملکرد بهتری به ارمغان میآورد.
 مدلها
مدلهای Encoder-Decoder مبتنی بر ترنسفورمر؛ چگونه هوش مصنوعی متن میفهمد؟
در این مقاله به بررسی عمیق معماری ترنسفورمری Encoder-Decoder میپردازیم؛ مدلی که پایهگذار نسل جدید سیستمهای هوش مصنوعی در پردازش زبان طبیعی و تولید محتوا است.
 مدلها
بهینهسازی مدلهای زبانی با ماتریسهای اسپارس بلوکی در هوش مصنوعی
آشنایی با pytorch_block_sparse، ابزار جدید Hugging Face برای کاهش حجم و افزایش سرعت مدلهای زبانی با بهرهگیری از ماتریسهای اسپارس بلوکی.
 پژوهش
آموزش مدلهای هوش مصنوعی برای خلاصهسازی بهتر با بازخورد انسانی
OpenAI با استفاده از یادگیری تقویتی از بازخورد انسانی، مدلهای زبانی را برای خلاصهسازی دقیقتر و باکیفیتتر آموزش داده است. این روش نتایج بهتری دارد.
 پژوهش
آموزش کمنمونه در هوش مصنوعی: معرفی GPT-3 و یادگیری چند نمونهای
مقالهای درباره GPT-3 و مفهوم few-shot learning که نشان میدهد مدلهای زبانی بزرگ چگونه با چند مثال، وظایف متنوع را بدون آموزش مجدد یاد میگیرند.
 آموزش
تولید متن با هوش مصنوعی: بررسی روشهای Decoding در مدلهای زبانی
در این مقاله از وبلاگ هوما، روشهای مختلف تولید متن با مدلهای زبانی مانند جستجوی حریصانه، beam search، sampling و top-p را بررسی میکنیم و نحوه پیادهسازی آنها را با کتابخانه transformers یاد میگیریم.
 پژوهش
قوانین مقیاسپذیری مدلهای زبانی؛ راز پیشرفت هوش مصنوعی
تحقیقات OpenAI نشان میدهد عملکرد مدلهای زبانی با افزایش داده، پارامترها و توان محاسباتی به شکلی قابل پیشبینی بهبود مییابد. این مقاله به بررسی این قوانین و پیامدهای آن برای آینده هوش مصنوعی میپردازد.