
 اخبار
هوش مصنوعی پیشبینی رفتار انسان؛ Mirror Particle مدل جهانی میسازد
استارتاپ Mirror Particle با ساخت مدل جهانی رفتار انسان، گام تازهای در پیشبینی رفتار مصرفکننده برداشته و روشهای مبتنی بر LLM را ناکافی میداند.
 سختافزار
PrismML تراشههای LLM کوچک خود را به عینکهای هوشمند مجهز به کوالکام میآورد
هدف بزرگتر پریزم، هوش مصنوعی متنبازی است که روی دستگاهها اجرا شود و از قدرت محاسباتی موجود در آنها بهتر استفاده کند.
 پژوهش
AI hallucination nearly triggers US military operation
“It’s important for service members to understand the uncertainty inherent to LLMs," a GovAI research scholar warns.
 مدلها
LLMs respond differently to harmful prompts when AI watermarking is used
SynthID can cause models to follow harmful instructions they would otherwise refuse.
 پژوهش
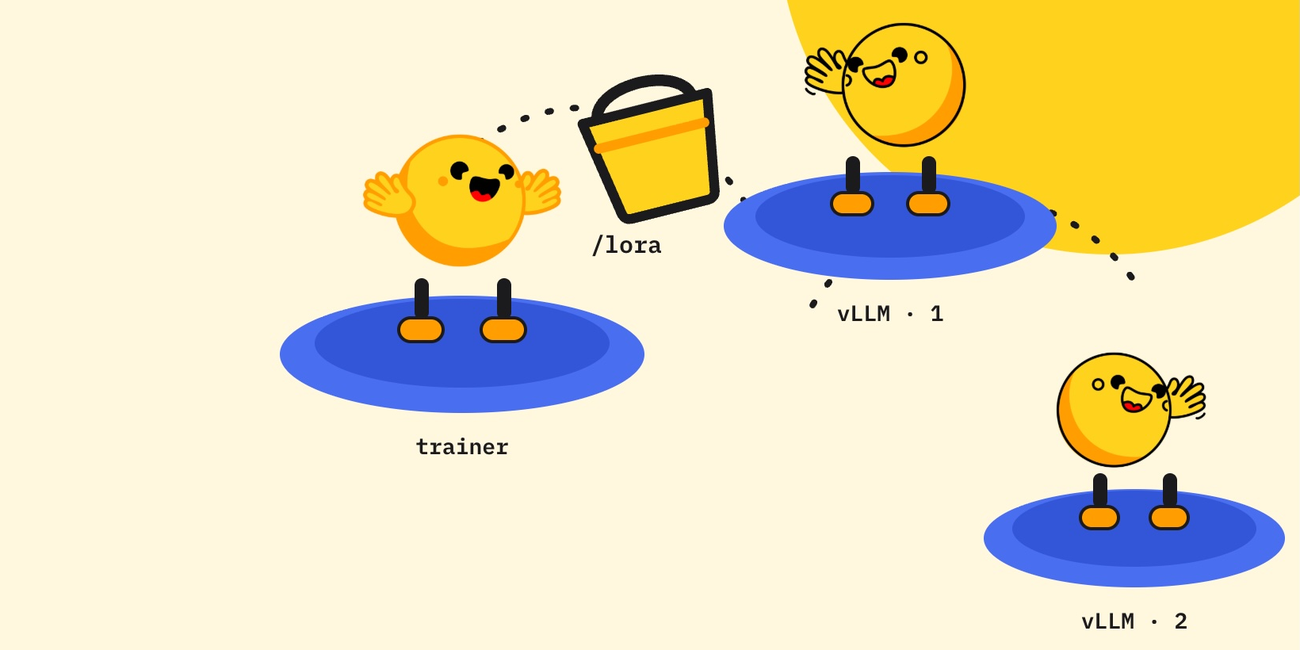
آموزش ناهمزمان GRPO با LoRA؛ گامی نو در هوش مصنوعی متنباز
TRL v1.14 با پشتیبانی LoRA در AsyncGRPOTrainer، آموزش و استنتاج را از هم جدا میکند. مقاله به بررسی معماری سهلایه و استفاده از Storage Buckets میپردازد.
 پژوهش
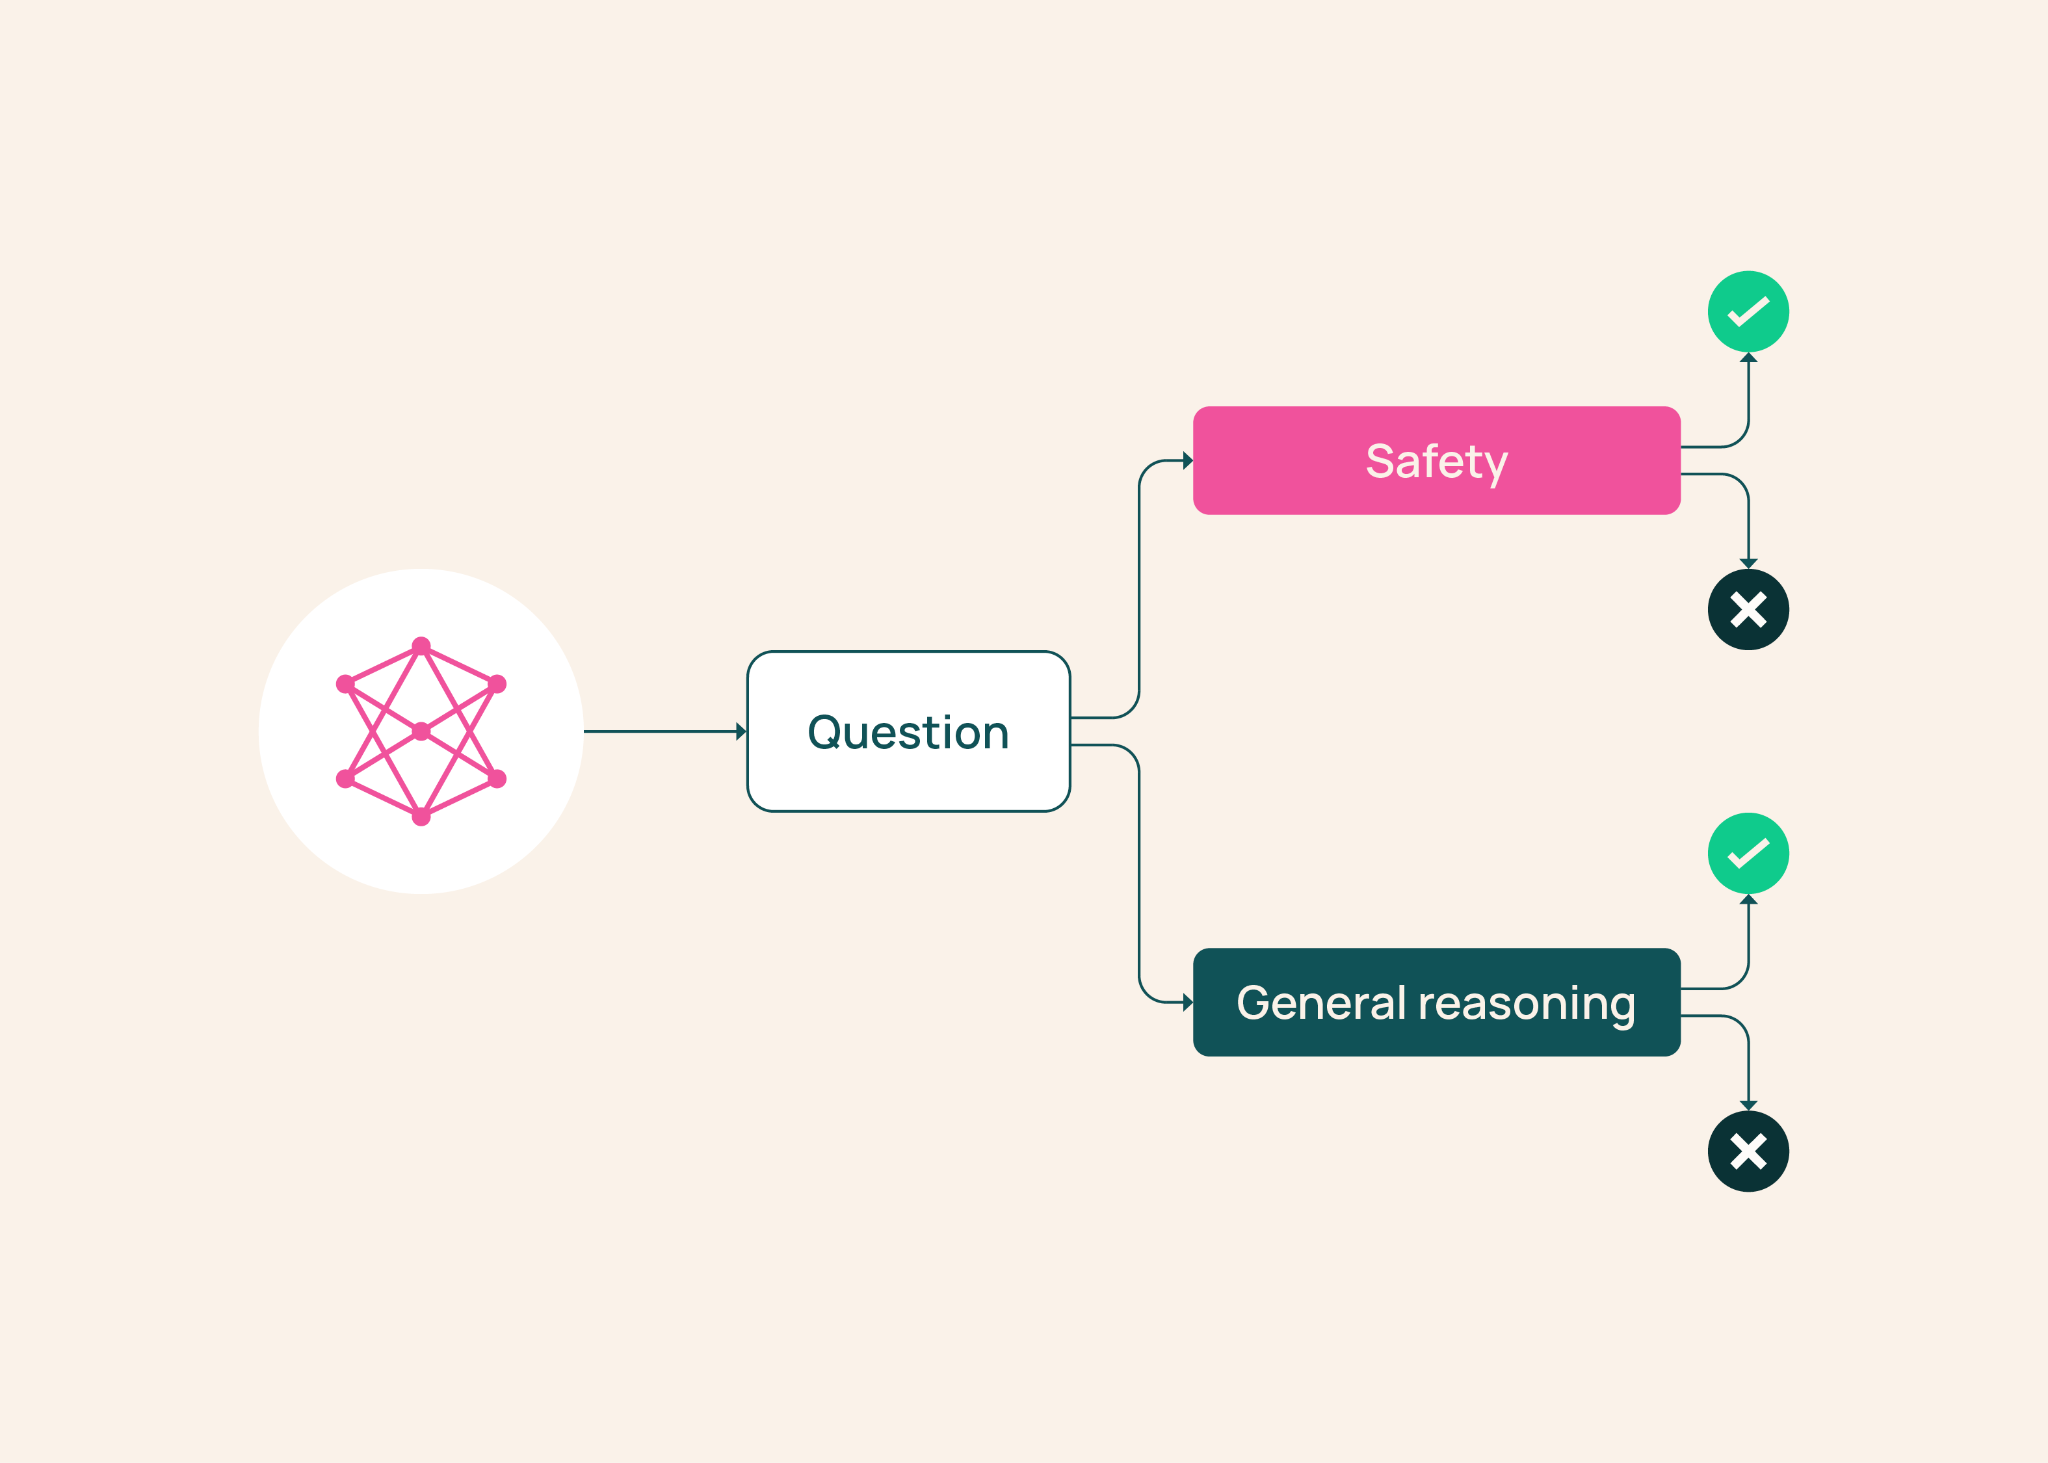
BenchMIRT: آنچه معیارهای هوش مصنوعی واقعاً اندازه میگیرند
BenchMIRT روشی نوین از Ai2 برای ممیزی معیارهای مدلهای زبانی در سطح تکتک پرامپتهاست؛ این رویکرد نشان میدهد معیارها واقعاً تواناییهای اصلی را میسنجند یا نه.
 اخبار
سرعت بومی vLLM با کتابخانه Transformers در اکوسیستم هوش مصنوعی
Hugging Face اعلام کرد بکاند transformers در vLLM به سرعت بومی یا حتی بالاتر از پیادهسازیهای اختصاصی رسیده و توسعهدهندگان مدلهای زبانی میتوانند بدون هزینه اضافه، استنتاج فوقسریع داشته باشند.
 اخبار
راهاندازی سرور vLLM روی Hugging Face Jobs فقط با یک دستور
هگینگفیس قابلیت جدیدی ارائه داده که با یک دستور ساده میتوانید سرور vLLM سازگار با OpenAI را روی زیرساخت ابری آنها راهاندازی کنید؛ بدون نیاز به کوبرنتیز و با پرداخت به ازای ثانیه استفاده.
 اخبار
اوپنایآی و برادکام چیپ اختصاصی «هالاپینو» را برای هوش مصنوعی معرفی کردند
اوپنایآی و برادکام تراشهٔ اختصاصی Jalapeño را برای اجرای مدلهای بزرگ زبانی رونمایی کردند. این چیپ عملکرد، بازده انرژی و مقیاسپذیری سیستمهای هوش مصنوعی را بهطور چشمگیری بهبود میبخشد.
 پژوهش
هوش مصنوعی: حداکثر بهرهوری GPU با Continuous Batching و انکپسولیشن ناهمزمان
Continuous Batching و انکپسولیشن ناهمزمان در هوش مصنوعی، بهترین راه برای بهینهسازی GPU و کاهش هزینههای عملیاتی در مدلهای LLM و بهرهوری را به ۳۰۰٪ افزایش میدهد.