
 پژوهش
هوش مصنوعی vLLM: مهاجرت از V0 به V1 با تمرکز بر صحت قبل از اصلاحات
مقاله جدید ServiceNow-AI در هافنگ فیچ، جزئیات migration vLLM V0 به V1 را بررسی میکند؛ چگونگی اصلاح پیکربندیهای backend برای بهبود دقت RL و کاهش انحراف در لودپروبها.
 پژوهش
هوش مصنوعی فروشگاهها: معرفی Ecom-RLVE و محیطهای قابل اعتماد برای نمایندگان گفتگو
Ecom-RLVE، چارچوبی پیشرفته برای نمایندگان گفتگوی فروشگاههای آنلاین، با هشت محیطی قابل تأیید، دوره سختی ۱۲محور و الگوریتم یادگیری تقویتی DAPO، تبدیل به یک ابزار کلیدی در تجارت الکترونیک میشود.
 پژوهش
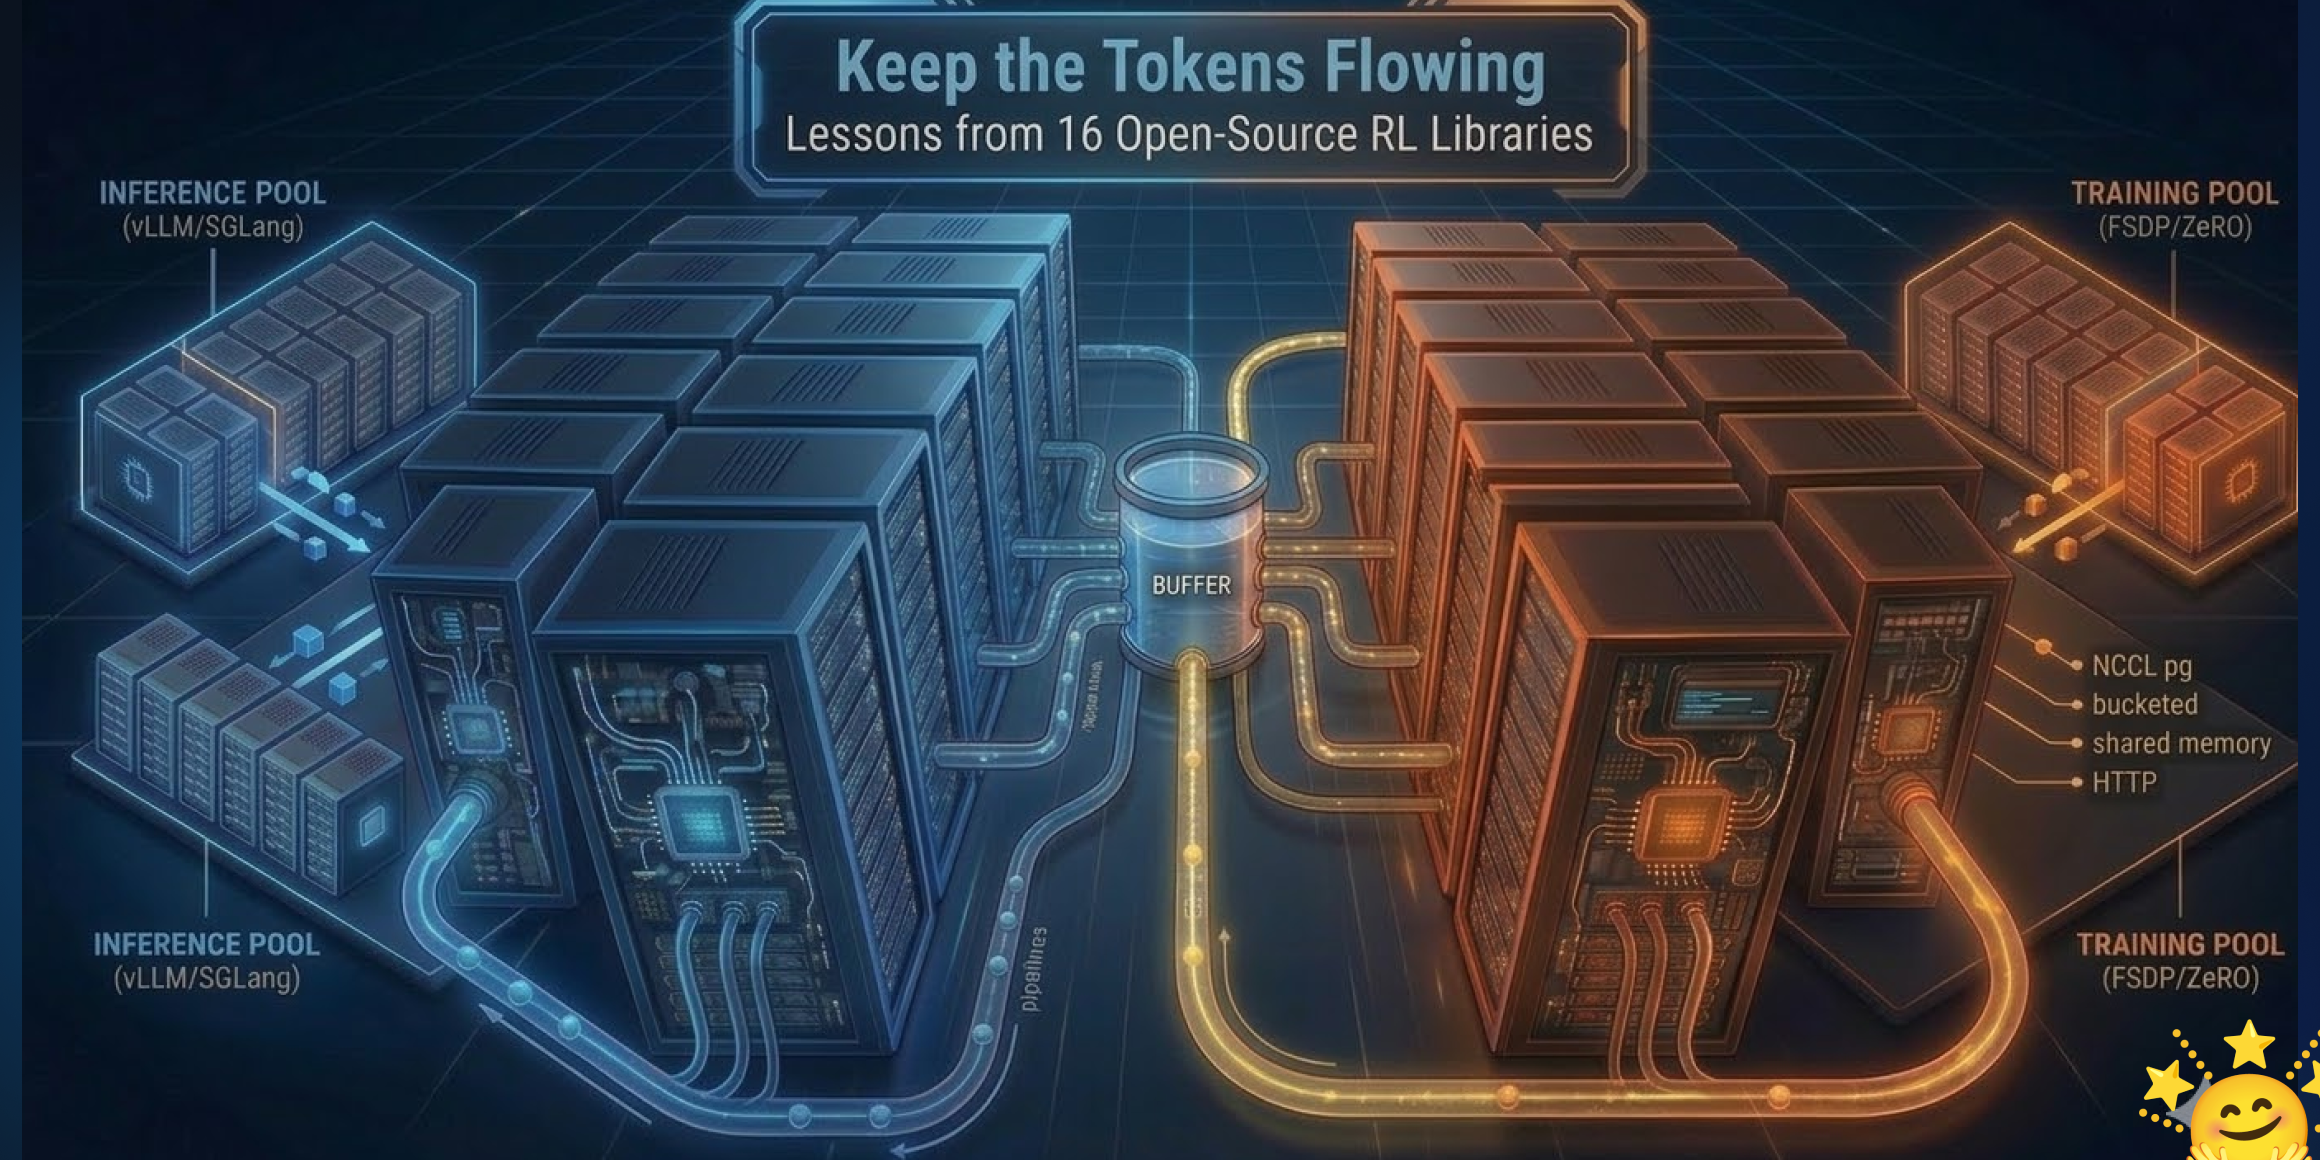
هوش مصنوعی: در وادی 16 کتابخانه RL متن باز نکات کلیدی
کاربردهای یادگیری تقویتی در فضای متن باز؛ بررسی 16 کتابخانه RL و نکاتی برای بهینهسازی مصرف GPU، طراحی معماریهای ناهمزمان، و تأثیر آن بر مقیاسپذیری.
 پژوهش
هوش مصنوعی در GPT-OSS: کشف آموزش RL عاملانه و کاربردهای عملی
مقاله فوری درباره استفاده از RL عاملانه در GPT-OSS، مشکلات و راهحلهای میدانی از تنظیم دقیق و همگامسازی MoE با FlashAttentionV3.
 پژوهش
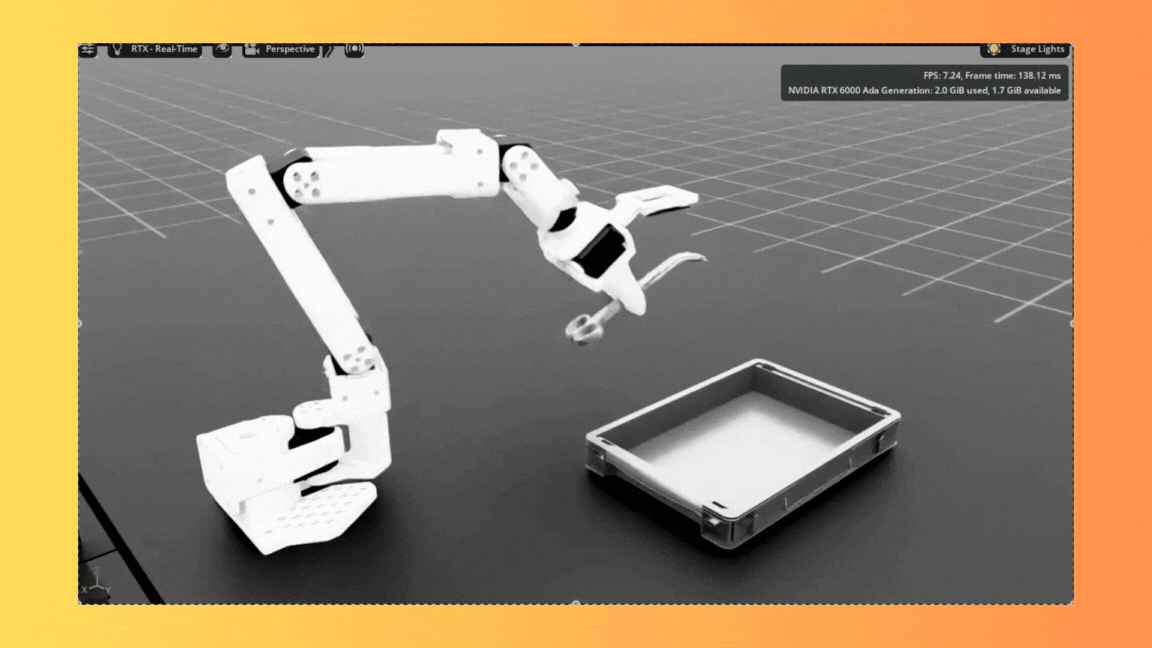
ربات پزشکی هوش مصنوعی: از شبیهسازی تا نحوه مستقر شدن
چرا ربات پزشکی مجهز به هوش مصنوعی از شبیهسازی در گیموکس تا مستقر شدن در عمارتها میتواند درمانهای سریع، دقیق و بهینه بگه؟ راهکار عملی نجاتکننده در این مقاله بررسی شد.
 پژوهش
PipelineRL از سرویسنوا: هوش مصنوعی در یادگیری تقویتی نوآورانه
PipelineRL با بهروزرسانی وزنهای در حین آموزش و معماری ماژولار، عملکردی مشابه Open-Reasoner-Zero را بهدنبال دارد.کد منبع در Hugging Face موجود است.
 پژوهش
هوش مصنوعی Mini-R1: بازتولید لحظهٔ آشکار DeepSeek‑R1 در یادگیری تقویتی
Mini‑R1 تیم Open R1 بهوسیلهی یادگیری تقویتی لحظهٔ آشکار DeepSeek‑R1 را بازتولید کرد؛ در این راهنما گامهای کلیدی و نتایج را بررسی میکنیم.
 پژوهش
هوش مصنوعی Open-R1: بازتولید کامل مدل DeepSeek-R1 با کد باز
در ژانویه ۲۰۲۵، پژوهشی به نام Open‑R1، مدل DeepSeek‑R1 را با کد کامل باز منتشر کرد، که بهوسیله یادگیری تقویتی خالص، قدرت استدلال مدل را شبیه به یا بهتر از مدلهای تجاری تقویت میکند.
 مدلها
معرفی JAT؛ هوش مصنوعی همهکاره Hugging Face برای محیطهای متنوع
مدل JAT یک عامل چندمنظوره هوش مصنوعی است که با دادههای تخصصی از محیطهایی مانند Atari، BabyAI، Meta-World و MuJoCo آموزش دیده و اکنون بهصورت متنباز در دسترس است
 پژوهش
هوش مصنوعی: بهبود مدلهای زبانی با روشهای بهینهسازی ترجیحات مستقیم
در آخرین پژوهش از هاگفیس، روشهای بهینهسازی ترجیحات مستقیم میتوانند مدلهای زبانی را بدون استفاده از یادگیری تقویتی همگرا کنند. نتایج نشان میدهد IPO مشابه DPO و بهتر از KTO است.