
 پژوهش
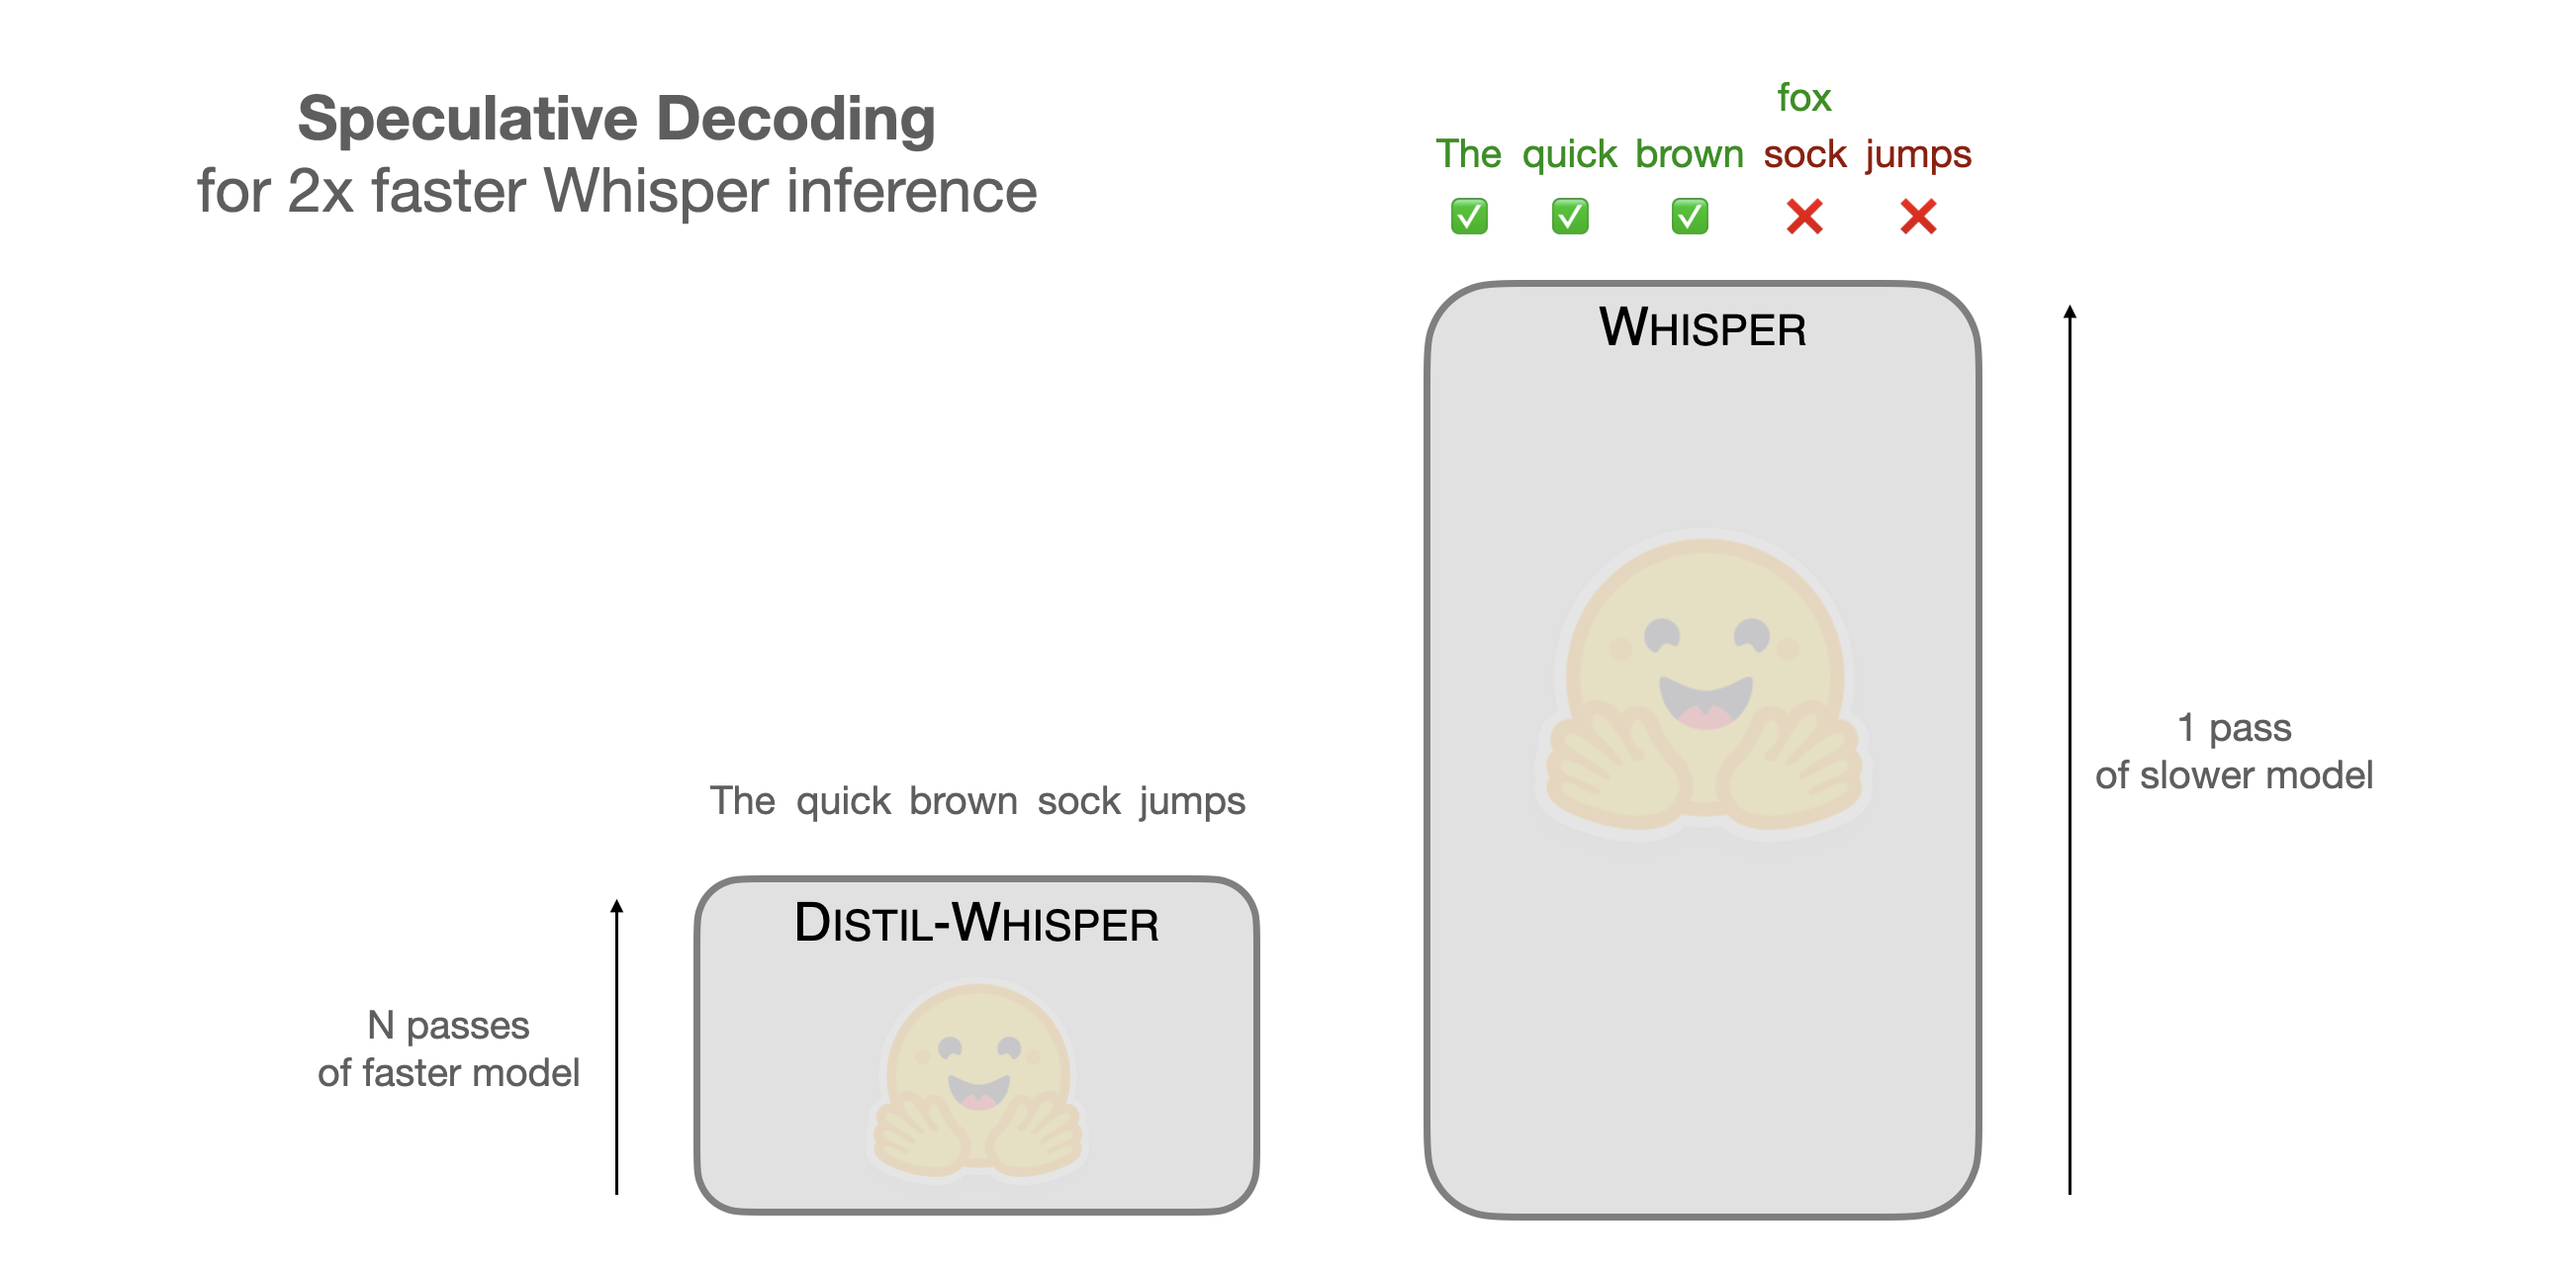
دو برابر سرعت ورایشر با Speculative Decoding در پردازش گفتار
استفاده از تکنیک Speculative Decoding در مدل Whisper، سرعت پردازش گفتار را دو برابر میکند و دقت آن را حفظ میدارد؛ یک گام مهم در توسعهٔ هوش مصنوعی
 پژوهش
هوش مصنوعی: ۳۰۰٪ سرعت بالاتر LoRA با راهحل رمسازی در هاجینگ فیس
در این مقاله، نحوهی افزایش سهبرگانهی سرعت پردازش LoRA، بهجای کاهش زمان راهاندازی و مصرف کمتر GPU، شرح داده میشود.
 مدلها
پیشرفت هوش مصنوعی: تلاش برای بهینهسازی ساده SDXL جهت سرعت و حافظه
یادآورترین نکات بهینهسازی ساده SDXL، مدل پیشرفته تولید تصویر هوش مصنوعی، با تأکید بر سرعت، حافظه و کارایی در مقالهٔ تازه ما.
 پژوهش
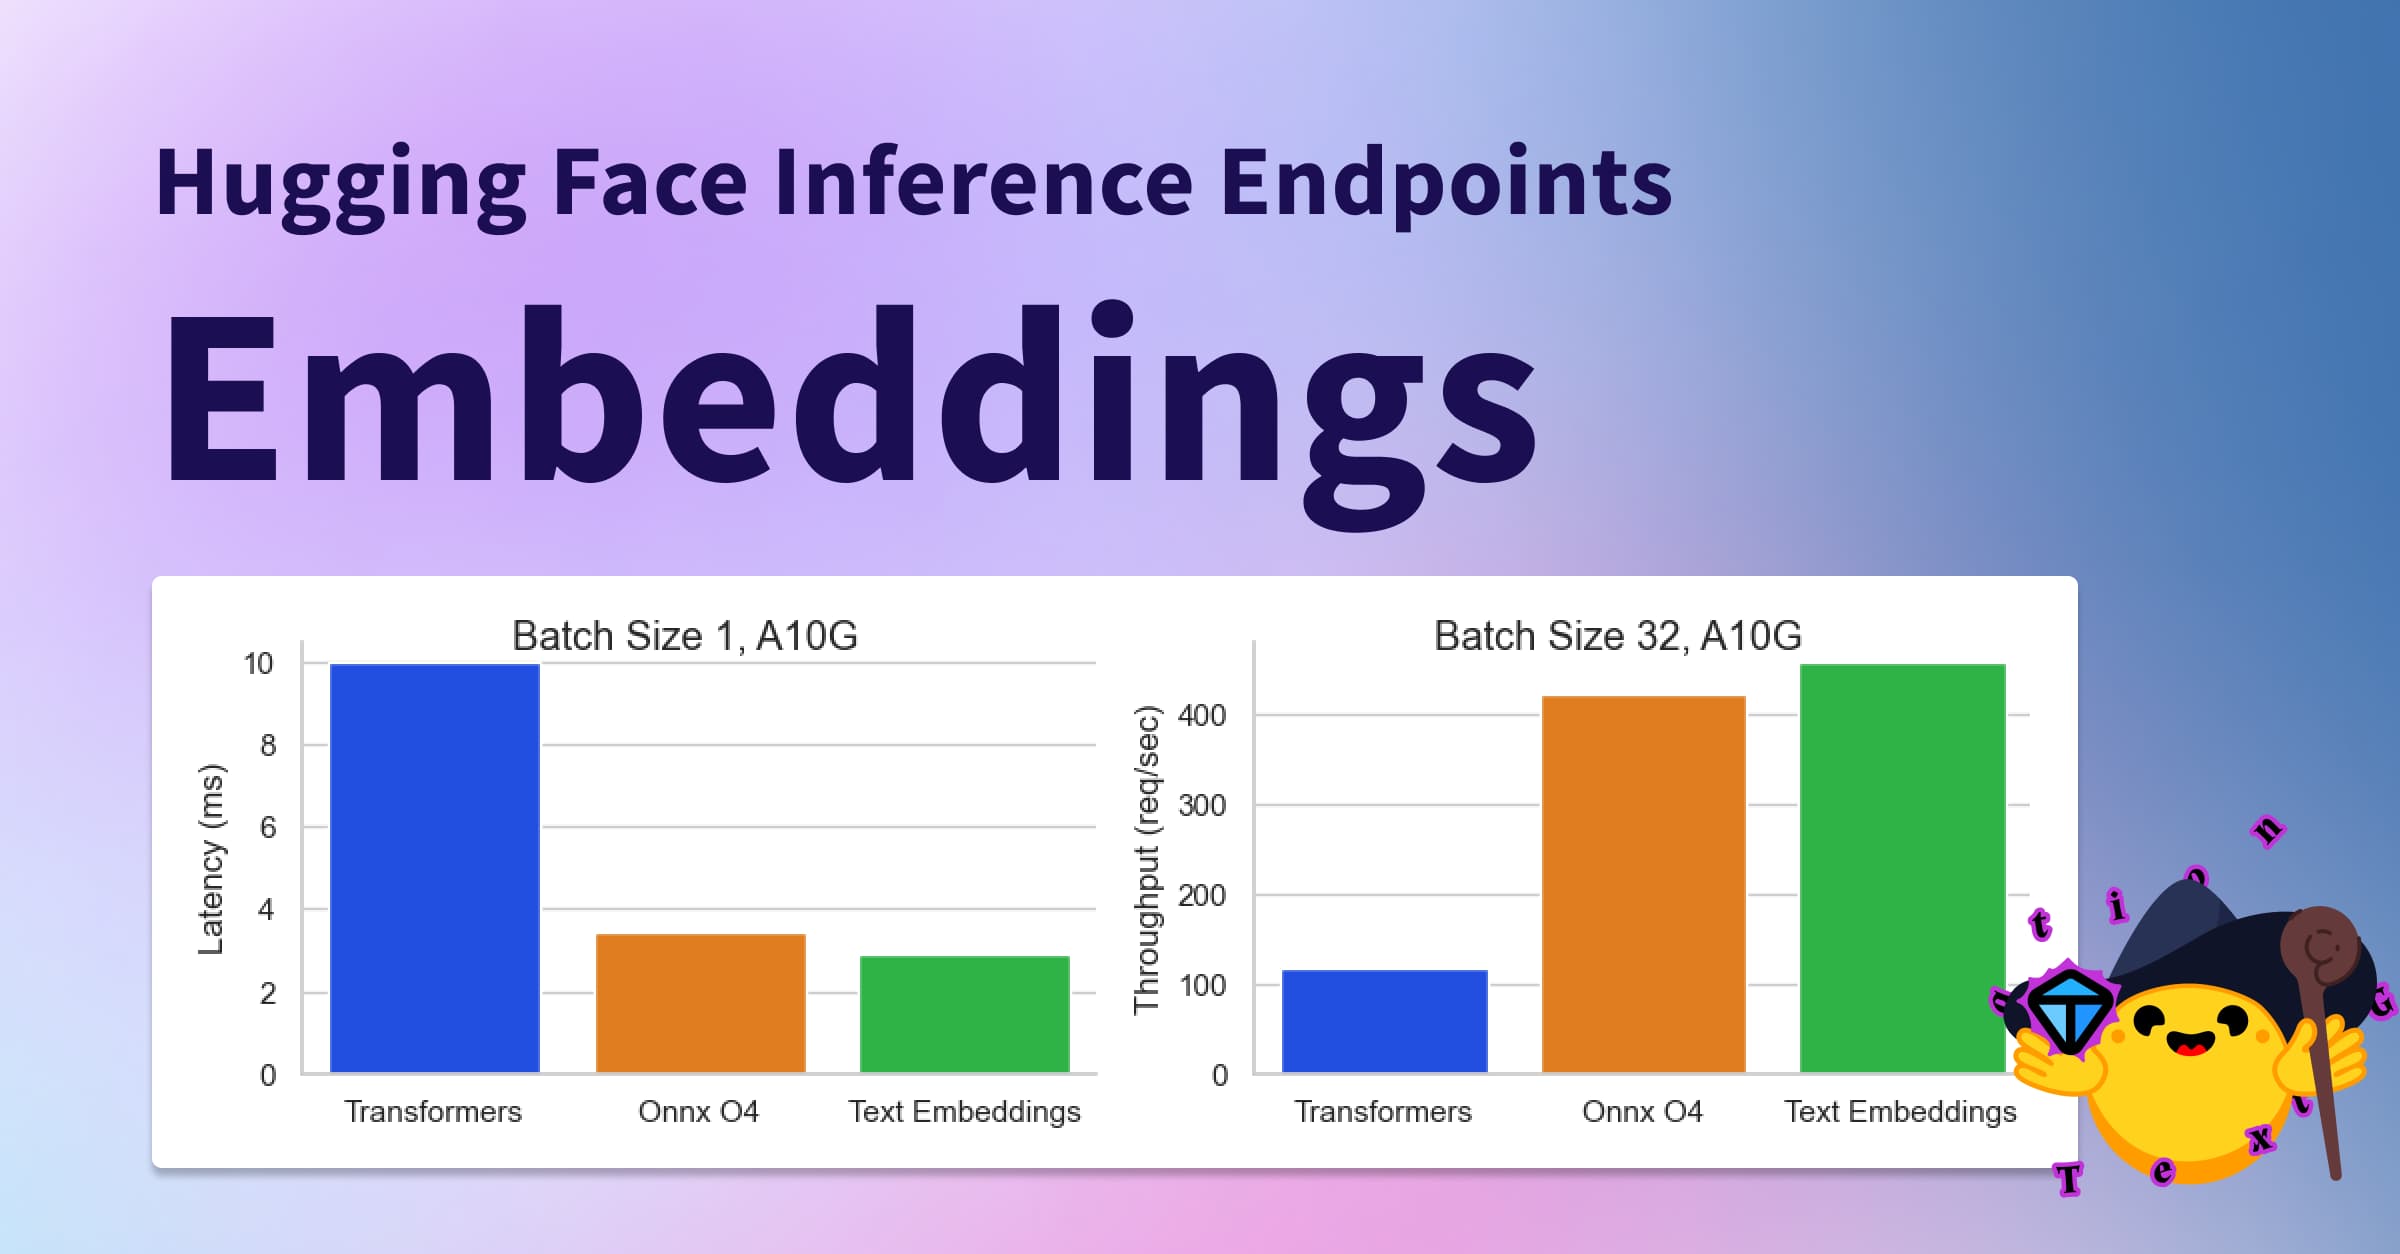
هوش مصنوعی در خدمت دنیای دادهها: انتشار مدلهای ایمبدینگ در Hugging Face
پست جدید هوش مصنوعی در Hugging Face با توضیح گام به گام جهت استقرار مدلهای ایمبدینگ، سرعت پردازش بالاتر و استفاده در تجزیه و تحلیل دادههای متنی و تصویری با مقایسه عملکرد و نکات عملکردی.
 کسبوکار
هوش مصنوعی در مالی: تأثیر، چالش و چشمانداز آینده در صنعت مالی
هوش مصنوعی در صنعت مالی باعث بهبود تصمیمگیری، کاهش ریسک، و سرعت پردازش میشود؛ اما چالشهای داده ناپایدار و نیاز به تخصص مالی مانع پیشرفت است.
 پژوهش
هوش مصنوعی در میلیثانیه: چطور Hugging Face Infinity با CPUهای مدرن زودترین پاسخ را میدهد
مطالعهٔ موردی از سرعت میلیثانیهای مدلهای هوش مصنوعی با استفاده از Hugging Face Infinity و پردازندههای هوشمند. فناوری، عملکرد و راهکارهای جایگزین
 پژوهش
هوش مصنوعی: هستههای GPU بلوک-اسپارس OpenAI، انقلابی در سرعت پردازش
اوپنایآی هستههای بهینهسازی شده GPU بلوک-اسپارس را منتشر کرد. این پیشرفت انقلابی، پردازش شبکههای عصبی را تا چندین برابر سرعت میبخشد و نتایج بینظیری در تحلیل احساسات و مدلسازی مولد به ارمغان میآورد.