
 پژوهش
همراه با هوش مصنوعی: آموزش فاینتوینس پیشرفته Stable Diffusion با DDPO و TRL
در این مقاله، نحوهی استفاده از الگوریتم DDPO در فاینتوینس مدلهای Stable Diffusion را با ابزار TRL توضیح میدهیم. کارایی نسبت به سامانههای سنتی نشان داده شده است.
 پژوهش
هوش مصنوعی: خوشگذرینه تخصیص منابع برای fine-tuning Llama 2 70B در پایتورچ
Fine‑tuning مدل Llama‑2 70B را با PyTorch FSDP در هستهٔ هوش مصنوعی هدفگذاری کردهایم. از طریق واریسهای سفارشی، چالشهای سختافزاری و الگوریتمهای تقسیم پارامترها بهصورت دقیق در SLURM، بهحرفهای مدل را آموزش میدهیم.
 مدلها
سکشنسیون تصویر بدون آموزش: CLIPSeg، الگوریتم جدید هوش مصنوعی دریافت
مدل جدید CLIPSeg با رویکرد Zero‑Shot سکشنسیون تصاویر را بدون برچسبگذاری پیشآموزشپذیر میکند؛ در این مقاله از کاربردها، روش پیادهسازی و نکات کلیدی آن میآموزیم.
 پژوهش
SetFit: راهکار هوش مصنوعی کمنمونه بدون prompts، مخصوص تحلیل احساسات
SetFit یک چارچوب هوش مصنوعی کمنمونه بدون prompts است که با تنها 8 نمونه در هر کلاس، دقتی شبیه به RoBERTa Large روی 3k مثال را به دست میدهد.
 پژوهش
هوش مصنوعی: راهنمای عملی Proximal Policy Optimization (PPO) در یادگیری تقویتی
دستورات کامل Proximal Policy Optimization (PPO) را معرفی میکنیم، مزایای آن در یادگیری تقویتی، و نحوه پیادهسازی توسط Hugging Face و منابع متنباز.
 آموزش
هوش مصنوعی در عمل: انتشار مدل Vision Transformer با TensorFlow Serving
در این مطلب به بررسی نحوه انتشار مدلهای بینایی الگوریتم Vision Transformer با استفاده از TensorFlow Serving در پلتفرم Hugging Face میپردازیم و مزایای آن را بررسی میکنیم.
 پژوهش
هوش مصنوعی: گسترش الگوریتم گریدینت سیاست با PyTorch بر روی پلتفرم Hugging Face
در این مقاله به بررسی کاربرد Policy Gradient در PyTorch میپردازیم، این مسیر یادگیری تقویتی را در چارچوب تجاری و متن باز Hugging Face معرفی میکنیم و نکات عملی و کلیدی را برای توسعهگران بیان میکنیم.
 پژوهش
هوش مصنوعی و یادگیری تقویتی: DQN برای بازی Space Invaders در Hugging Face
در این مطلب، بهدست آوردن بازی مبدل پرش در Space Invaders با استفاده از الگوریتم Deep Q‑Learning (DQN) پرداخته شده و نحوه پیادهسازی در Hugging Face توضیح داده میشود.
 پژوهش
TAPEX: پیشآموزشی هوشمند بر روی جدولها بدون داده واقعی
تشریح دستاویزی TAPEX که در آن پیشآموزش مدلهای هوش مصنوعی بر روی جدولها بدون نیاز به داده واقعی انجام میشود، نشان میدهد ویرایش الگوریتمی مبتنی بر اصول منحصر به فرد توانمندی در پاسخ به سوالات پایگاهداده را بهطور قابلملاحظه تقویت میکند.
 آموزش
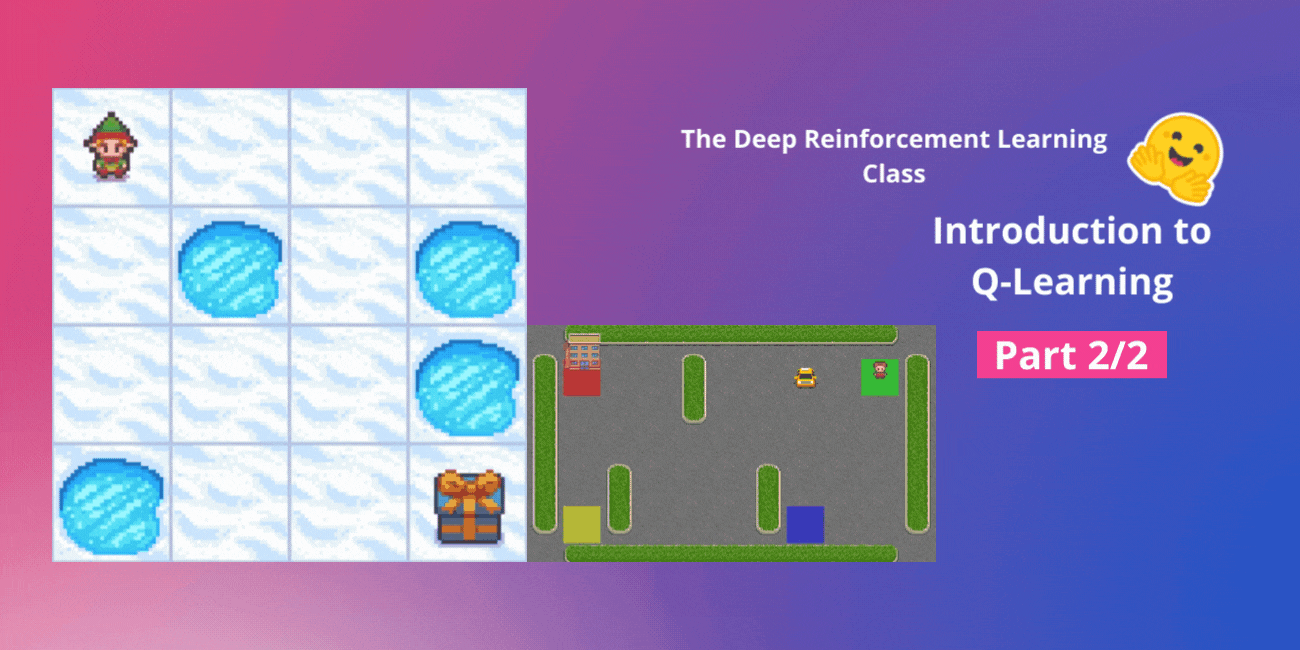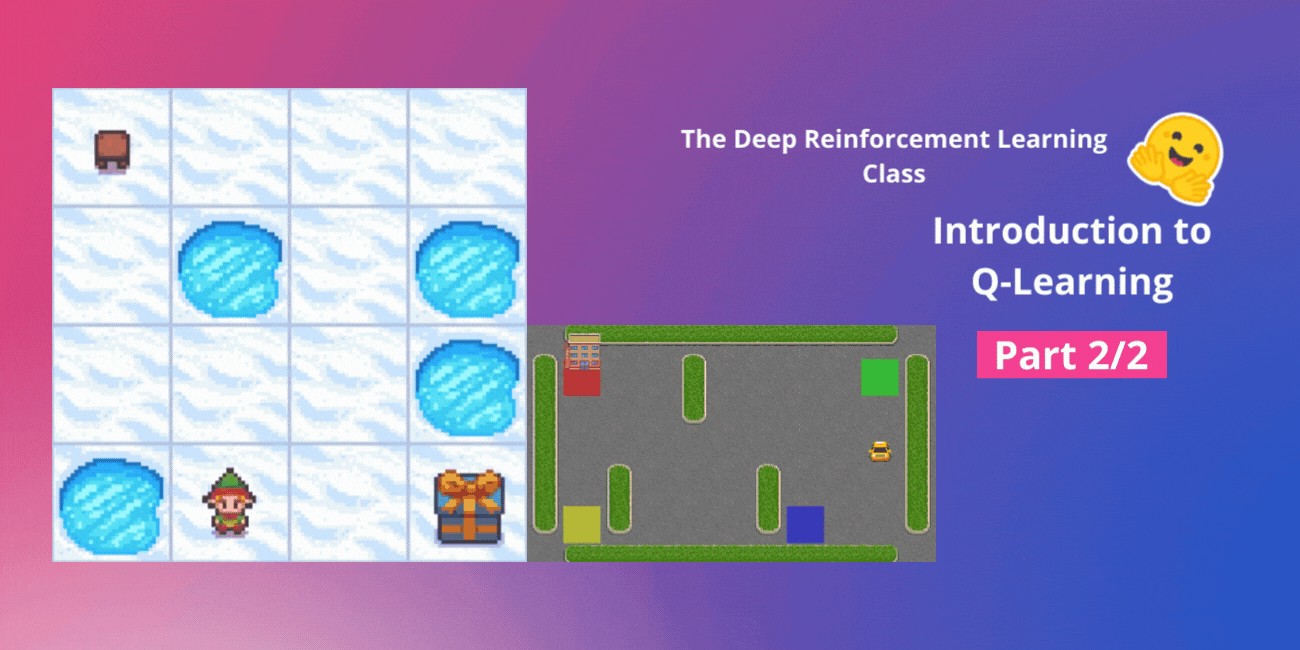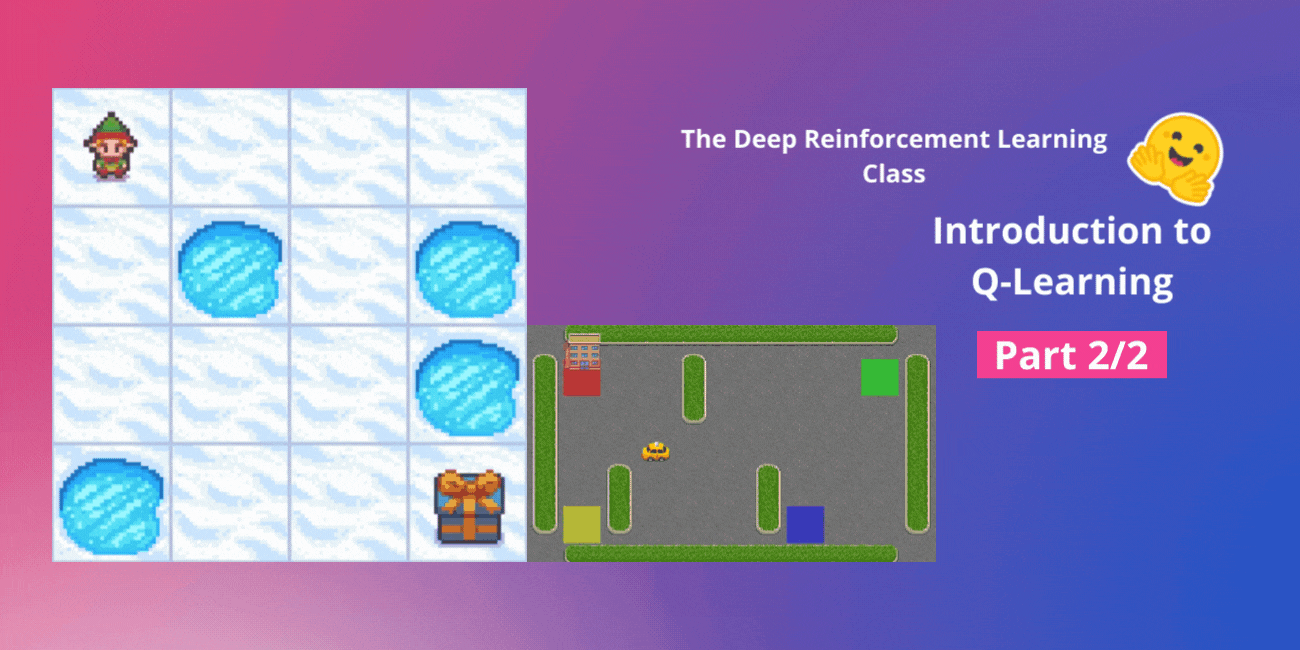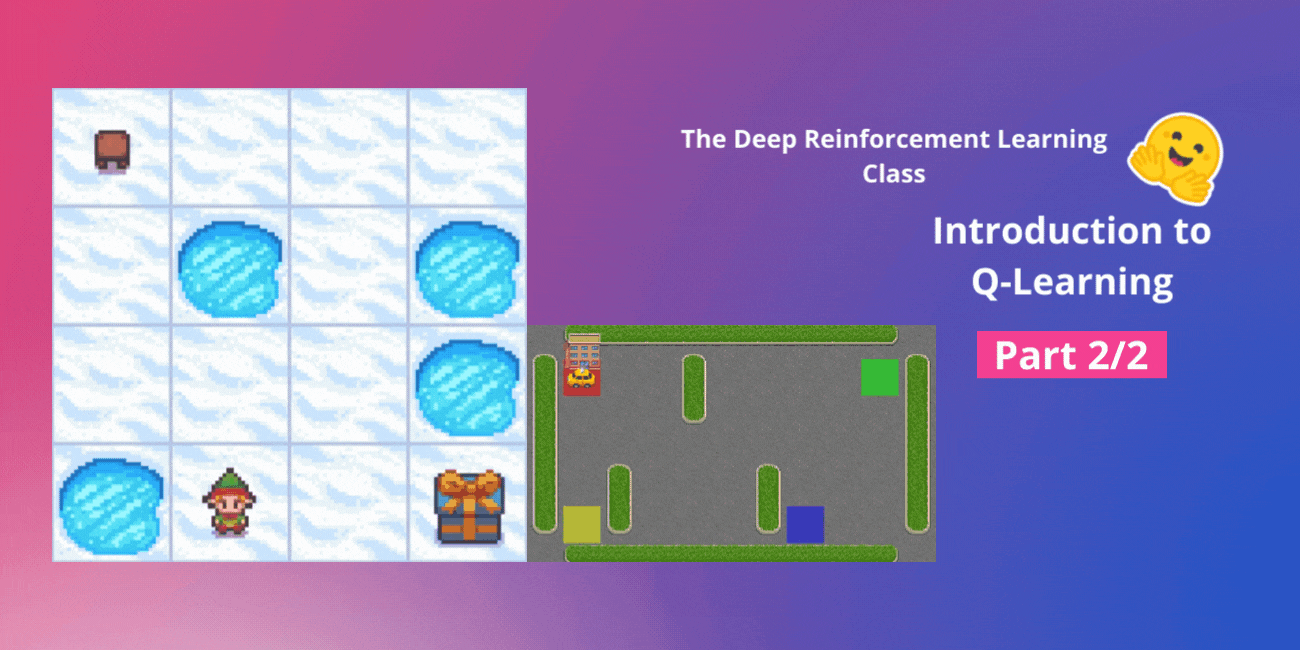
کلاس عملی Q‑لرننج در هوش مصنوعی: مراحل، مثال و مفاهیم کلیدی
آموزش جامع Q‑لرننج، یکی از الگوریتمهای قدرتمند یادگیری تقویتی در هوش مصنوعی؛ با توضیح نکات کلیدی، تفاوتهای سیاستهای on‑policy و off‑policy، و یک مثال واقعی.