معرفی CLIPSeg
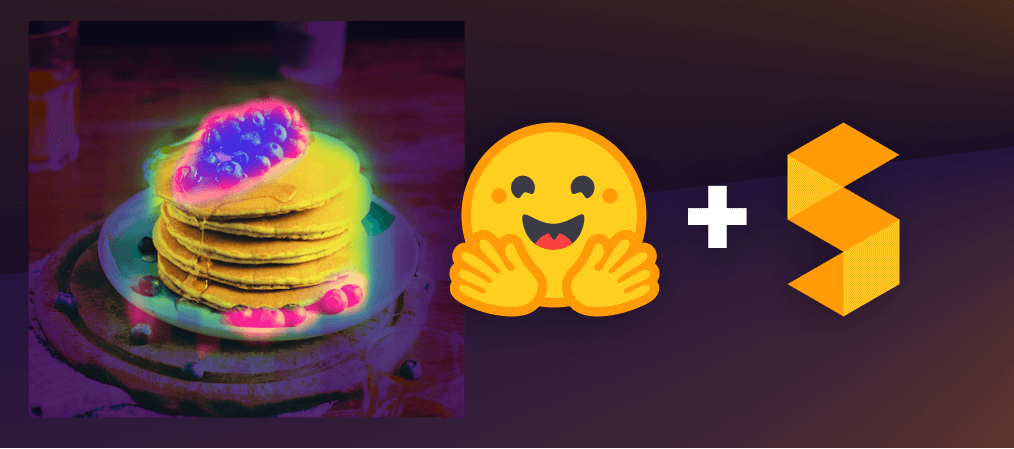
CLIPSeg مدلی مبتنی بر معماری CLIP است که قادر به برش سرعتپذیر تصاویر بدون نیاز به برچسبگذاری هوش مصنوعی تولید شده، با توجه به متونی که توصیف میکند، عمل میکند. این ابزار در کتابخانهٔ Transformers و HuggingFace در دسترس میباشد.
عملکرد Zero‑Shot در سکشنسیون تصویر
یک مدل Zero‑Shot میتواند بر اساس نمونهای از متن یا تصویر، مناطق مشابه را در تصویر مورد نظر شناسایی کند. CLIPSeg از این ویژگی برای استخراج نقشههای ماسکگذاری (mask) استفاده میکند که در زمینههای رباتیک، خودران و ترمیم تصاویر کاربرد دارد.
کاربردهای عملی و ترکیب با ابزارهای دیگر
در پروژههای پیشپردازش تصاویر میتوان از CLIPSeg برای پیشبرچسبگذاری (pre‑labeling) استفاده نمود. همچنین با Segments.ai امکان بهبود دقت ماسکسازی و ترمیم تصویر در چند مرحله وجود دارد.
- استفاده آسان در HuggingFace Transformers
- پشتیبانی از توصیف متنی و بصری
- توسعهپذیری بالا و امکان سفارشیسازی کدهای پایتون
در مجموع CLIPSeg ترکیبی است از هوش مصنوعی پیشرفته و رابط کاربری ساده که توسط جامعهٔ فلوکتور بازآویزان میشود و دسترسی آن به عنوان یک سرویس موسسهای در HuggingFace Enterprise ممکن است.
پرسشهای پرتکرار
CLIPSeg چیست و چه کاربردی دارد؟
CLIPSeg یک مدل سکشنسیون تصویر بدون آموزش است که بر اساس مدل CLIP عمل میکند، به کمک توصیف متنی یا بصری، نقشههای ماسکگذاری را تولید میکند. کاربردش در رباتیک، تلفنهای هوشمند، ترمیم تصویر و تحلیل سرنخهای بصری است.
آیا CLIPSeg نیاز به برچسبگذاری پیش از آموزش دارد؟
خیر؛ به عنوان مدل Zero‑Shot، CLIPSeg نیازی به برچسبهای آموزشی ندارد و میتواند با توجه به توضیحات واقعی، تصویر را برش دهد. این ویژگی آن را برای پروژههای سریع و بدون داده برچسبشده، بسیار مناسب میکند.