مقدمه به Q‑لرننج
Q‑لرننج به عنوان یکی از بنیادیترین الگوریتمهای یادگیری تقویتی، به سیستمهای هوش مصنوعی امکان میدهد تا از تجربهی خود برای بهبود تصمیمگیری در محیطهای پویا بهرهمند شوند. برخلاف روشهای نظارتشده، در این الگوریتم عامل اقداماتی را امتحان میکند و بر اساس پاداش دریافتی، برآوردهای مقدارهای Q را بهروزرسانی میکند.
مقایسه on‑policy و off‑policy
در یادگیری on‑policy، عامل با همان سیاستی که در حال پیشبینی یا بهروزرسانی مقادیر Q استفاده میکند، قدمهای خود را برمیدارد. در حالی که در حالت off‑policy، عامل میتواند از دادههای جمعآوریشده توسط سیاست متفاوت، برای بهروزرسانی Q استفاده کند. این ویژگی در Q‑لرننج وجود دارد که به آن اجازه میدهد از دادههای تجربی جمعآوریشده توسط هر سیاست، بهره ببرد.
مثال عملی Q‑لرننج
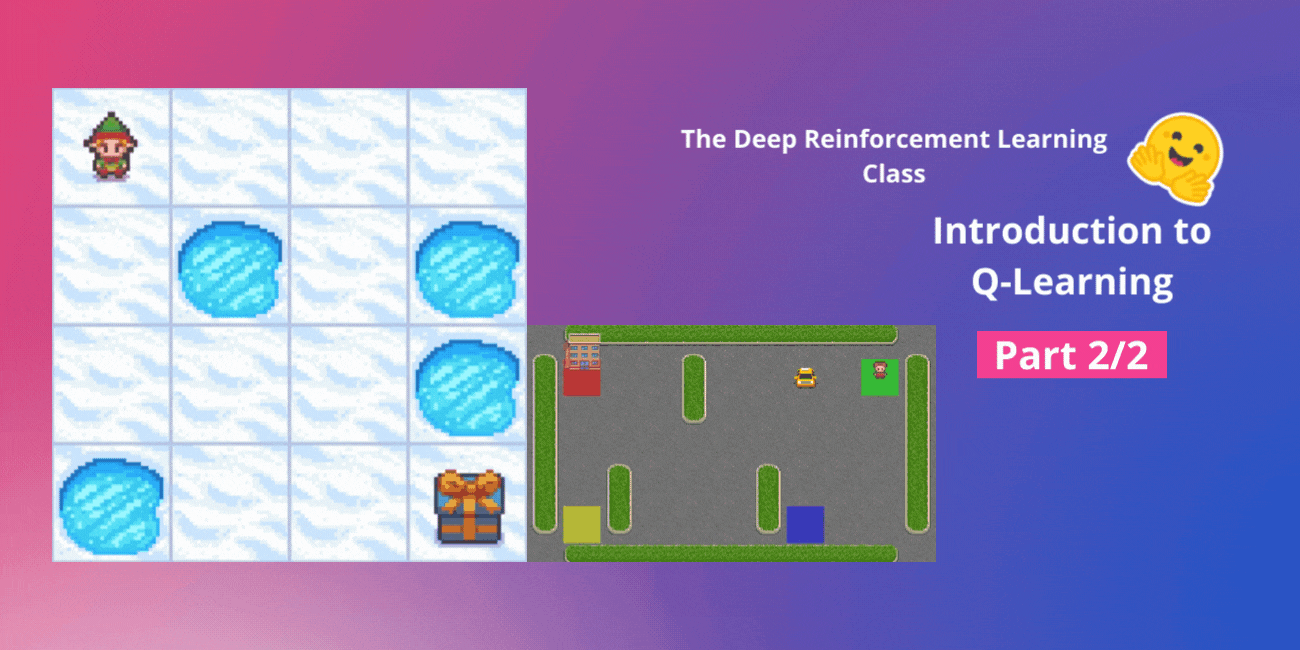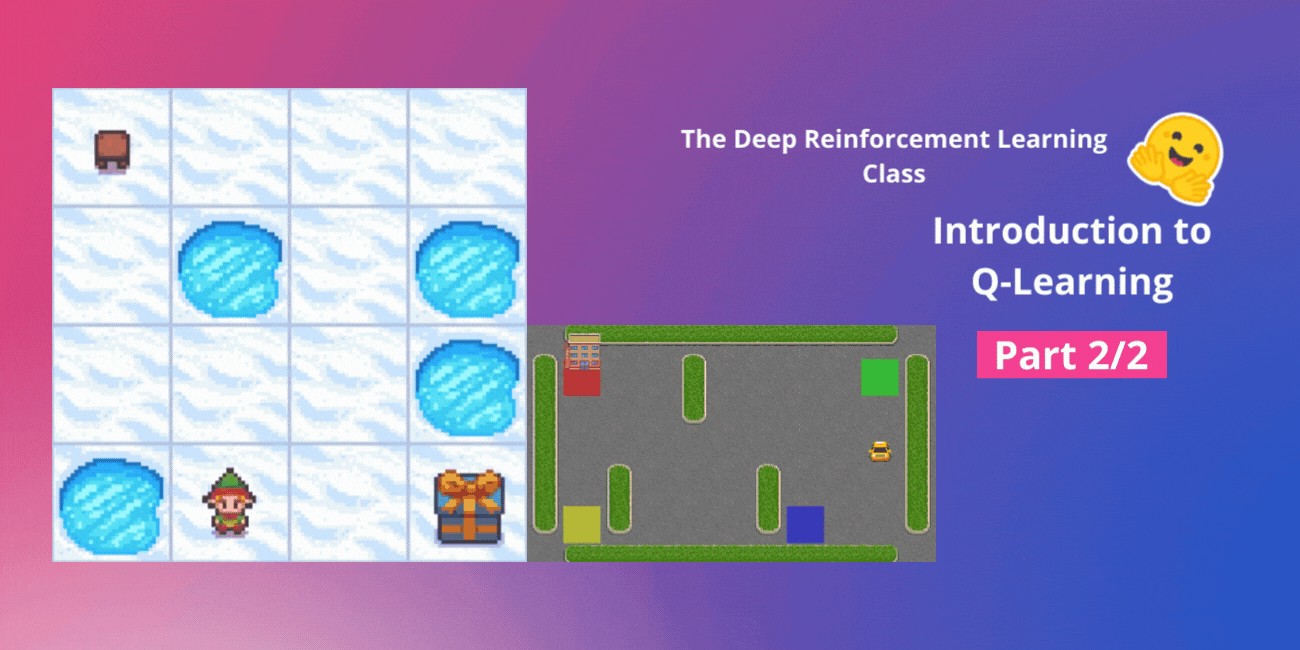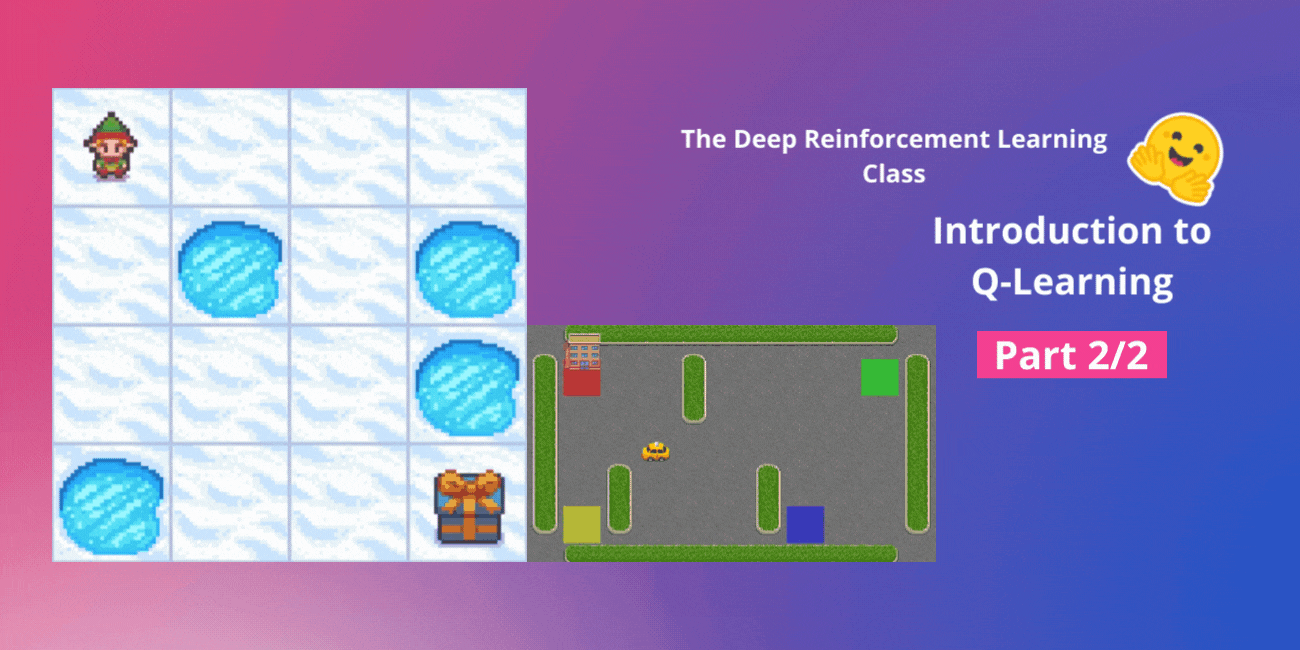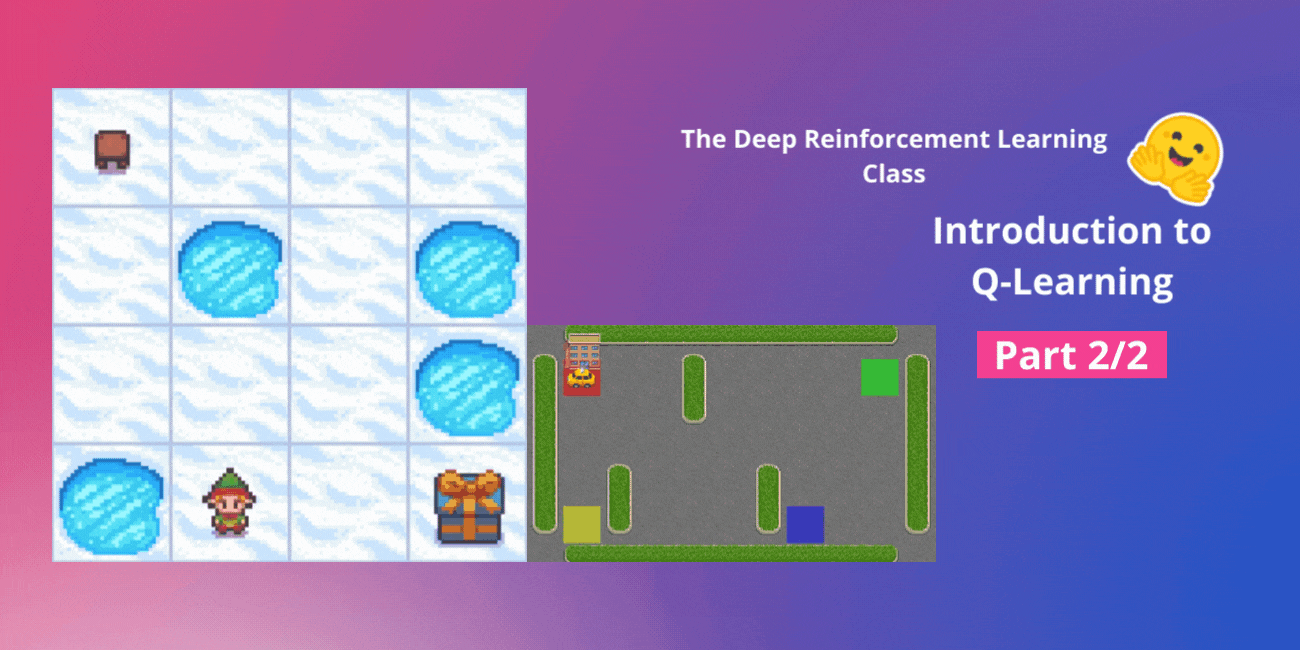
برای توضیح عملی، فرض کنید یک روبات قصد دارد در یک محیط مشکی-سفید، هدف را پیدا کند. با استفاده از Q‑لرننج، روبات در هر کاندیدا، احتمال تبدیل یک وضعیت به وضعیت دیگر و حاصل پاداش ممکن را تخمین میزند. این مقدار، از طریق حلقهٔ بازخوردی که مبنی بر پاداش واقعی میباشد، بهروز میشود. بهطور خلاصه، مراحل این الگوریتم عبارتند از:
- انتخاب عملک بهصورت تصادفی یا بر اساس سیاست ε‑greedy
- اجرای عملک و مشاهده وضعیت جدید و پاداش
- بهروزرسانی مقدار Q برای وضعیت‑عملک قبلی بر اساس معادلهٔ Bellman
- تکرار روند تا همگرایی مقدارهای Q
در نهایت، الگوریتم موبا بهصورت مستقل و بدون نیاز به مدل محیط، اقدام به یادگیری مسیر بهینه میکند.
پرسشهای پرتکرار
ق‑لرننج چیست؟
ق‑لرننج یک الگوریتم یادگیری تقویتی است که بهصورت off‑policy عمل میکند و بهوسیلهٔ بهروزرسانی مقادیر Q، به عامل کمک میکند تا بهترین تصمیمگیری را در هر وضعیت بدست آورد.
ق‑لرننج چگونه در پروژههای واقعی میتواند به کار رود؟
در پروژههای واقعی، ق‑لرننج میتواند برای بهینهسازی مسیرپیمایی روباتها، طراحی بازیهای یادگیری، یا بهینهسازی کدهای نرمافزاری بهصورت آفلاین یا آنلاین استفاده شود. با یک حلقهٔ جمعآوری داده و بهروزرسانی مستمر، سیستم میتواند رفتار آنی و موثر بهتری داشته باشد.