
 پژوهش
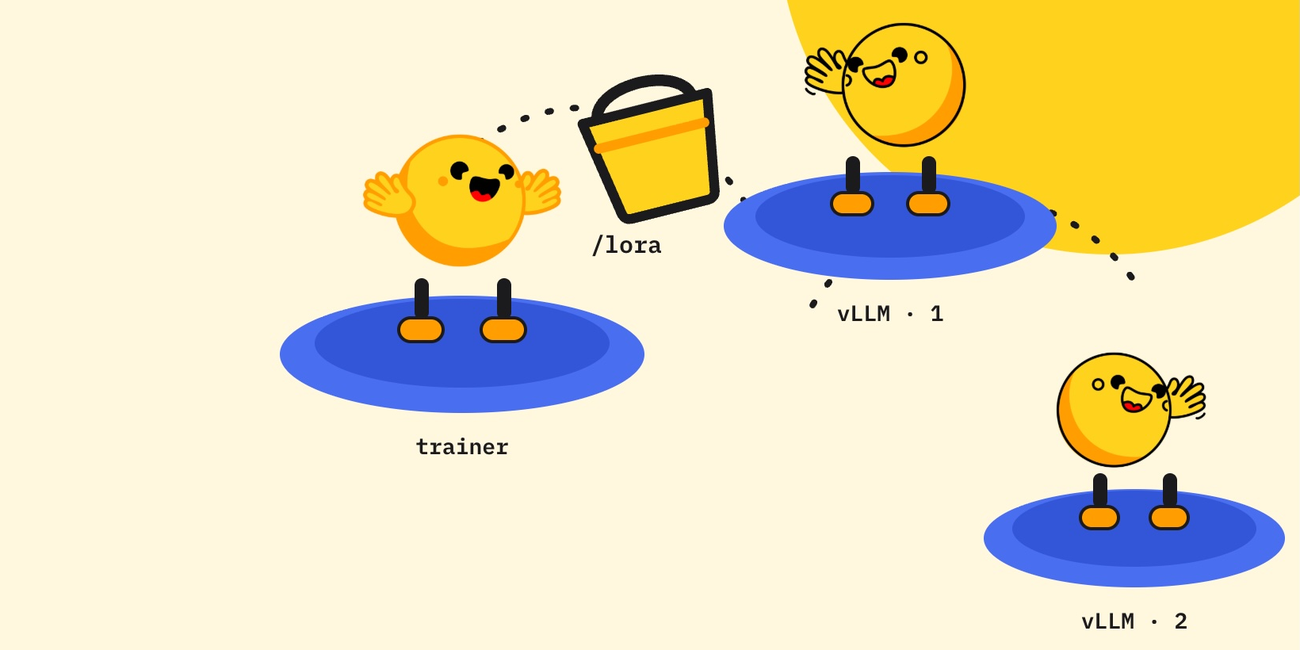
آموزش ناهمزمان GRPO با LoRA؛ گامی نو در هوش مصنوعی متنباز
TRL v1.14 با پشتیبانی LoRA در AsyncGRPOTrainer، آموزش و استنتاج را از هم جدا میکند. مقاله به بررسی معماری سهلایه و استفاده از Storage Buckets میپردازد.
 اخبار
سرعت بومی vLLM با کتابخانه Transformers در اکوسیستم هوش مصنوعی
Hugging Face اعلام کرد بکاند transformers در vLLM به سرعت بومی یا حتی بالاتر از پیادهسازیهای اختصاصی رسیده و توسعهدهندگان مدلهای زبانی میتوانند بدون هزینه اضافه، استنتاج فوقسریع داشته باشند.
 اخبار
راهاندازی سرور vLLM روی Hugging Face Jobs فقط با یک دستور
هگینگفیس قابلیت جدیدی ارائه داده که با یک دستور ساده میتوانید سرور vLLM سازگار با OpenAI را روی زیرساخت ابری آنها راهاندازی کنید؛ بدون نیاز به کوبرنتیز و با پرداخت به ازای ثانیه استفاده.
 پژوهش
هوش مصنوعی vLLM: مهاجرت از V0 به V1 با تمرکز بر صحت قبل از اصلاحات
مقاله جدید ServiceNow-AI در هافنگ فیچ، جزئیات migration vLLM V0 به V1 را بررسی میکند؛ چگونگی اصلاح پیکربندیهای backend برای بهبود دقت RL و کاهش انحراف در لودپروبها.
 پژوهش
هوش مصنوعی بدون GPU: چگونگی افزایش کارایی با vLLM هممحور در TRL
این مقاله روش Co‑Located vLLM در TRL را معرفی و نشان میدهد چگونه با استفاده از GPUهای مشترک، کارایی مدلهای LLM را بدون هزینه اضافی به حداکثر میرساند.
 پژوهش
معرفی پشتیبانی چند-پشتیبان (TRT-LLM، vLLM) برای استنتاج تولید متن
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.